实验二:用python实现SVM支持向量机并对鸢尾花数据集分类
实验二:SVM支持向量机
1. 实验内容:
(1)用你熟知的语言(尽量使用python)实现支持向量机的算法,并在给定的数据集上训练。
(2)在测试集上用训练好的支持向量机进行测试,并将预测结果以csv格式保存为一行预测的分类。
(3)简要说明算法原理,记录实验过程的关键步骤,以及实验过程中遇到的问题和解决方法。
2. 实验说明:
数据集为鸢尾花数据集,有三个类别,其中setosa与另外两种之间是线性可分的,因此你需要选择按照setosa和versicolor,或setsosa和virginica,进行训练分类。如果你用的是软间隔可以用两个SVM对全部三类进行测试。
实验过程中可以不可以直接调用第三方库封装好的训练函数,但可以使用基础类和函数,例如numpy的数组以及矩阵内积dot函数等(算法迭代过程必须自己完成)。
算法具体实现方式无要求,函数或是类封装均可,但是要写进实验报告内。不必上交代码,但要有实验过程关键步骤的截图。
可以尝试利用可视化分析实验过程(非必须)。
3. 报告要求:
实验必须独立完成不得抄袭借鉴他人的实验内容。
4. 原理说明:
简要说明感知器算法原理,可以借助伪代码来进行说明。
4.1 文字描述:
支持向量机(SVM)是一种二分类模型,它的基本模型是定义在特征空间上的间隔最大的线性分类器,即在分类面扩展为一个具有间隔的空间,可以看成是感知机的升级版;另外SVM还包括核方法,从而使它成为非线性分类器。
SVM的学习策略就是间隔最大化,因此相比于感知机,它有唯一的解,可以形式化为一个求解凸二次规划的问题,也等价于正则化的合页损失函数的最小化问题,整体来看是一个求解凸函数的最优化问题。
4.2 数学抽象:
4.2.1 硬间隔支持向量机
给定线性可分的训练数据集 D = { ( x ( 1 ) , y ( 1 ) ) , ( x ( 2 ) , y ( 2 ) ) , … … , ( x ( N ) , y ( N ) ) } D = \{(\mathbf x^{(1)},y^{(1)}),(\mathbf x^{(2)},y^{(2)}),……,(\mathbf x^{(N)},y^{(N)})\} D={(x(1),y(1)),(x(2),y(2)),……,(x(N),y(N))} ,其中 ( x ( n ) , y ( n ) ) (\mathbf x^{(n)}, y^{(n)}) (x(n),y(n)) 为第 n n n个样本, x ( n ) ∈ R D \mathbf x^{(n)} \in \mathbb R^D x(n)∈RD 为该样本的特征向量。
对于给定的训练数据集
D
D
D和超平面
(
w
,
b
)
(\mathbf w,b)
(w,b),任一样本
x
(
n
)
\mathbf x^{(n)}
x(n) 到超平面
(
w
,
b
)
(\mathbf w,b)
(w,b)的距离是
r
(
n
)
=
∣
w
T
x
(
n
)
+
b
∣
∥
w
∥
r^{(n)}=\frac {|\mathbf {w^T x^{(n)}}+b|}{\|\mathbf w\|}
r(n)=∥w∥∣wTx(n)+b∣
一般来说,一个点距离超平面的远近可以表示分类预测的确信程度。在超平面
w
T
x
(
n
)
+
b
=
0
\mathbf {w^T x^{(n)}}+b=0
wTx(n)+b=0 确定的情况下,
∣
w
T
x
(
n
)
+
b
∣
|\mathbf {w^T x^{(n)}}+b|
∣wTx(n)+b∣ 能够相对地表示点
x
(
n
)
\mathbf x^{(n)}
x(n) 距离超平面的远近,而
w
T
x
(
n
)
+
b
\mathbf {w^T x^{(n)}}+b
wTx(n)+b 的符号与类标记
y
(
n
)
y^{(n)}
y(n) 的符号是否一致能够表示分类是否正确。在这个阶段之前,与感知机部分的推导是一致的。为了计算方便,我们将类标记设置为
{
−
1
,
+
1
}
\{-1,+1\}
{−1,+1} ,因此,可以使用
y
(
n
)
(
w
T
x
(
n
)
+
b
)
y^{(n)} (\mathbf {w^T x^{(n)}}+b)
y(n)(wTx(n)+b) 表示分类的正确性及确信程度。当所有样本被正确分类时,
r
(
n
)
r^{(n)}
r(n) 可以写为
r
(
n
)
=
∣
w
T
x
(
n
)
+
b
∣
∥
w
∥
=
y
(
n
)
(
w
T
x
(
n
)
+
b
)
∥
w
∥
r^{(n)}=\frac {|\mathbf {w^T x^{(n)}}+b|}{\|\mathbf w\|}=\frac {y^{(n)} (\mathbf {w^T x^{(n)}}+b)}{\|\mathbf w\|}
r(n)=∥w∥∣wTx(n)+b∣=∥w∥y(n)(wTx(n)+b)
假设超平面能将训练样本正确分类,即对于
(
x
(
n
)
,
y
(
n
)
)
∈
D
(\mathbf x^{(n)}, y^{(n)}) \in D
(x(n),y(n))∈D,若
y
(
n
)
=
+
1
y^{(n)}=+1
y(n)=+1,则有
w
T
x
(
n
)
+
b
>
0
\mathbf {w^T x^{(n)}}+b \gt 0
wTx(n)+b>0;若
y
(
n
)
=
−
1
y^{(n)}=-1
y(n)=−1,则有
w
T
x
(
n
)
+
b
<
0
\mathbf {w^T x^{(n)}}+b \lt 0
wTx(n)+b<0 ,令
w
T
x
(
n
)
+
b
≥
0
,
y
(
n
)
=
+
1
;
w
T
x
(
n
)
+
b
≤
0
,
y
(
n
)
=
−
1
;
\mathbf {w^T x^{(n)}}+b \ge 0,y^{(n)}=+1;\\ \mathbf {w^T x^{(n)}}+b \le 0,y^{(n)}=-1;
wTx(n)+b≥0,y(n)=+1;wTx(n)+b≤0,y(n)=−1;
在线性可分的情况下,距离超平面最近的训练样本会使等号成立,被称为支持向量。即
y
(
n
)
(
w
T
x
(
n
)
+
b
)
−
1
=
0
y^{(n)}(\mathbf {w^T x^{(n)}}+b)-1=0
y(n)(wTx(n)+b)−1=0
对于正样本(
y
(
n
)
=
+
1
y^{(n)}=+1
y(n)=+1),支持向量在超平面
H
1
H_1
H1 上。
H
1
:
w
T
x
(
n
)
+
b
=
+
1
H_1:\mathbf {w^T x^{(n)}}+b=+1
H1:wTx(n)+b=+1
对于负样本(
y
(
n
)
=
−
1
y^{(n)}=-1
y(n)=−1),支持向量在超平面
H
2
H_2
H2 上。
H
2
:
w
T
x
(
n
)
+
b
=
−
1
H_2:\mathbf {w^T x^{(n)}}+b=-1
H2:wTx(n)+b=−1
***通俗解释:***类似于感知机的方法,找到二分类的超平面,并对超平面增加常数项,具体体现为超平面的平移。对于正例与负例,平移方向相反,距离相同,使新的边界成为正(负)例的下(上)界。
根据上述公式推导
H
1
H_1
H1 和
H
2
H_2
H2 是平行的,并且两超平面之间是”真空区域“(没有样本点)。这一条”真空区域“可以用两个不同类的支持向量到超平面的距离之和表示,称为间隔,即真空长带的宽度,可以用公式表示为:
γ
=
2
∥
w
∥
\gamma=\frac {2}{\|\mathbf w\|}
γ=∥w∥2
支持向量机的基本想法是求解能够正确划分训练数据集并使间隔最大的超平面。因此,它相对于感知机而言是有唯一解的(间隔最大化)。这里的间隔最大化又称为硬间隔最大化(”真·真空“)。
4.2.2 问题转换
将上述推导表示为带约束的最优化问题:
m
a
x
w
,
b
2
∥
w
∥
s
.
t
.
y
(
n
)
(
w
T
x
(
n
)
+
b
)
∥
w
∥
≥
γ
2
,
n
=
1
,
2
,
…
,
N
max_{w,b}\frac {2}{\|w\|}\\ s.t.\frac {y^{(n)}(\mathbf {w^T x^{(n)}}+b)}{\|w\|}\ge \frac {\gamma}{2},n=1,2,…,N
maxw,b∥w∥2s.t.∥w∥y(n)(wTx(n)+b)≥2γ,n=1,2,…,N
又由于
γ
=
2
∥
w
∥
\gamma=\frac {2}{\|\mathbf w\|}
γ=∥w∥2,因此,上式可以写为:
m
a
x
w
,
b
2
∥
w
∥
s
.
t
.
y
(
n
)
(
w
T
x
(
n
)
+
b
)
≥
1
,
n
=
1
,
2
,
…
,
N
max_{w,b}\frac {2}{\|w\|}\\ s.t.\ \ \ \ {y^{(n)}(\mathbf {w^T x^{(n)}}+b)}\ge 1,n=1,2,…,N
maxw,b∥w∥2s.t. y(n)(wTx(n)+b)≥1,n=1,2,…,N
为了后续公式推导更加简便,我们可以将约束条件
m
a
x
w
,
b
2
∥
w
∥
max_{w,b}\frac {2}{\|w\|}
maxw,b∥w∥2 等价为
m
i
n
w
,
b
1
2
∥
w
∥
2
min_{w,b}\frac {1}{2}{\|w\|^2}
minw,b21∥w∥2 ,如此以来可以得到如下的最优化问题(并方便求导):
m
i
n
w
,
b
1
2
∥
w
∥
2
s
.
t
.
y
(
n
)
(
w
T
x
(
n
)
+
b
)
≥
1
,
n
=
1
,
2
,
…
,
N
min_{w,b}\frac {1}{2}{\|w\|^2}\\ s.t.\ \ \ \ {y^{(n)}(\mathbf {w^T x^{(n)}}+b)}\ge 1,n=1,2,…,N
minw,b21∥w∥2s.t. y(n)(wTx(n)+b)≥1,n=1,2,…,N
这是一个凸二次规划问题,给定线性可分训练数据集,通过间隔最大化可以求出约束最优化问题的解
(
w
∗
)
T
x
+
b
∗
=
0
(\mathbf w^*)^T \mathbf x+b^*=0
(w∗)Tx+b∗=0
并得到分类决策函数
f
(
x
)
=
s
i
g
n
(
(
w
∗
)
T
x
+
b
∗
)
f(\mathbf x) = sign((\mathbf w^*)^T \mathbf x +b^*)
f(x)=sign((w∗)Tx+b∗)
称为线性可分支持向量机。
4.2.3 对偶算法
对上述的不等式约束的凸二次规划问题,我们可以引入拉格朗日乘子法得到其对偶问题,这样做的好处:
- 对偶问题往往更容易求解
- 自然的引入核函数,从而推广到非线性分类问题
首先对每一个不等式约束引入拉格朗日乘子
α
i
,
α
i
≥
0
,
i
=
1
,
2
,
…
,
N
\alpha_i,\alpha_i \ge 0,i=1,2,…,N
αi,αi≥0,i=1,2,…,N,构造拉格朗日函数:
L
(
w
,
b
,
α
)
=
1
2
∥
w
∥
2
+
∑
n
=
1
N
α
(
n
)
(
1
−
y
(
n
)
(
w
T
x
(
n
)
+
b
)
)
L(\mathbf w,b, \mathbf \alpha)=\frac {1}{2} \|\mathbf w\|^2+\sum_{n=1}^{N}\alpha^{(n)}(1-y^{(n)}(\mathbf {w^T x^{(n)}}+b))
L(w,b,α)=21∥w∥2+n=1∑Nα(n)(1−y(n)(wTx(n)+b))
展开更加清晰:
L
(
w
,
b
,
α
)
=
1
2
∥
w
∥
2
−
∑
n
=
1
N
α
(
n
)
y
(
n
)
(
w
T
x
(
n
)
+
b
)
+
∑
n
=
1
N
α
i
L(\mathbf w,b, \mathbf \alpha)=\frac {1}{2} \|\mathbf w\|^2-\sum_{n=1}^{N}\alpha^{(n)}y^{(n)}(\mathbf {w^T x^{(n)}}+b)+\sum_{n=1}^{N}\alpha_i
L(w,b,α)=21∥w∥2−n=1∑Nα(n)y(n)(wTx(n)+b)+n=1∑Nαi
依据拉格朗日对偶性,原始问题的对偶问题是极大极小问题:
max
α
min
w
,
b
L
(
w
,
b
,
α
)
\max_{\alpha}\min_{\mathbf w,b}L(\mathbf w,b,\mathbf \alpha)
αmaxw,bminL(w,b,α)
问题阐述推导过程可以参考机器学习——支持向量机SVM - 希望每天涨粉 - 博客园 (cnblogs.com)
4.2.4 步骤
- 求 min w , b L ( w , b , α ) \min_{\mathbf w,b}L(\mathbf w, b, \mathbf \alpha) minw,bL(w,b,α)
分别对拉格朗日函数中的
w
,
b
\mathbf w,b
w,b 求偏导,并求出偏导数为0时对应的值:
KaTeX parse error: Undefined control sequence: \part at position 40: …athbf \alpha)}{\̲p̲a̲r̲t̲ ̲\mathbf w} =\ma…
即
w
=
∑
n
=
1
N
α
(
n
)
y
(
n
)
x
(
n
)
∑
n
=
1
N
α
(
n
)
y
(
n
)
=
0
\mathbf w = \sum_{n=1}^{N}\alpha^{(n)}y^{(n)}\mathbf x^{(n)} \\ \sum_{n=1}^{N}\alpha^{(n)}y^{(n)}=0
w=n=1∑Nα(n)y(n)x(n)n=1∑Nα(n)y(n)=0
带入拉了朗日函数并化简得:
L
(
w
,
b
,
α
)
=
∑
n
=
1
N
α
(
n
)
−
1
2
∑
n
=
1
N
∑
j
=
1
N
α
(
n
)
α
(
j
)
y
(
n
)
y
(
j
)
(
(
x
(
n
)
)
T
x
(
j
)
)
L(\mathbf w,b,\mathbf \alpha)=\sum_{n=1}^{N}\alpha^{(n)}-\frac {1}{2}\sum_{n=1}^{N}\sum_{j=1}^{N}\alpha^{(n)}\alpha^{(j)}y^{(n)}y^{(j)}((\mathbf x^{(n)})^T\mathbf x^{(j)})
L(w,b,α)=n=1∑Nα(n)−21n=1∑Nj=1∑Nα(n)α(j)y(n)y(j)((x(n))Tx(j))
- 求 α \alpha α 求极大:
max α ∑ n = 1 N α ( n ) − 1 2 ∑ n = 1 N ∑ j = 1 N α ( n ) α ( j ) y ( n ) y ( j ) ( ( x ( n ) ) T x ( j ) ) s . t . ∑ n = 1 N α ( n ) y ( n ) = 0 , α ( n ) ≥ 0 , n = 1 , 2 , … , N \max_\alpha\sum_{n=1}^{N}\alpha^{(n)}-\frac {1}{2}\sum_{n=1}^{N}\sum_{j=1}^{N}\alpha^{(n)}\alpha^{(j)}y^{(n)}y^{(j)}((\mathbf x^{(n)})^T\mathbf x^{(j)}) \\ s.t.\ \ \sum_{n=1}^{N}\alpha^{(n)}y^{(n)}=0,\alpha^{(n)}\ge0,n=1,2,…,N αmaxn=1∑Nα(n)−21n=1∑Nj=1∑Nα(n)α(j)y(n)y(j)((x(n))Tx(j))s.t. n=1∑Nα(n)y(n)=0,α(n)≥0,n=1,2,…,N
对于这个二次规划问题,它的规模会正比于训练样本数 N N N,当样本数很大时,会产生巨大的开销,针对问题的特性,有许多高效的算法,其中序列最小化(SMO)是经典的算法,它大致的思想是先固定 α ( n ) \alpha^{(n)} α(n) 以外的参数,然后对 α ( n ) \alpha^{(n)} α(n) 求极值,在约束 ∑ n = 1 N α ( n ) y ( n ) = 0 , α ( n ) ≥ 0 , n = 1 , 2 , … , N \sum_{n=1}^{N}\alpha^{(n)}y^{(n)}=0,\alpha^{(n)}\ge0,n=1,2,…,N ∑n=1Nα(n)y(n)=0,α(n)≥0,n=1,2,…,N 之下, α ( n ) \alpha^{(n)} α(n) 可以由其他变量导出,这样,在参数初始化后,不断迭代,可以最终达到收敛。公式推导请参考以下文章:
SMO算法的具体解释可以参考:支持向量机原理(四)SMO算法原理 - 刘建平Pinard - 博客园 (cnblogs.com)
- 最终结果:
最后,我们可以得到一个
α
j
∗
>
0
\alpha^*_j \gt 0
αj∗>0 的最优解
w
∗
w^*
w∗ 和
b
∗
b^*
b∗:
w
∗
=
∑
n
=
1
N
(
α
(
n
)
)
∗
y
(
n
)
x
(
n
)
b
∗
=
y
(
j
)
−
∑
n
=
1
N
(
α
(
n
)
)
∗
y
(
n
)
(
(
x
(
n
)
)
T
x
(
j
)
)
w^* = \sum_{n=1}^{N}(\alpha^{(n)})^*y^{(n)}\mathbf x^{(n)} \\ b^*=y^{(j)}-\sum_{n=1}^{N}(\alpha^{(n)})^*y^{(n)}((\mathbf x^{(n)})^T \mathbf x^{(j)})
w∗=n=1∑N(α(n))∗y(n)x(n)b∗=y(j)−n=1∑N(α(n))∗y(n)((x(n))Tx(j))
整理得到超平面的公式为:
∑
n
=
1
N
(
α
(
n
)
)
∗
y
(
n
)
(
x
T
x
(
n
)
)
+
b
∗
=
0
\sum_{n=1}^{N}(\alpha^{(n)})^*y^{(n)}(\mathbf x^T \mathbf x^{(n)})+b^*=0
n=1∑N(α(n))∗y(n)(xTx(n))+b∗=0
分类决策函数为:
f
(
x
)
=
s
i
g
n
(
∑
n
=
1
N
(
α
(
n
)
)
∗
y
(
n
)
(
x
T
x
(
n
)
)
+
b
∗
)
f(x)=sign(\sum_{n=1}^{N}(\alpha^{(n)})^*y^{(n)}(\mathbf x^T \mathbf x^{(n)})+b^*)
f(x)=sign(n=1∑N(α(n))∗y(n)(xTx(n))+b∗)
PS:这部分的公式推导有一些难度,可以在网上多找一些讲解,结合自己的理解来亲手操作一次。
4.3 几何意义
硬间隔支持向量机寻找的超平面,是使样本点到超平面的距离均大于间隔的二分之一,如此一来不仅实现了分类,还使分类效果有一定的置信度(不同类的样本点离边界越远,说明越分类结果安全)。
4.4 伪代码
**输入:**线性可分的训练数据集 D = { ( x ( 1 ) , y ( 1 ) ) , ( x ( 2 ) , y ( 2 ) ) , … … , ( x ( N ) , y ( N ) ) } D = \{(\mathbf x^{(1)},y^{(1)}),(\mathbf x^{(2)},y^{(2)}),……,(\mathbf x^{(N)},y^{(N)})\} D={(x(1),y(1)),(x(2),y(2)),……,(x(N),y(N))} ,其中 $ \mathbf x^{(n)} \in \mathbb R^D$ , Y ( n ) ∈ { − 1 , + 1 } , n = 1 , 2 , … , N Y^{(n)} \in \{-1,+1\}, n=1,2,…,N Y(n)∈{−1,+1},n=1,2,…,N
1:构造并求解约束最优化问题:
m
i
n
w
,
b
1
2
∥
w
∥
2
s
.
t
.
y
(
n
)
(
w
T
x
(
n
)
+
b
)
≥
1
,
n
=
1
,
2
,
…
,
N
;
min_{w,b}\frac {1}{2}{\|w\|^2}\\ s.t.\ \ \ \ {y^{(n)}(\mathbf {w^T x^{(n)}}+b)}\ge 1,n=1,2,…,N;
minw,b21∥w∥2s.t. y(n)(wTx(n)+b)≥1,n=1,2,…,N;
2:转换为最优化问题:
min
α
1
2
∑
n
=
1
N
∑
j
=
1
N
α
(
n
)
α
(
j
)
y
(
n
)
y
(
j
)
(
(
x
(
n
)
)
T
x
(
j
)
)
−
∑
n
=
1
N
α
(
n
)
s
.
t
.
∑
n
=
1
N
α
(
n
)
y
(
n
)
=
0
α
(
n
)
≥
0
,
n
=
1
,
2
,
…
,
N
;
\min_\alpha \frac {1}{2}\sum_{n=1}^{N}\sum_{j=1}^{N}\alpha^{(n)}\alpha^{(j)}y^{(n)}y^{(j)}((\mathbf x^{(n)})^T\mathbf x^{(j)})-\sum_{n=1}^{N}\alpha^{(n)} \\ s.t.\ \ \sum_{n=1}^{N}\alpha^{(n)}y^{(n)}=0 \\ \alpha^{(n)} \ge 0, n=1,2,…,N;
αmin21n=1∑Nj=1∑Nα(n)α(j)y(n)y(j)((x(n))Tx(j))−n=1∑Nα(n)s.t. n=1∑Nα(n)y(n)=0α(n)≥0,n=1,2,…,N;
3:求得最优解
α
∗
=
(
α
1
∗
,
α
2
∗
,
…
,
α
N
∗
)
T
;
\mathbf \alpha^*=(\alpha ^*_1,\alpha ^*_2,…,\alpha ^*_N)^T;
α∗=(α1∗,α2∗,…,αN∗)T;
4:计算 w ∗ = ∑ n = 1 N ( α ( n ) ) ∗ y ( n ) x ( n ) ; \mathbf w^*=\sum_{n=1}^{N}(\alpha^{(n)})^*y^{(n)}\mathbf x^{(n)}; w∗=∑n=1N(α(n))∗y(n)x(n);
5:选择 α ∗ \alpha^* α∗ 的一个正分量 ( α ( j ) ) ∗ > 0 ; (\alpha ^{(j)})^* \gt 0; (α(j))∗>0;
6:计算 b ∗ = y ( j ) − ∑ n = 1 N ( α ( n ) ) ∗ y ( n ) ( ( x ( n ) ) T x ( j ) ) ; b^* = y^{(j)}-\sum_{n=1}^{N}(\alpha^{(n)})^*y^{(n)}((\mathbf x^{(n)})^T \mathbf x^{(j)}); b∗=y(j)−∑n=1N(α(n))∗y(n)((x(n))Tx(j));
7:得到超平面:
(
w
∗
)
T
x
+
b
∗
=
0
(\mathbf w^*)^T \mathbf x + b^* = 0
(w∗)Tx+b∗=0
分类决策函数:
f
(
x
)
=
s
i
g
n
(
(
w
∗
)
T
x
+
b
∗
)
;
f(\mathbf x) = sign((\mathbf w^*)^T \mathbf x + b^*);
f(x)=sign((w∗)Tx+b∗);
**输出:**最大间隔超平面和分类决策函数
5. 实验过程:
简要说明实验步骤,重点说明关键步骤,对结果进行分析。
5.1 算法构建
5.1.1 读取数据
def load_training_set(file):
    data_set = []
    data_label = []
    with open(file) as f:
        for line in f.readlines():
            line = line.strip().split(',')
            for i in range(len(line) - 1):
                line[i] = float(line[i])
            data_set.append(line[0:4])

            # 为方便计算,将'setosa'记为1,'versicolor'和'virginica'记为-1
            if line[-1] == 'setosa':
                data_label.append(1)
            else:
                data_label.append(-1)

    data = np.array(data_set)
    label = np.array(data_label)

    return data, label


def load_test_set(testFile, targetsFile):
    data_set = []
    data_label = []
    with open(testFile) as testfile:
        for line in testfile.readlines():
            line = line.strip().split(',')
            for i in range(len(line)):
                line[i] = float(line[i])
            data_set.append(line[0:4])

    with open(targetsFile) as targetsfile:
        for line in targetsfile.readlines():
            line = line.strip().split(',')
            if line[-1] == 'setosa':
                data_label.append(1)
            else:
                data_label.append(-1)

    data = np.array(data_set)
    label = np.array(data_label)

    return data, label


def create_train_test(trainFile, testFile, targetsFile):
    X_train, y_train = load_training_set(trainFile)
    X_test, y_test = load_test_set(testFile, targetsFile)
    return X_train, y_train, X_test, y_test
5.1.2 构建核函数
def linear_kernel(x1, x2):
    return np.dot(x1, x2)
使用最初的线性函数,后期可以转换为高斯核
5.1.3 构建SVM类
5.1.4 硬间隔支持向量机参数的训练
def RandomLinear(trainFile, testFile, targetsFile):
    X_train, y_train, X_test, y_test = create_train_test(trainFile, testFile, targetsFile)
    clf = mySVM()
    clf.fit(X_train, y_train)

    y_predict = clf.predict(X_test)
    correct = np.sum(y_predict == y_test)
    print("%d 个测试样本中有%dg个预测正确" % (len(y_predict), correct))
    clf.plot(X_train[y_train == 1], X_train[y_train == -1])
5.1.5 指定惩罚系数的软支持向量机参数的训练
5.2 结果
5.2.1 硬间隔分类结果
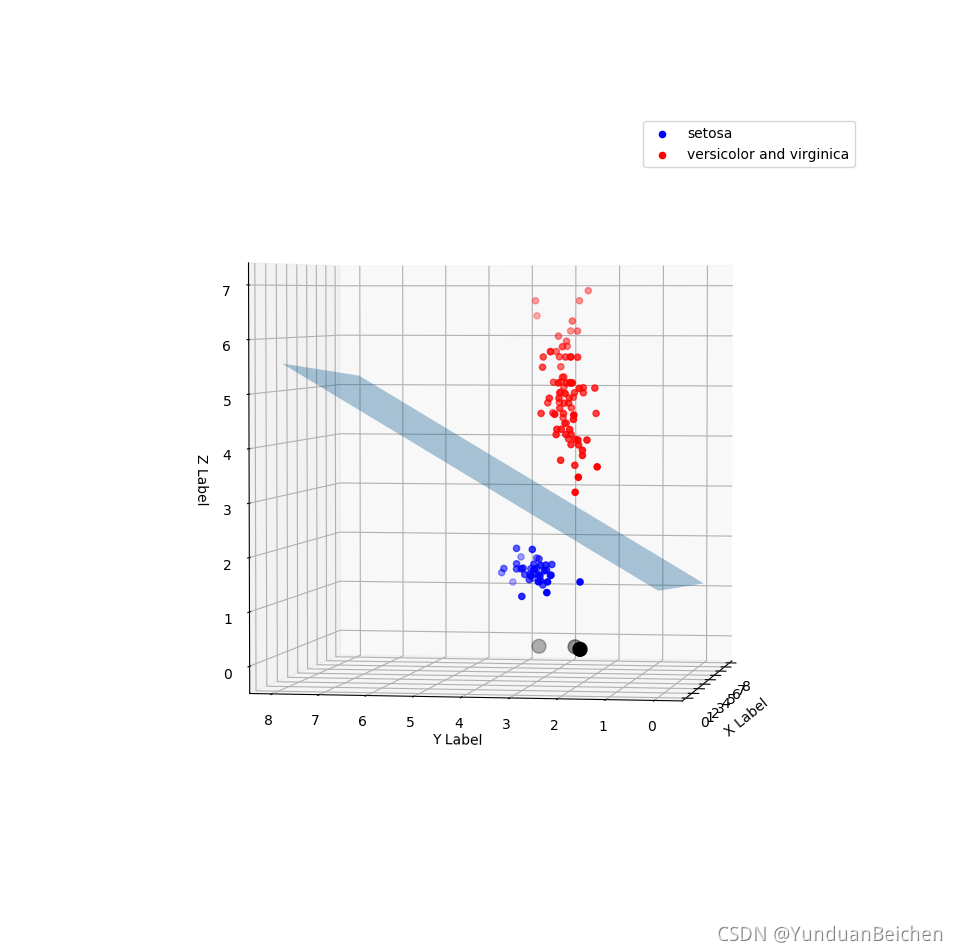
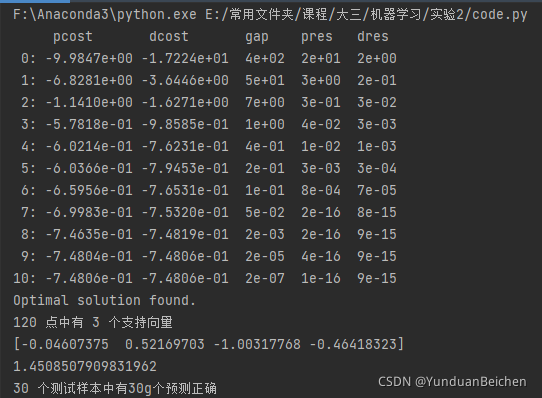
5.2.2 软间隔指定惩罚系数分类结果
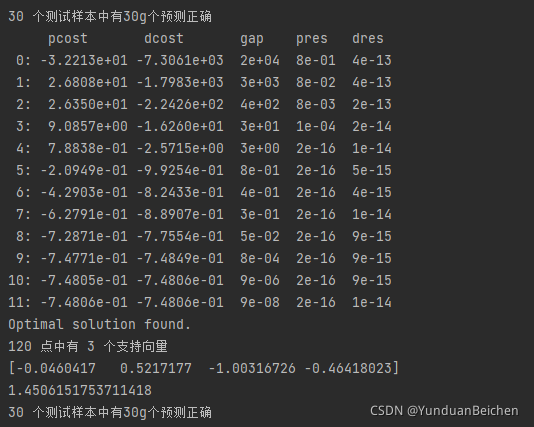
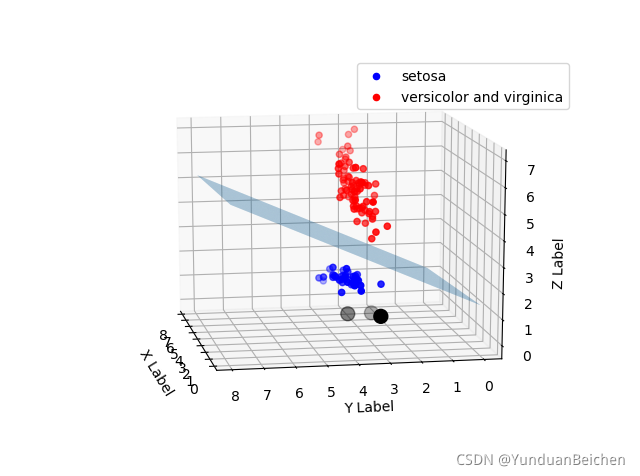
PS:由于给定的数据集完全线性可分,使用五折交叉验证来求得最好的C后放入SVM软间隔支持向量机后,效果不明显(C从0.001到1000均可完成分类),所以没有贴结果。
6. 实验问题:
描述实验过程中遇到的问题,以及对应解决办法。
首先是支持向量机算法的理解,在最优化过程中,使用的序列最小化等方法,有点看不懂,后来通过上网查询并手写例题找到了一些灵感,但是代码实现的过程中又出现了问题——与给定输入运算得到结果不同,无从下手,随后在网络上找到相应的模块cvxopt——凸规划,进而实现了支持向量机的算法。
期间也有cvxopt安装问题,导入问题,均通过科学上网解决。
最后是支持向量机的实现,参考了csdn等各网站的多种实现形式,在模仿中加入自己的思考,实现了代码的复现,收获颇丰。
中间部分的代码建议参考另外两篇博文(自己写的太渣了,如果不嫌弃可以私信)
https://blog.csdn.net/Fate_mt/article/details/105763052
https://www.jianshu.com/p/49ee3894589f

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)