有网也不一定走云端:HarmonyOS AI 问答怎么切?
26年5月,Nameo 的 AI 问答出过一个挺怪的问题:问题发出去了,页面也出现了 AI 气泡,但里面一个字都没有。
我对这件事还有印象,不过当时先查了什么已经有点记不清了。后来重新翻 Git,才把原因对上。服务端当时没有返回正常 token,而是通过 SSE 发回了一帧错误:
data: {"error":"DeepSeek API error: 401"}
旧代码只认识 choices[0].delta.content。正常 token 来了,它就往气泡里追加;上面这种 error 帧来了,它既不展示,也不抛异常,最后还把这次流式请求当成正常结束。
这就有点尴尬了。页面为了做流式效果,发送问题后会先插入一条空的 assistant 消息;云端没吐出 token,这条消息自然还是空的。更麻烦的是,上层根本不知道云端失败了,原本准备好的端侧 fallback 也没机会执行。
上一篇《任务明明完成了,PM2轮询为什么随机404?》处理的是多进程状态放错地方以后,任务明明完成了却随机 404。这一篇继续往客户端走:云端已经把错误返回来了,为什么路由还是以为它成功了?
先让失败真的失败
所以当时先没动布局,直接去修流式请求
- SSE 里出现
error,直接 reject; - 25 秒还没拿到首个 token,按超时处理;
- 流结束了却一个 token 都没有,按空流处理;
- 最后再守一次,禁止空 assistant 消息落库。
简化以后,关键逻辑差不多是这样:
function handleSse(payload: string) {
  const data = JSON.parse(payload)

  if (data.error) {
    throw new Error(data.error)
  }

  const token = data.choices?.[0]?.delta?.content
  if (token) {
    receivedToken = true
    appendToken(token)
  }
}

if (!receivedToken) {
  throw new Error('AI_EMPTY_STREAM')
}
错误得一路传到真正负责选路的地方。接口返回 HTTP 200,业务不一定成功;SSE 收到 [DONE],中间也可能一个 token 都没产生。错误帧被吞掉以后,cloud → local 写得再漂亮也没用,路由层收到的还是“调用成功”。
手机有网,和云端能回答是两回事
很多端云路由最开始都是这么写的:
if (networkOnline) {
  useCloud()
} else {
  useLocal()
}
我一开始也觉得这很合理。后来真遇到问题才发现,networkOnline 最多说明设备当前有默认网络,或者链路状态看起来还行。后端是否可达、身份和额度是否正常、SSE 能不能吐出首 token,都得等请求真正执行后再判断。
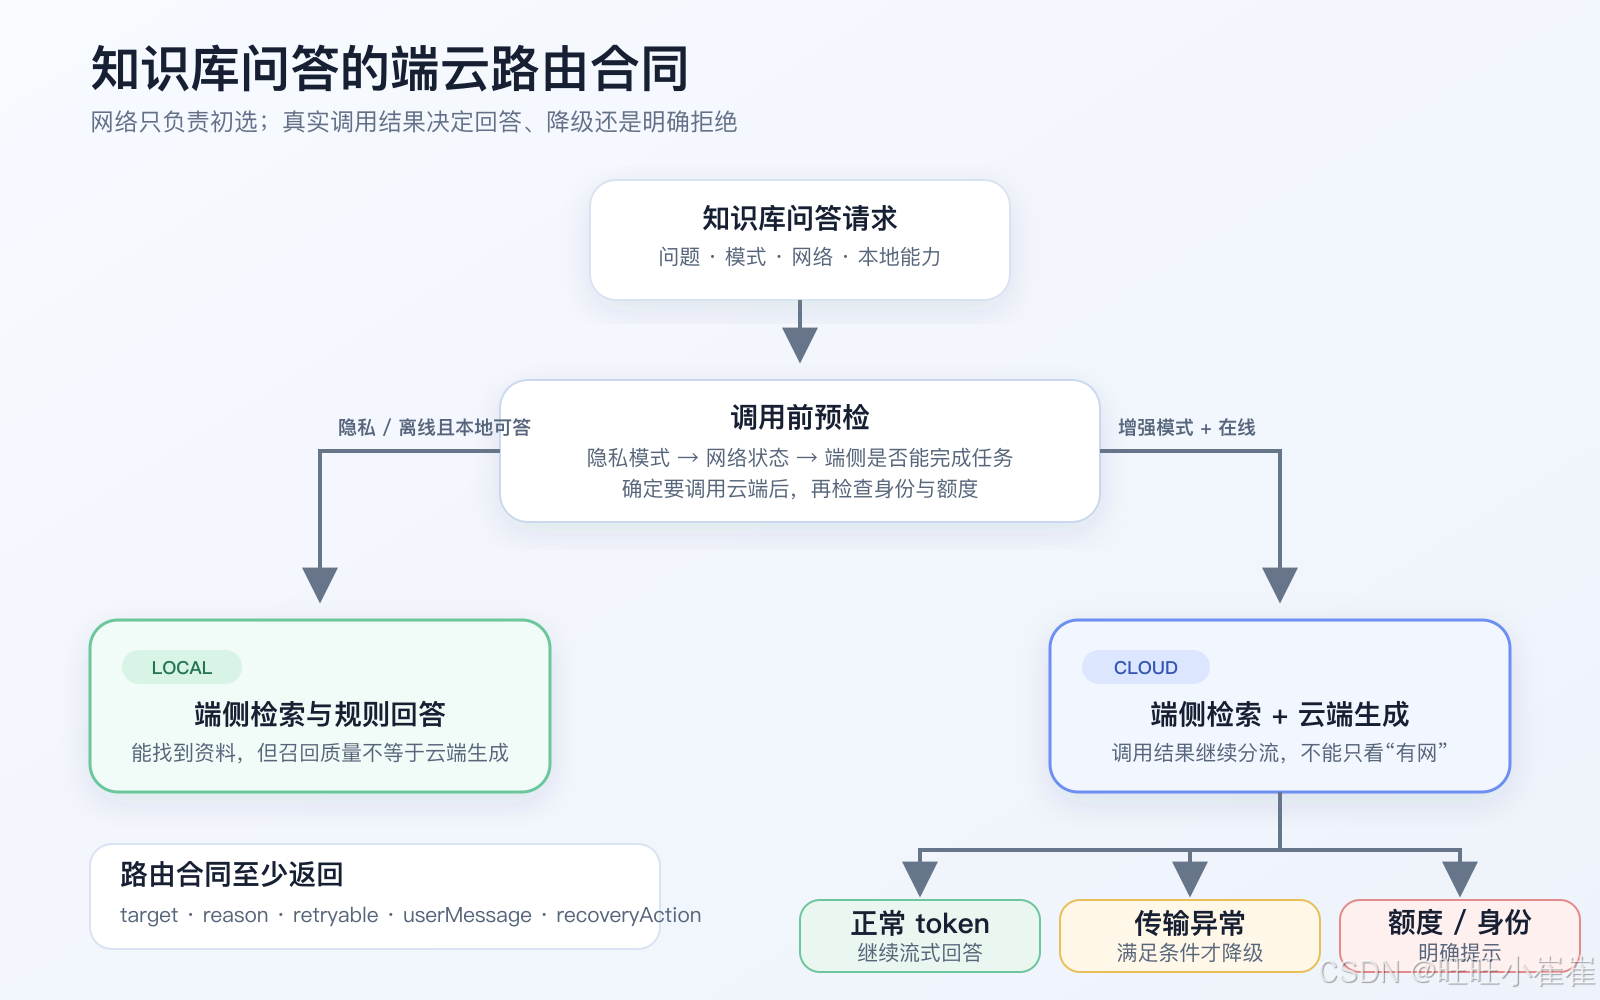
所以 Nameo 把它拆成两层:网络状态负责初选,请求结果负责二次决策。两层揉成一个布尔值,设备有网时可能一直在坏掉的接口上死等;把所有失败都当成“没网”,又会让额度和身份问题偷偷走进 fallback。
正常路径下,顶部会显示实际路由,回答区域也保留知识来源。
端侧能回答,不代表手机里塞了一个大模型
云端异常以后,Nameo 的知识问答可以切到端侧。这里很容易理解成“自动切换本地 AI”,但其实不是,手机里也藏不下大模型。
真实链路没那么玄学:端侧会从本地知识卡片里检索相关内容,通过关键词粗召回和 embedding 混合排序拿到候选资料,再取摘要、正文预览和相关句子,最后组装成一个确定性回答。它擅长的是把设备里已有的资料找出来,不是重新生成一篇逻辑完整的答案。
我实际看过降级后的效果。不能说完全没用,资料确实能找到;但召回多了以后,回答里也会混进其他内容。你问的是 A,它把 A 找到了,顺手又把 B 和 C 端了上来。资料是有了,回答却不够干净。当时我把这些多余内容都叫成“混进了其他 chunk”,重新看代码才发现,这个说法还不够准。
local-only 的回答正文来自候选知识卡片:关键词和 embedding 混合排序后,取前三张卡片的摘要或正文预览,再从最佳卡片抽关键句。正文里混进 B、C,先查候选卡片是否跨文档、前三张为什么被选中。单独展示的引用资料才走 chunk 检索、相邻扩展和上下文截断;如果云端回答被其他内容带偏,再检查最终送给模型的上下文。三种现象看着都像“召回脏了”,排查入口并不一样。
最小日志也得分层留。卡片阶段记录 cardId、关键词分、embedding 相似度、最终分数和是否进入前三;chunk 阶段再记录 chunkIndex、分数、是否由相邻扩展带入,以及最终有没有进入上下文。然后对比“全知识库提问”和“指定单文档提问”,只看最终答案很难判断 B、C 是在哪一层混进来的。
当前已有关键词粗召回和 embedding 混合排序。后面准备尝试的二阶段 reranker,指的是再加一层更严格的筛选,不是把现有相似度排序换个名字。最低相关性门槛也不能随手拍一个数字,我会拿一组真实问题和反例校准,再看召回率与污染率怎样取舍。fallback 先解决有没有结果,召回和重排再解决结果够不够准。
还有一个边界必须说清:已有资料的端侧检索,不等于整个应用从文档导入到问答都能完全断网运行。TXT 这类简单内容可以本地读取,但 PDF、Office 文档以及图片、表格等复杂内容,归一化还有后端解析链路。完全断网时,新文档从哪里来、怎样变成稳定 chunk,本身就是另一个问题。
现阶段更实际的目标,是让端侧把能做的检索、筛选和隐私控制做好。
隐私模式不能只写一个 local
做隐私模式时,我想保护的首先是原始文档。用户放进来的是合同、会议资料或者内部文档,他可能不希望整份文件离开设备。但隐私不能只看问答时走 local 还是 cloud,至少要拆成导入解析、检索和生成三层。
| 环节 | 当前路径 | 能说明什么 | 不能说明什么 |
|---|---|---|---|
| 复杂文档导入 | PDF、Office、图片表格等存在后端归一化 | 解析能力更完整 | 不能说原始文件从未离开设备 |
| 隐私模式问答 | local-only | 问答不调用云端生成 | 不等于文档导入阶段也全在端侧 |
| 增强模式问答 | 端侧检索 + 云端生成 | 云端接收问题与组织后的知识上下文 | 仍需明确哪些上下文会出端 |
| 演进方向 | 用户授权后只发送问题和回答所需的最小上下文 | 原始资料和检索尽量留在端侧 | 仍不是 100% 离线,也要处理云端留存边界 |
当前知识问答进入隐私模式后会直接走 local-only。检索、reranker、推理和回答全部在端侧当然更彻底,但手机的算力、内存和功耗都摆在那儿。更实际的方向,是先限定文档作用域,在设备端检索,只在用户明确允许时发送问题和回答所需的最小上下文;用户拒绝以后,仍然保留能力较弱但可用的端侧回答。
先写路由合同,再写 if/else
当前 ArkTS 实现其实很直接,先读 AppStorage 里的模式,再结合网络状态返回 cloud 或 local:
getCurrentRoute(): AIRoute {
  const aiMode = AppStorage.get<string>('aiMode') ?? 'enhanced'
  if (aiMode === 'privacy') return 'local'
  return this.networkMonitor.isOnline() ? 'cloud' : 'local'
}
云端请求抛错后,路由再把 aiRoute 更新成 local,UI 才能显示“云端不可用,已切换到端侧智能检索”。这能解决当前问题,但复盘以后我还是觉得两个字符串不够:为什么这么选、能不能重试、界面该提示什么,都散在不同代码里。
如果重新整理这套路由,我会先定义一份路由合同:
type RouteTarget =
  | 'local-only'
  | 'local-retrieve-cloud-generate'
  | 'pending'
  | 'reject'

interface RouteDecision {
  target: RouteTarget
  reason: string
  retryable: boolean
  userMessage: string
  recoveryAction?: string
}
然后再按任务做判断:
function decideBeforeRequest(task: AiTask, state: RuntimeState): RouteDecision {
  if (task.privacyMode) {
    return task.localCapabilityEnough
      ? localOnly('privacy_mode', '已使用端侧知识检索')
      : reject('local_capability_missing', '端侧无法完成,可切换增强模式并授权必要上下文')
  }

  if (!state.networkOnline) {
    return task.localCapabilityEnough
      ? localOnly('network_offline', '已切换到端侧检索')
      : reject('network_required', '请恢复网络后重试')
  }

  if (!state.identityReady) {
    return reject('identity_required', '请先完成登录或身份验证')
  }

  if (state.quotaExhausted) {
    return reject('quota_exhausted', '本月额度已用完,请升级后继续使用')
  }

  return hybrid('try_cloud', '正在生成回答')
}
上面这段是设计伪代码,项目里还没有这个同名函数。身份和额度只约束准备调用云端生成的路径,不拦住 local-only,这也是隐私判断放在前面的原因。请求发出后的 SSE 错误、首 token 超时和空流,仍要按前面的错误传播链进入二次决策。
当前 RAGService 的兜底范围其实更宽:除了云端额度和生成内容身份错误,其他 cloud 异常都会进入 local fallback。这样能先保住可用性,也可能把上下文构建或程序错误一起盖住。如果重新整理合同,我会把自动降级收紧到能明确判定的网络、服务和流式传输异常,其他错误直接暴露出来继续排查。
最后一条很容易漏。知识问答云端失败后,本地返回相关资料,虽然质量会下降,但需求还算成立;会议声纹就不一样了。声纹比对、语音识别和说话人归属有自己的数据、模型和服务依赖,不能因为“知识问答能 fallback”,就给会议功能也套一个万能 local。
Nameo 里有会议声纹能力,用来区分本人和其他发言人。它存在的意义,恰好说明端云路由必须按任务写:问答失败可以退到资料检索,声纹识别失败时却更应该明确提示能力受限,不能随便猜一个说话人继续往下跑。
同样失败,为什么有的降级,有的必须拦住
我现在至少会把错误分成三类。
第一类是能明确识别的基础设施异常,比如云端接口不可达、SSE 返回错误、首 token 超时或空流。目标策略是这类错误才自动尝试 local-only,因为端侧仍有机会把已有资料找出来;当前实现的 fallback 范围还更宽。
第二类是额度耗尽。这属于套餐状态,跟网络好坏没关系。如果一遇到额度错误就偷偷切端侧,用户只会觉得“今天回答怎么突然变差了”,同时产品规则也被绕开了。当前处理是明确告诉用户额度已经用完,并给出升级入口。
第三类是身份未就绪。项目里对权限和身份问题一直选择明确提示,不能拿一句“网络不好”糊过去。交互问答应该提示登录或完成身份验证;允许延迟的后台任务可以保持 pending,等身份恢复以后再继续。
所以 fallback 不是越多越好。它只有在“降级后的能力仍然满足这次任务,并且没有绕过权限、额度和隐私规则”时才成立。
我会怎样测这套路由
只截一张“云端回答成功”的图,证明不了路由设计。至少要把触发条件、实际路径、用户提示和恢复动作放在一起测。
| 场景 | 应走路径 | 用户应该看到什么 | 重点检查 |
|---|---|---|---|
| 正常网络 + 增强模式 | 端侧检索 + 云端生成 | 云端模式、流式回答 | 首 token、引用资料、完成状态 |
| 有网但云端异常 | local-only | 云端不可用并切端侧 | 错误有没有传到路由层,回答是否串资料 |
| 有网 + 隐私模式 | local-only | 端侧模式 | 是否真的没有调用云端生成 |
| 云端生成额度耗尽 | reject | 明确的额度与升级提示 | 不影响 local-only,但不能偷偷降级云端请求 |
| 云端生成身份未就绪 | reject / pending | 登录验证或稍后继续 | 不影响 local-only,权限语义也不能伪装成网络错误 |
| 完全断网后导入复杂文档 | reject / pending | 明确说明解析依赖 | 不要只测已有知识的查询 |
| 弱网 | 按实际能力决定 | 路由和顶部文案一致 | 不要让 UI 写云端,实际却走本地 |
前三种我实际测试过:正常网络能走云端回答,云端异常能切端侧,隐私模式会走本地知识。完全断网和弱网更适合单独做完整测试,尤其不能拿“本地已经有几张卡片能搜到”证明整条文档链路支持离线。
最后复盘
空白气泡那次问题先给我补了一课:失败必须被正确识别并传到路由层。接下来才轮到选路——设备有没有网络、端侧能不能完成任务、额度和身份是否允许调用、降级以后需求还成不成立。
端侧回答的排查顺序已经落到前面的候选卡片、chunk 分数和上下文日志。路由合同负责另一件事:把选择、原因、提示、重试和恢复动作对齐,免得下一次云端挂了以后,又临时往 if (online) 里塞分支。
下一篇不继续给路由加分支,回头聊一个更现实的问题:会 Java 和 Vue,想做 HarmonyOS AI,到底应该先学 ArkTS 和 ArkUI,还是先上 RAG 和 Agent?

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 14
 0
- 0


 已为社区贡献5条内容

所有评论(0)