HarmonyOS、RAG、Agent,到底先学哪个?
会 Java 和 Vue,想转 HarmonyOS + Agent,我给的第一个月安排是这样的。
前两周先学 ArkTS 和 ArkUI。会 Java 和 Vue,上手会比完全零基础快很多,官方也有视频和详细文档。看视频的时候顺手把 Demo 敲出来,不敲永远记不住。ArkUI 页面里最基础的状态变化也要一起练,不然按钮点了,页面为啥刷新、为啥不刷新,还是一头雾水。
第三周再系统学 ArkUI 状态管理、组件间状态传递和 rcp 网络请求。先用官方 API 跑通一次请求、响应和异常处理。想尽快把第一条请求跑起来,也可以试试我封装的三方库 ef_rcp。不过一次请求为什么成功、为什么失败,还是得自己弄明白。
第四周自己做一个带网络请求的小 Demo,连上后端,把 loading、成功、空数据和失败都跑一遍。第一个月先做到这里,Agent 放到后面学也来得及。
上一篇《有网也不一定走云端:HarmonyOS AI 问答怎么切?》讲的是云端、端侧和隐私模式怎么选。这篇先停下继续加能力,回到更基础的问题:HarmonyOS、RAG、Agent,到底应该先学哪个?
我后来不再按技术名词学
做 Nameo 之前,我熟悉 Java、Vue、Docker 和 CI/CD。真开始做 HarmonyOS AI 产品以后,碰到的问题却不会按技术栈排队。
有时是给对象赋值了,界面没刷新;有时是手机页面搬上大屏,两边空得像给 UI 留了两块停车位;有时 RAG 明明找到了 A,却没继续用 A 去找 B;还有时 Dev 单节点一直正常,到多 worker 环境里就开始随机 404。
后来我的学习顺序就变了:项目卡在哪,我先补哪。今天追 Agent,明天又觉得 GraphRAG 更热,看起来挺忙,项目可能一步没动。
一份资料进来后,到底走过什么
假设用户导入一份资料,问了一个需要两步检索才能回答的问题,最后还想把回答里的行动项记成待办。用户看到的只有“导入—提问—确认”,工程里实际走的是这条链:
Phone / Pad / PC → 页面与 ViewModel → 采集、解析与本地数据
                              ↓
                    路由 → 检索 → 回答与引用
                              ↓
                        结果回到页面

用户再次提出动作请求 → Agent 工具 → 确认卡 → 业务写入
这套工程组织是 Nameo 自己的选型,不是 HarmonyOS 官方固定分层。项目目前用 products 区分设备产品,用 features 放业务能力,用 common 放复用能力;页面、ViewModel、Service 和 DAO 也各自收住职责。
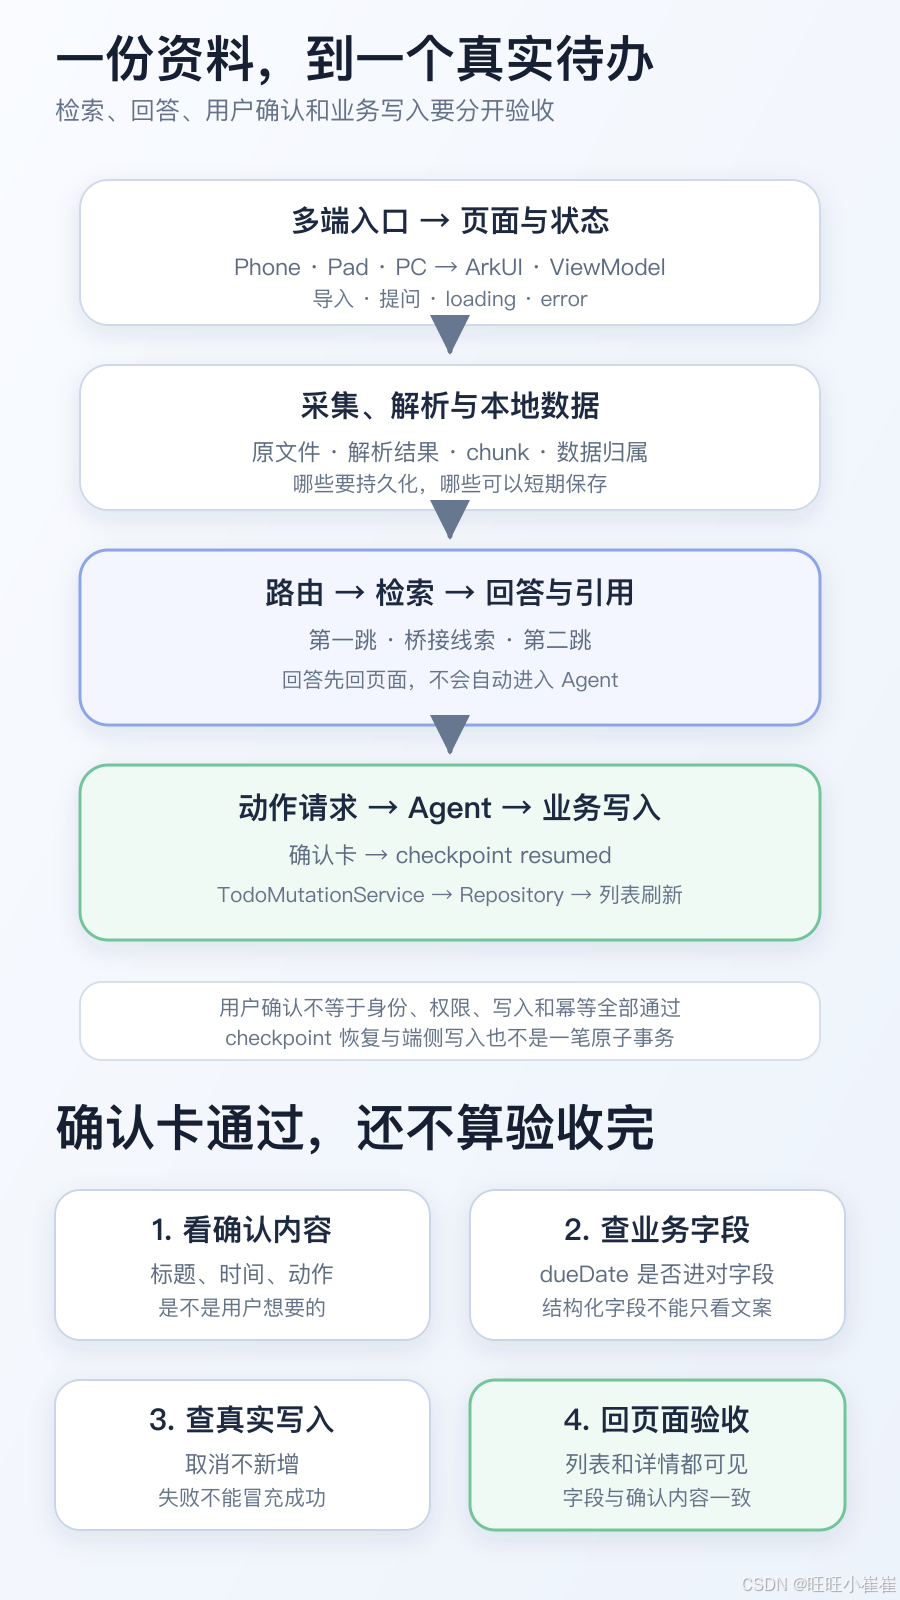
这里最容易漏掉的是数据归属。原文件、解析结果、chunk、待办、短期任务状态分别存在哪,进程重启以后哪些还得在,用户切换环境以后去哪找,都得提前说清楚。拿已经踩过的两个点来说:待办通过端侧 TodoRepository 持久化;文件解析的短期任务状态要让多个 PM2 worker 共享,不能只放在某个 worker 的内存里。《任务明明完成了,PM2轮询为什么随机404?》写的就是后一个问题。
多份资料不一定是多跳
一次检索找回三份资料,可能只是多文档单跳。在这种串行多跳问题里,我会先看一个更直接的标准:第二次检索是否依赖第一跳拿到的实体或关系。
比如原问题要先找到 A,再根据 A 里的桥接线索去找 B。系统只把 A 对应的资料页召回来,哪怕 TopK 再调大,也只是多拿几段 A 附近的内容。真正缺的是第二次检索,以及把“第一跳证据—桥接线索—第二跳证据”记进同一条 trace。
最小 trace 不用一开始就搞得很大,先把下面这几列留下:
| hopIndex | query | sourceId / chunkId | 本跳拿到什么 | 下一步怎么用 |
|---|---|---|---|---|
| 1 | 原问题 | source-a / chunk-a | 实体或关系 A | 用 A 生成第二跳 query |
| 2 | 根据 A 继续找 B | source-b / chunk-b | B 对应的证据 | 检查回答是否同时使用 A、B |
检索链先找证据,回答链再根据证据生成内容并带回引用。用户接着说“帮我创建一个待办”,这时才进入 Agent 的动作链。Nameo 现在会先生成确认卡,把待办内容和时间给用户看;用户确认后先恢复 Agent checkpoint,状态为 resumed 才调用端侧 TodoMutationService 写入本地待办,取消就不写。Phone/Pad 共用这套确认组件,PC 有自己的大屏组件。这条链我已经实际跑过:用户确认后会写入待办,取消则不会新增数据。
端侧真正执行写入的关键调用其实不长:
const result = await AgentService.getInstance().resumeCheckpoint(
  checkpointId, sessionId, resumeToken, 'resume'
);
if (result.status === 'resumed') {
  await createTodoMutationService()
    .createAgentTodoDraft(payload, summary);
}
createAgentTodoDraft 这个名字带着 Draft,实际会创建待办知识卡,通过 Repository 写入,再调度提醒并通知列表刷新。修这条链路时还遇到过一个很典型的问题:模型把“今天 18 点 19 分”写进了标题和正文,却没有放进 dueDate。确认卡看起来没问题,点完确认以后,待办详情里却没有时间。后来在 parseDueDate 里同时处理结构化字段和标题里的日期表达,列表和详情也一起验收。
后来验收就不能只看确认卡了。我会看四件事:取消以后有没有新增数据;确认后列表和详情里能不能看到;截止时间有没有进正确字段;写入失败时页面有没有把它说成成功。确认卡只代表用户确认了本次动作,不等于身份认证、业务权限和服务端授权都通过。字段校验、写入和失败处理还是业务层的事。
这里还有一个企业项目绕不过去的边界:checkpoint 恢复和端侧写入不是一笔原子事务。前一步成功、后一步失败时,重复点击和重试都可能带来重复写入,所以幂等键、可重放状态或补偿处理要单独设计,不能看到 confirmation 流程就顺手把“幂等”也勾上。
前面的坑,其实在同一条链上
ArkUI 数据改了却不刷新,要回头查状态所有权和观察边界;手机 UI 搬上大屏后翻车,要重新分设备任务;RAG 只找到 A,就查桥接线索和第二次检索。AI 又把改好的功能改坏,通常是完成定义和回归证据没跟上;PM2 多进程随机 404,则要先看状态是不是放错了地方。
这些问题单独看,像是 ArkUI、RAG、Harness 和部署各讲各的。放回同一条端到端链路以后,可以先让页面和数据跑通,再处理资料采集与检索,然后补 RAG 证据和 Agent 动作。权益、部署和交付门禁等主链跑通以后再接。
三类读者,可以从不同位置开始
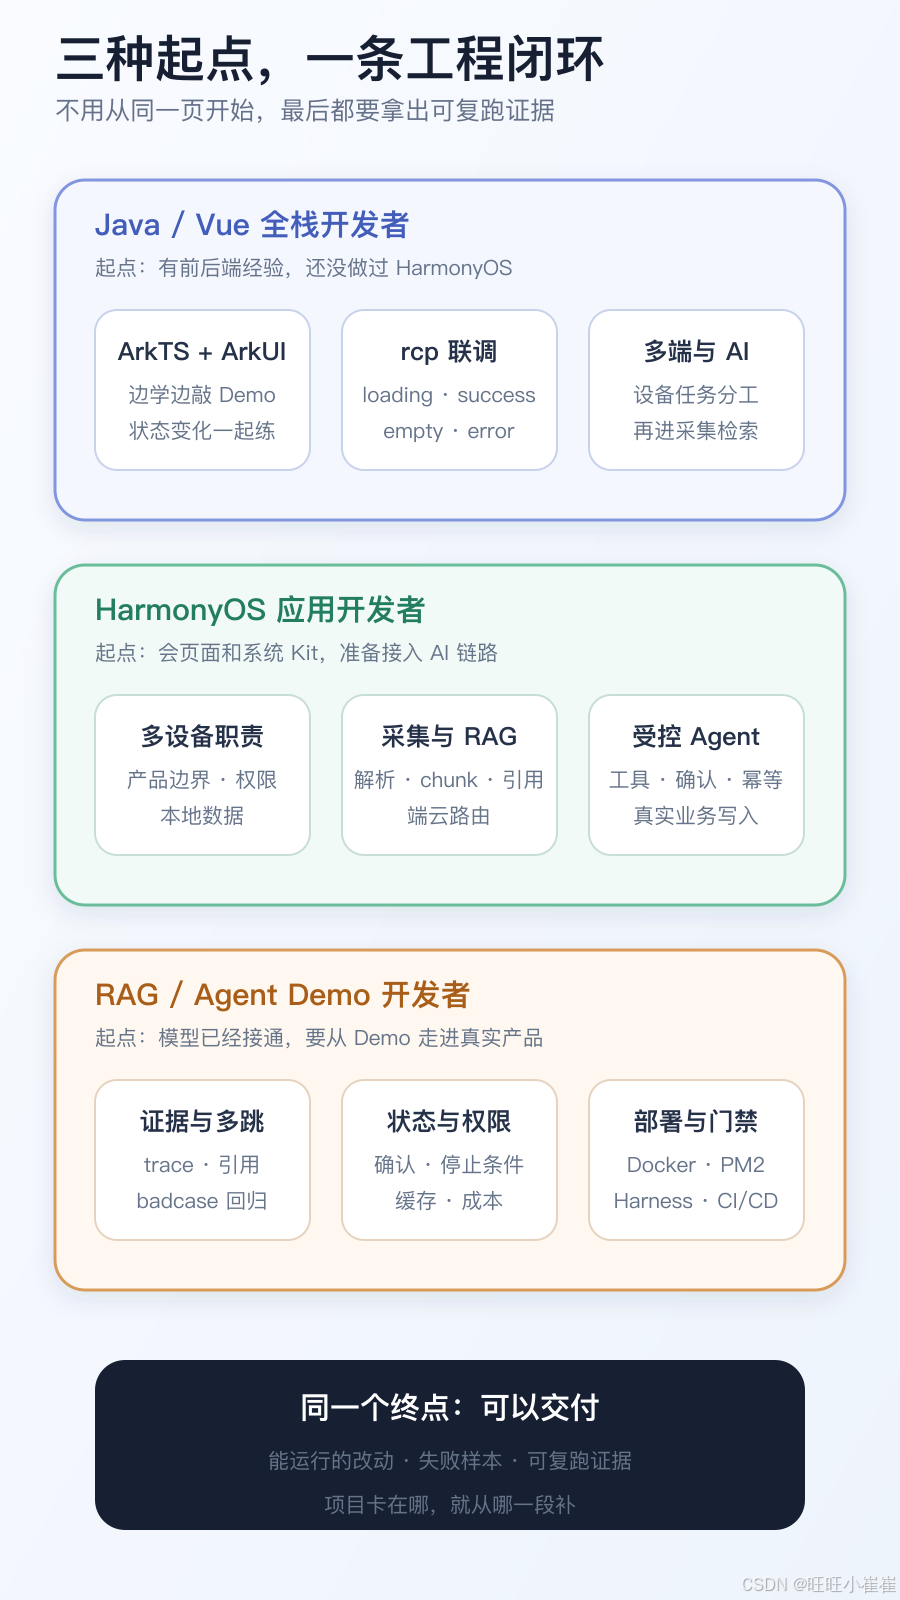
如果你是 Java/Vue 全栈开发者,先照前面的四周计划做一个前后端联调 Demo。Java 的分层经验、Vue 的声明式思维、Docker 和 CI/CD 都能带过来,但状态观察、系统权限和设备形态得重新适应。
如果你已经在做 HarmonyOS,可以跳过大部分语法,从多设备职责、采集、文档解析和本地数据开始,然后再把 chunk、RAG 证据和端云路由接进来。
如果你已经能搭 RAG 或 Agent Demo,可以直接补多跳、引用、工具权限、用户确认、幂等、任务状态、缓存、成本和发布验证,不用再从“大模型 API 怎么调”开始。
不管从哪里开始,学完一段最好都留下一个东西:能运行的 Demo、失败样本及对应 trace、Agent 状态机、设备—任务矩阵,或者一份能重新执行的验证表。只留成功截图,下次很难判断到底是真修好了,还是碰巧走通了。
免费部分到这里,后面继续往哪挖
后面的付费内容会分三段。第一段先把 HarmonyOS 多端、系统 Kit、采集和本地数据连起来,留下多端责任图和数据边界;第二段进入 chunk、混合检索、多跳、引用和受控 Agent,留下检索 trace 与 Agent 状态机;第三段再接权益、支付、Docker/PM2、Harness 和 CI/CD,留下部署、回滚与验证清单。
正文会给经过解释的核心代码或伪代码、状态机、决策表、验证矩阵和可复用模板,不提供完整 Nameo 商业源码。如果只想拿一套完整源码改名,或者只想学模型训练和算法推导,这个专栏不合适。
最后复盘
Java/Vue 开发者先跑通 ArkUI 状态和前后端联调;HarmonyOS 开发者可以更早进入采集与 AI 链路;已经会 RAG/Agent Demo 的开发者,则要开始补证据、权限、状态和发布验证。
Nameo 还在上线审核流程里,目前正在处理提审问题。付费专栏已经开始囤稿,我会先从产品与 HarmonyOS 工程底座写起,再进入 RAG/Agent 和商业化交付。等第一批文章准备好以后,再确定正式更新节奏。
项目卡在哪,就回到那一段,把失败样本留下,再把验证补上。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 10
 0
- 0


 已为社区贡献5条内容

所有评论(0)