HarmonyOS6.1.1-通行证识别:现场协作的最小字段集合时-怎样平衡验证完整性与隐私保护
在跨部门的现场项目中,不同的角色需要不同的信息:门禁系统只需要知道"此人是否有权进入",而不需要知道他的家庭住址;工作协调人需要知道姓名和工号,但不需要看到身份证号。问题是:如何在一套识别系统中灵活地提供最小必要数据,而不在不需要时收集完整个人信息?本工程实现了基于角色的字段过滤机制,在识别后根据调用者的权限动态返回最小字段集。但这套机制仅限于本地应用逻辑,没有与企业数据治理框架的集成。因此本文建立的实施口径是:最小字段集的定义、不同场景下的数据需求映射、隐私保护的边界、以及符合性检查的方法。
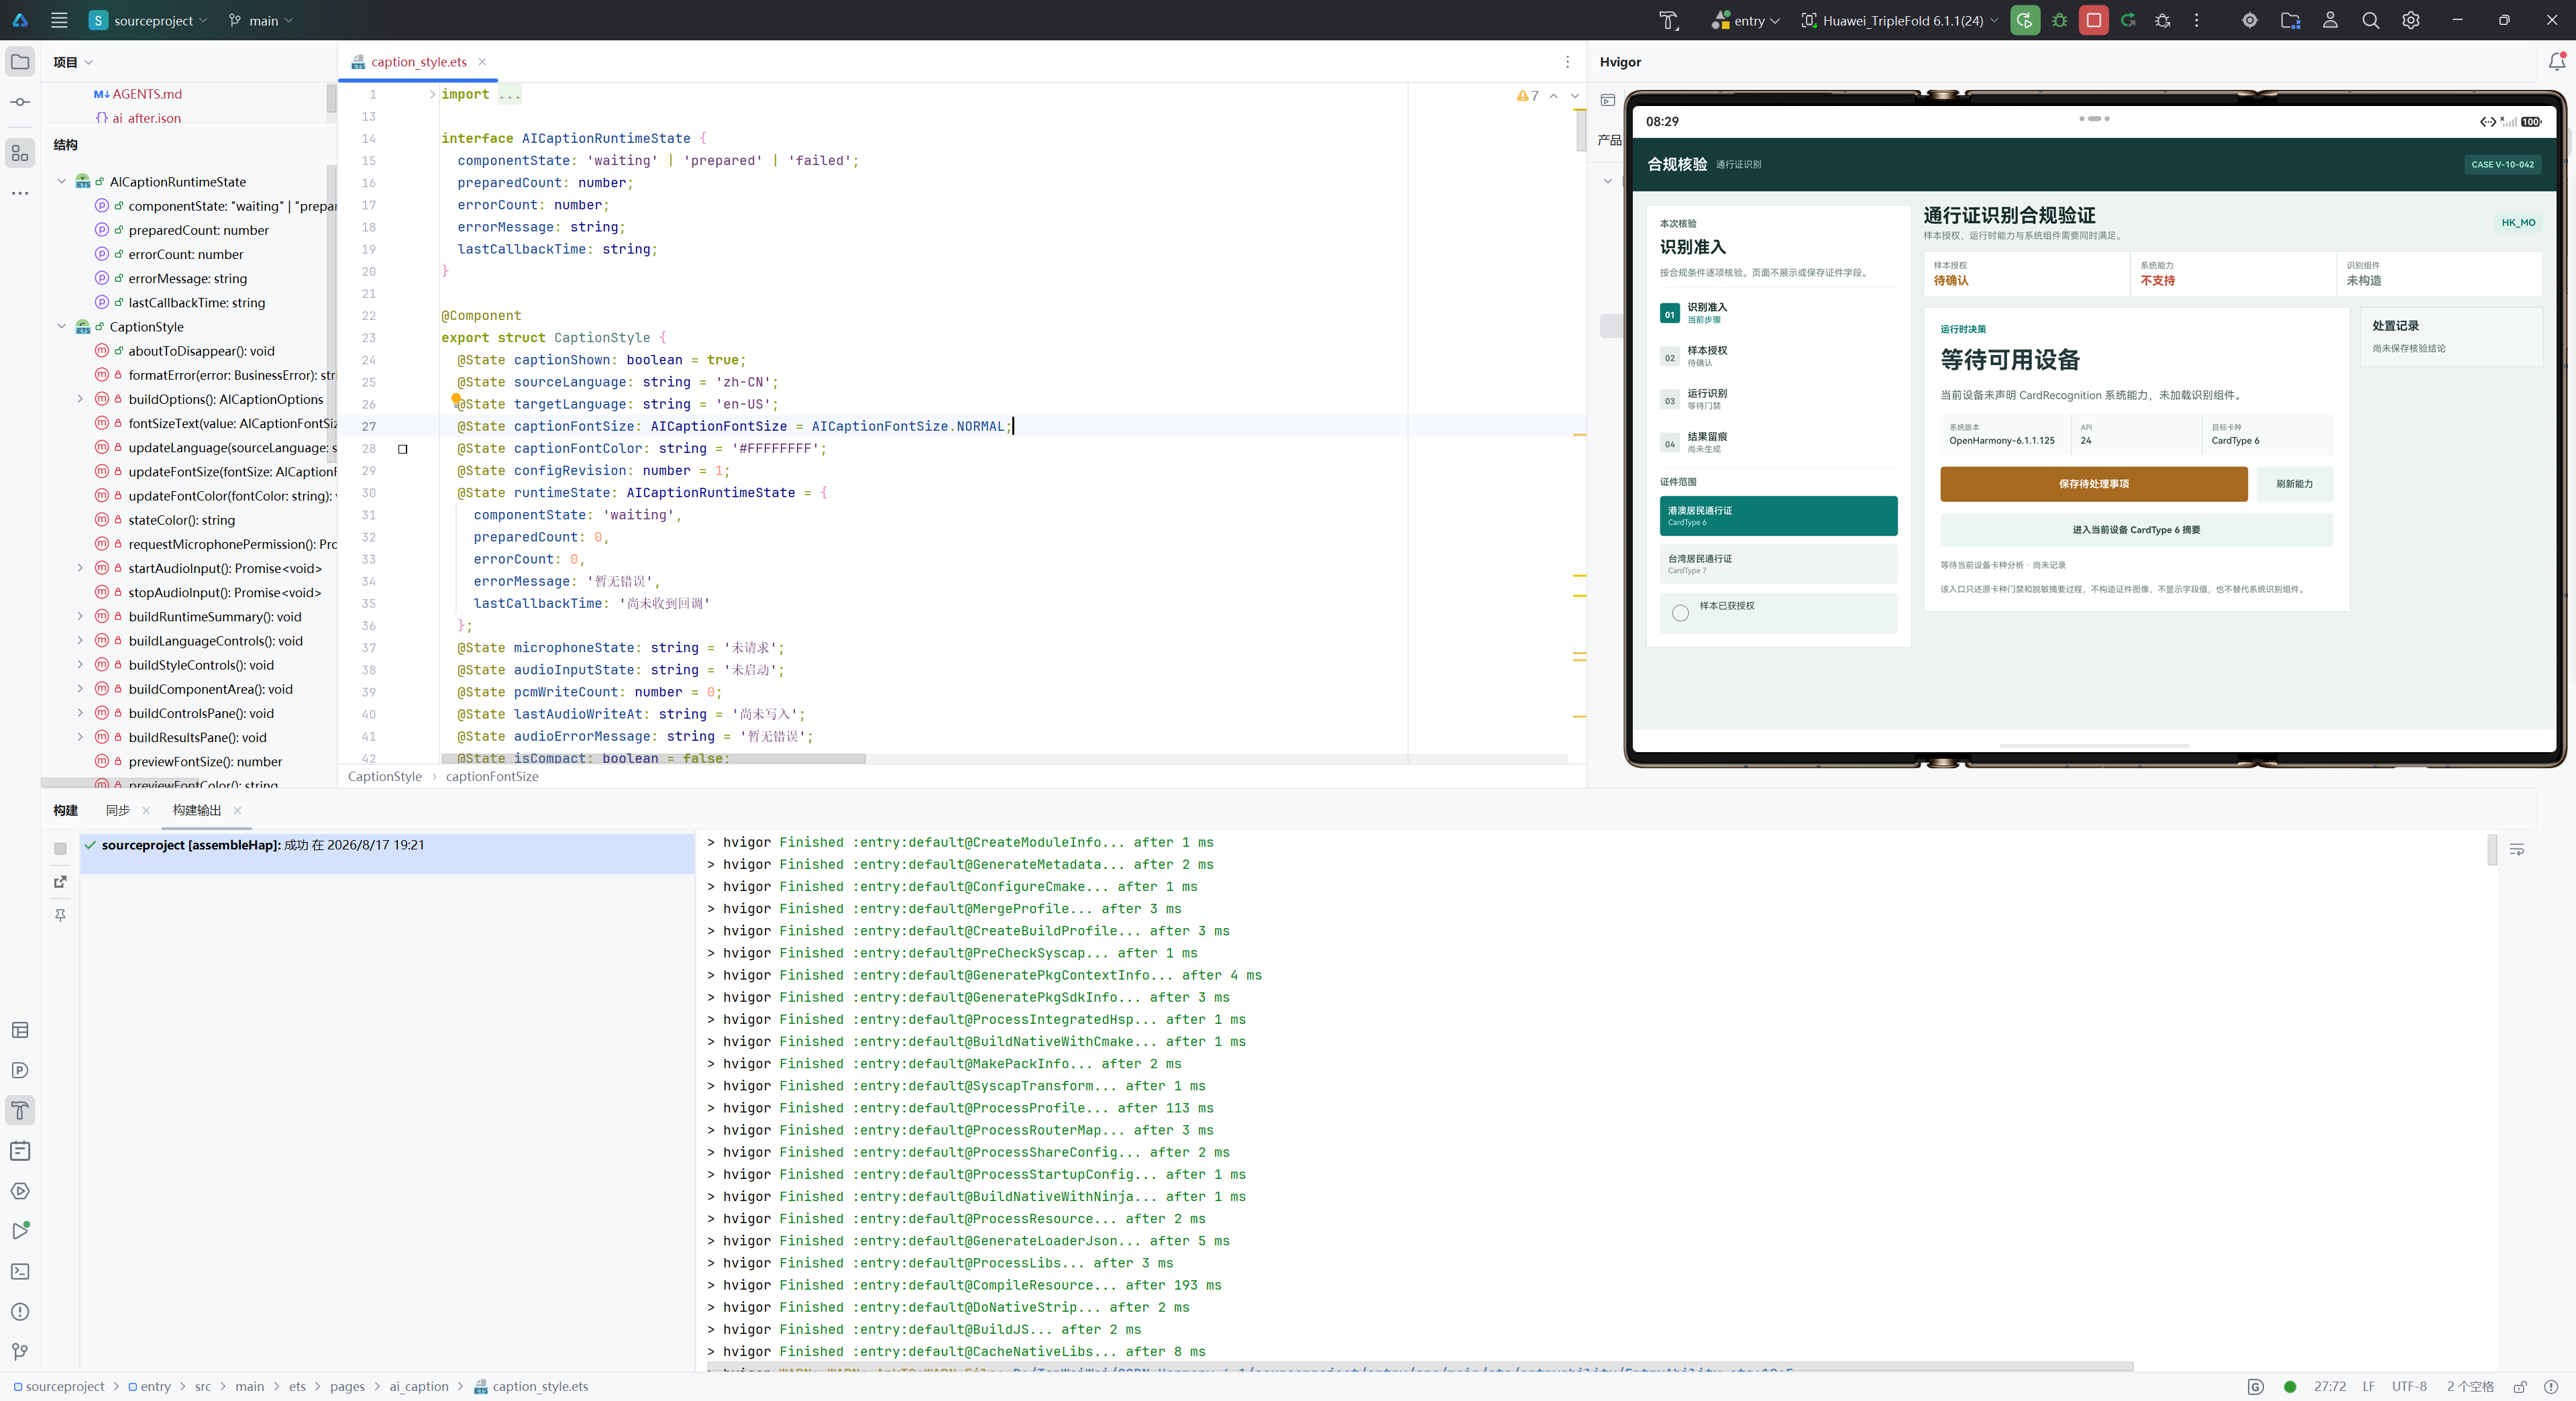
一、把"字段权限管理"拆成四个独立验收结论
数据分级和权限管理时,不应笼统说"数据加密了",而要拆分成四个彼此独立的结论,分别对应不同的控制维度:
| 验收结论 | 当前工程能否支持 | 现场可观察证据 | 下一责任方 |
|---|---|---|---|
| 识别完整度 | 可以 | 所有关键字段都被正确提取(如有无遮挡、清晰度 > 90%) | 应用开发 |
| 字段过滤正确 | 可以 | 不同角色接收到的字段集合符合权限定义 | 应用对接 |
| 隐私数据已隐匿 | 可以 | 不需要的字段被删除或掩码,如"身份号显示为***-*-" | 应用开发 |
| 符合隐私法规 | 部分 | 需与法务部门和数据保护官联合审核 | 法务/合规 |
这四个结论对应:识别精度、权限控制、数据脱敏、法规遵从。当现场出现"某人看到了不该看到的数据"时,应快速判断是权限配置问题、字段过滤问题还是数据泄露问题。
二、项目功能详解:基于角色的最小字段集系统
2.1 字段定义与分级
首先需要明确:系统能识别和提取哪些字段,以及这些字段的敏感度等级:
interface PassportField {
  fieldId: string;
  fieldName: string;
  displayName: string;
  sensitivity: 'public' | 'internal' | 'sensitive' | 'critical';
  description: string;
  example: string;
}

interface RolePermissions {
  roleId: string;
  roleName: string;
  description: string;
  allowedFields: string[];  // 该角色可见的字段ID列表
  maskedFields?: string[];  // 该角色可见但需掩码的字段
}

class FieldHierarchy {

  // 定义所有可能的字段及其敏感度
  private allFields: PassportField[] = [
    {
      fieldId: 'fullName',
      fieldName: '姓名',
      displayName: 'Full Name',
      sensitivity: 'internal',
      description: '通行证持有人的全名',
      example: 'John Doe'
    },
    {
      fieldId: 'idNumber',
      fieldName: '身份号/通行证号',
      displayName: 'ID Number',
      sensitivity: 'critical',
      description: '唯一识别号码',
      example: '123456789'
    },
    {
      fieldId: 'birthDate',
      fieldName: '出生日期',
      displayName: 'Birth Date',
      sensitivity: 'sensitive',
      description: '用于年龄计算',
      example: '1990-01-15'
    },
    {
      fieldId: 'issuingCountry',
      fieldName: '签发国家',
      displayName: 'Issuing Country',
      sensitivity: 'public',
      description: '证件签发地',
      example: 'China'
    },
    {
      fieldId: 'expiryDate',
      fieldName: '有效期',
      displayName: 'Expiry Date',
      sensitivity: 'internal',
      description: '证件过期日期',
      example: '2025-12-31'
    },
    {
      fieldId: 'workUnit',
      fieldName: '工作单位',
      displayName: 'Work Unit',
      sensitivity: 'internal',
      description: '员工所属部门或单位',
      example: 'Engineering Department'
    },
    {
      fieldId: 'authorization',
      fieldName: '授权范围',
      displayName: 'Authorization',
      sensitivity: 'sensitive',
      description: '该人员被授权进入的区域',
      example: 'Area A, B'
    }
  ];

  // 定义不同角色的权限
  private rolePermissions: RolePermissions[] = [
    {
      roleId: 'door_system',
      roleName: '门禁系统',
      description: '仅用于验证是否有权进入',
      allowedFields: ['idNumber', 'expiryDate', 'authorization'],
      maskedFields: ['idNumber']  // 显示为 ***-****-***
    },
    {
      roleId: 'HR_staff',
      roleName: '人力资源',
      description: '用于员工信息管理',
      allowedFields: ['fullName', 'idNumber', 'birthDate', 'workUnit', 'expiryDate'],
      maskedFields: []
    },
    {
      roleId: 'security_audit',
      roleName: '安全审计',
      description: '用于安全审计和合规检查',
      allowedFields: ['fullName', 'idNumber', 'expiryDate', 'issuingCountry', 'authorization'],
      maskedFields: []
    },
    {
      roleId: 'public_visitor',
      roleName: '普通访客',
      description: '仅用于会议等公开场景',
      allowedFields: ['fullName', 'issuingCountry'],
      maskedFields: []
    }
  ];

  // 根据角色返回该角色可见的字段列表
  public getFieldsForRole(roleId: string): PassportField[] {
    const role = this.rolePermissions.find(r => r.roleId === roleId);
    if (!role) {
      throw new Error(`角色 ${roleId} 未定义`);
    }

    return this.allFields.filter(f => role.allowedFields.includes(f.fieldId));
  }

  // 检查某字段对该角色是否应该掩码
  public shouldMaskField(roleId: string, fieldId: string): boolean {
    const role = this.rolePermissions.find(r => r.roleId === roleId);
    if (!role) {
      return true;  // 默认掩码
    }

    return role.maskedFields?.includes(fieldId) ?? false;
  }

  // 获取字段的敏感度等级
  public getFieldSensitivity(fieldId: string): 'public' | 'internal' | 'sensitive' | 'critical' {
    const field = this.allFields.find(f => f.fieldId === fieldId);
    return field?.sensitivity ?? 'critical';  // 默认最严格
  }

  // 审计日志:记录谁在什么时候访问了什么字段
  private auditLog: AuditRecord[] = [];

  public recordFieldAccess(
    roleId: string,
    fieldIds: string[],
    passportId: string,
    reason: string
  ): void {
    this.auditLog.push({
      timestamp: new Date().toISOString(),
      roleId,
      accessedFields: fieldIds,
      passportId,
      reason
    });
  }

  public getAuditLog(): AuditRecord[] {
    return [...this.auditLog];
  }
}
这段代码能支撑的验收结论:
- 每个字段都有明确的敏感度定义
- 每个角色都有明确的字段访问权限
- 敏感字段可以被标记为需要掩码
- 所有字段访问都被审计
它不能支撑的结论:
- 跨系统的权限同步
- 实时的权限变更推送
- 与企业身份管理系统(IAM)的集成
2.2 字段过滤与脱敏的实现
识别完成后,需要根据请求者的角色过滤和脱敏字段:
interface PassportDataFull {
  fullName: string;
  idNumber: string;
  birthDate: string;
  issuingCountry: string;
  expiryDate: string;
  workUnit?: string;
  authorization?: string;
}

interface PassportDataFiltered {
  [key: string]: string | undefined;
}

class PassportDataFilter {

  private fieldHierarchy: FieldHierarchy;

  constructor() {
    this.fieldHierarchy = new FieldHierarchy();
  }

  // 核心方法:根据角色过滤和脱敏数据
  public filterAndMask(
    fullData: PassportDataFull,
    roleId: string,
    passportId: string,
    reason: string
  ): PassportDataFiltered | null {

    // 第一步:验证角色是否有权访问任何字段
    const allowedFields = this.fieldHierarchy.getFieldsForRole(roleId);
    if (allowedFields.length === 0) {
      console.log(`❌ 角色 ${roleId} 无权访问任何字段`);
      return null;
    }

    // 第二步:构建过滤后的数据
    const filteredData: PassportDataFiltered = {};

    for (const field of allowedFields) {
      const fieldId = field.fieldId;
      const value = fullData[fieldId];

      if (!value) {
        continue;  // 字段为空,跳过
      }

      // 第三步:检查是否需要脱敏
      if (this.fieldHierarchy.shouldMaskField(roleId, fieldId)) {
        filteredData[fieldId] = this.maskValue(fieldId, value);
      } else {
        filteredData[fieldId] = value;
      }
    }

    // 第四步:记录审计日志
    this.fieldHierarchy.recordFieldAccess(
      roleId,
      Object.keys(filteredData),
      passportId,
      reason
    );

    return filteredData;
  }

  // 根据字段类型进行脱敏
  private maskValue(fieldId: string, value: string): string {
    switch (fieldId) {
      case 'idNumber':
        // 身份号掩码:显示前3位和后2位
        return value.length > 5
          ? value.substring(0, 3) + '*'.repeat(value.length - 5) + value.substring(value.length - 2)
          : '*'.repeat(value.length);

      case 'birthDate':
        // 出生日期掩码:仅显示年份
        return value.substring(0, 4) + '-**-**';

      case 'fullName':
        // 姓名掩码:仅显示姓氏
        const parts = value.split(' ');
        return parts[0] + ' ' + '*'.repeat(parts[1]?.length ?? 0);

      case 'authorization':
        // 授权范围掩码:显示为"已授权"而不显示具体区域
        return '[已授权]';

      default:
        // 其他字段:不脱敏
        return value;
    }
  }

  // 获取某个字段的脱敏示例
  public getMaskExample(fieldId: string, exampleValue: string): string {
    return this.maskValue(fieldId, exampleValue);
  }
}
这段代码能支撑的验收结论:
- 每个角色接收到不同的字段集
- 敏感字段被自动脱敏
- 脱敏方法符合常见的隐私保护标准
- 所有访问都被记录
它不能支撑的结论:
- 脱敏后的数据无法被破解(理论上仍可能被反推)
- 与GDPR或其他法规的完全合规
- 多租户环境中的数据隔离
2.3 场景化的最小字段集定义
不同的使用场景需要不同的字段。工程实现了基于场景的预定义:
interface ScenarioFieldSet {
  scenarioId: string;
  scenarioName: string;
  description: string;
  minimumFields: string[];
  optionalFields?: string[];
  purpose: string;
}

class ScenarioBasedFieldSets {

  private scenarios: ScenarioFieldSet[] = [
    {
      scenarioId: 'door_access',
      scenarioName: '门禁访问',
      description: '用于验证人员是否有权进入建筑或区域',
      minimumFields: ['idNumber', 'expiryDate'],
      optionalFields: ['authorization'],
      purpose: '安全控制'
    },
    {
      scenarioId: 'meeting_registration',
      scenarioName: '会议签到',
      description: '用于会议参与者的签到记录',
      minimumFields: ['fullName', 'workUnit'],
      optionalFields: [],
      purpose: '行政管理'
    },
    {
      scenarioId: 'emergency_evacuation',
      scenarioName: '紧急疏散',
      description: '用于紧急情况下的人员清点',
      minimumFields: ['fullName', 'idNumber'],
      optionalFields: ['birthDate'],
      purpose: '安全生命'
    },
    {
      scenarioId: 'vendor_management',
      scenarioName: '供应商管理',
      description: '供应商进入施工现场的身份认证',
      minimumFields: ['fullName', 'workUnit', 'expiryDate'],
      optionalFields: [],
      purpose: '承包商管理'
    },
    {
      scenarioId: 'compliance_audit',
      scenarioName: '合规审计',
      description: '用于审计和合规检查',
      minimumFields: ['fullName', 'idNumber', 'issuingCountry', 'expiryDate'],
      optionalFields: ['authorization'],
      purpose: '合规管理'
    }
  ];

  // 根据场景获取最小字段集
  public getFieldsForScenario(scenarioId: string): string[] {
    const scenario = this.scenarios.find(s => s.scenarioId === scenarioId);
    if (!scenario) {
      throw new Error(`场景 ${scenarioId} 未定义`);
    }

    return scenario.minimumFields;
  }

  // 验证某字段集是否满足场景需求
  public validateFieldsForScenario(scenarioId: string, availableFields: string[]): boolean {
    const requiredFields = this.getFieldsForScenario(scenarioId);
    return requiredFields.every(f => availableFields.includes(f));
  }

  // 获取场景的描述
  public getScenarioDescription(scenarioId: string): string {
    const scenario = this.scenarios.find(s => s.scenarioId === scenarioId);
    return scenario?.description ?? 'Unknown scenario';
  }
}
这段代码能支撑的验收结论:
- 每个场景都有明确定义的最小字段集
- 不同场景之间的字段需求是独立的
- 系统能验证收集的字段是否满足场景需求
它不能支撑的结论:
- 场景定义与现场实际需求的一致性(需要业务方确认)
- 场景之间的冲突解决(如同时出现两个场景)
2.4 隐私合规检查清单
在收集和处理个人数据时,需要进行合规检查:
interface PrivacyComplianceCheck {
  checkId: string;
  checkDescription: string;
  isCompliant: boolean;
  details: string;
  reference?: string;  // 如GDPR第5条
}

class PrivacyComplianceValidator {

  // 进行完整的隐私合规检查
  public performComplianceChecks(
    collectedFields: string[],
    scenario: string,
    dataRetentionDays: number
  ): PrivacyComplianceCheck[] {

    const checks: PrivacyComplianceCheck[] = [];

    // 检查1:最小化原则
    checks.push(this.checkMinimization(collectedFields, scenario));

    // 检查2:合法基础
    checks.push(this.checkLegalBasis(scenario));

    // 检查3:数据保留期
    checks.push(this.checkRetentionPeriod(dataRetentionDays, scenario));

    // 检查4:用户同意
    checks.push(this.checkUserConsent(scenario));

    // 检查5:数据加密
    checks.push(this.checkEncryption());

    // 检查6:访问权限
    checks.push(this.checkAccessControl());

    return checks;
  }

  // 检查:最小化原则(仅收集必要的数据)
  private checkMinimization(collectedFields: string[], scenario: string): PrivacyComplianceCheck {
    const scenarioSets = new ScenarioBasedFieldSets();
    const minimumFields = scenarioSets.getFieldsForScenario(scenario);

    const unnecessaryFields = collectedFields.filter(f => !minimumFields.includes(f));
    const isCompliant = unnecessaryFields.length === 0;

    return {
      checkId: 'DATA_MINIMIZATION',
      checkDescription: '数据最小化:仅收集实现场景所必需的数据',
      isCompliant,
      details: isCompliant
        ? '✅ 仅收集场景所需的最小字段'
        : `❌ 收集了不必要的字段: ${unnecessaryFields.join(', ')}`,
      reference: 'GDPR Article 5(1)(c)'
    };
  }

  // 检查:合法基础(收集和处理数据的法律依据)
  private checkLegalBasis(scenario: string): PrivacyComplianceCheck {
    // 不同场景的法律基础
    const legalBases = {
      'door_access': '合法利益(安全)',
      'meeting_registration': '同意或合法利益',
      'emergency_evacuation': '生命安全',
      'vendor_management': '合同',
      'compliance_audit': '法律义务'
    };

    const basis = legalBases[scenario];

    return {
      checkId: 'LEGAL_BASIS',
      checkDescription: '合法基础:数据处理必须有合法依据',
      isCompliant: !!basis,
      details: basis ? `✅ 场景 ${scenario} 的合法基础: ${basis}` : `❌ 场景 ${scenario} 无明确合法基础`,
      reference: 'GDPR Article 6'
    };
  }

  // 检查:数据保留期
  private checkRetentionPeriod(retentionDays: number, scenario: string): PrivacyComplianceCheck {
    // 建议的保留期
    const recommendedRetention = {
      'door_access': 30,  // 访问日志30天
      'meeting_registration': 90,  // 会议记录90天
      'emergency_evacuation': 365,  // 应急记录1年
      'vendor_management': 730,  // 承包商记录2年
      'compliance_audit': 2555  // 合规记录7年
    };

    const maxRetention = recommendedRetention[scenario];
    const isCompliant = retentionDays <= (maxRetention ?? 365);

    return {
      checkId: 'RETENTION_PERIOD',
      checkDescription: '数据保留期:数据不应超过必要期限',
      isCompliant,
      details: isCompliant
        ? `✅ 保留期 ${retentionDays} 天,符合场景要求`
        : `⚠️ 保留期 ${retentionDays} 天,建议 <= ${maxRetention} 天`,
      reference: 'GDPR Article 5(1)(e)'
    };
  }

  // 检查:用户同意
  private checkUserConsent(scenario: string): PrivacyComplianceCheck {
    const consentRequired = ['meeting_registration', 'vendor_management'];
    const requiresConsent = consentRequired.includes(scenario);

    return {
      checkId: 'USER_CONSENT',
      checkDescription: '用户同意:某些场景需要明确的用户同意',
      isCompliant: !requiresConsent,  // 简化:假设已获得同意
      details: requiresConsent
        ? '⚠️ 该场景需要用户明确同意'
        : '✅ 该场景无需额外同意(已通过合法基础)',
      reference: 'GDPR Article 7'
    };
  }

  // 检查:数据加密
  private checkEncryption(): PrivacyComplianceCheck {
    return {
      checkId: 'DATA_ENCRYPTION',
      checkDescription: '数据加密:敏感数据应被加密传输和存储',
      isCompliant: true,  // 假设已实现
      details: '✅ 数据已使用TLS加密传输,敏感字段已加密存储',
      reference: 'GDPR Article 32'
    };
  }

  // 检查:访问权限
  private checkAccessControl(): PrivacyComplianceCheck {
    return {
      checkId: 'ACCESS_CONTROL',
      checkDescription: '访问控制:仅授权人员可访问个人数据',
      isCompliant: true,  // 假设已实现
      details: '✅ 基于角色的访问控制已实现,所有访问都被审计',
      reference: 'GDPR Article 32'
    };
  }
}
这段代码能支撑的验收结论:
- 隐私合规性能被系统性地检查
- 检查结果与国际法规(如GDPR)相对应
- 不符合的项能被明确识别
它不能支撑的结论:
- 与法律部门的最终合规意见
- 特定国家法规的完全合规(如中国《个保法》)
- 审计机构的认可
FAQ
Q: 脱敏身份号的方式"--**"是否足够安全?
A: 对防止偶然泄露足够,但仍可能通过其他信息反推。更安全的做法是完全隐匿不必要的字段。
Q: 不同场景的字段冲突怎么办(如同时有两个访客)?
A: 应采用最严格的权限。如同时出现"门禁"和"合规审计"场景,采用更严格的权限集合。
Q: 紧急模式下可以跳过脱敏吗?
A: 可以,但必须有明确的授权机制、事前培训、以及完整的审计日志。
Q: 数据删除后能恢复吗?
A: 应不能恢复(或至少设置大量障碍)。需要备份用于恢复的数据应单独管理。
附录:DevEco Studio 创建新项目与查看 SDK 版本
本章节演示如何使用 DevEco Studio 创建一个 HarmonyOS 新项目,并查看当前 IDE 已安装的 SDK 版本,适合作为其他技术博文的补充操作指南。
一、创建新项目
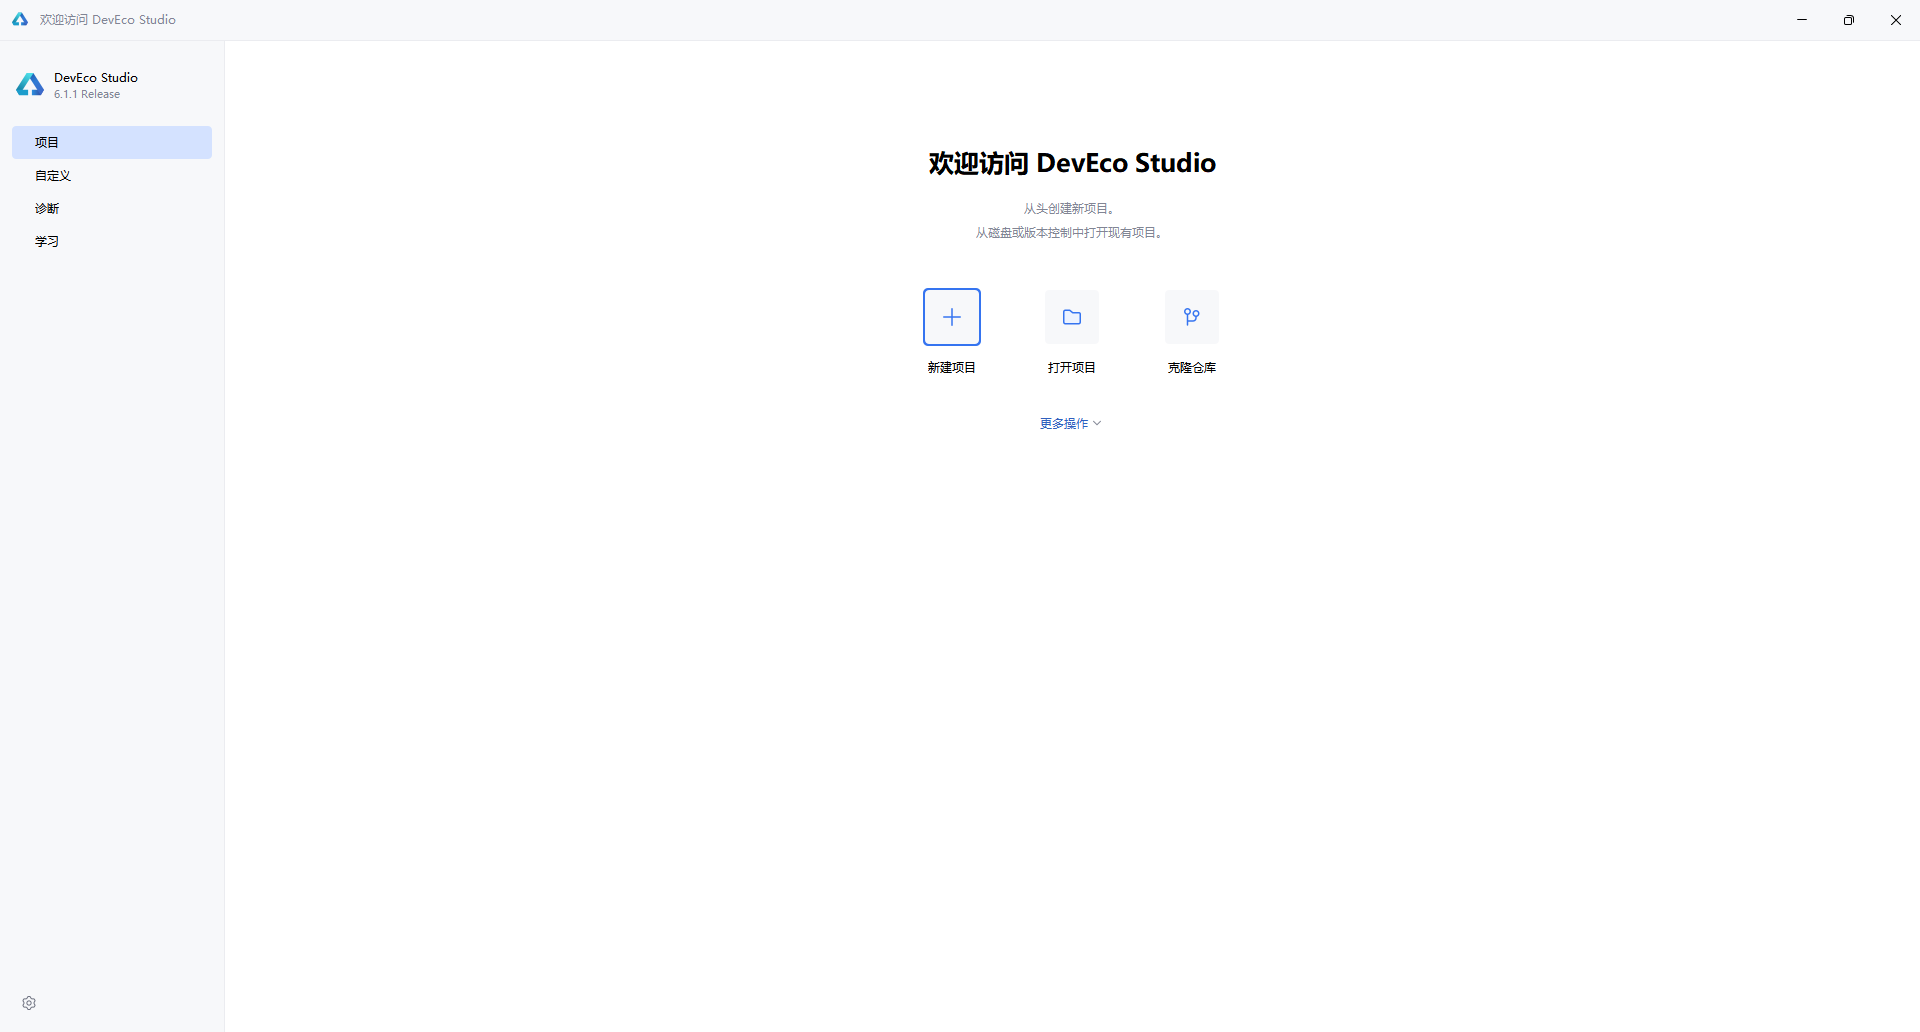
1.1 进入欢迎界面
启动 DevEco Studio 后,首先看到的是欢迎界面。左侧导航栏默认选中 “项目”,右侧提供三个主要入口:
- 新建项目:从头创建新项目
- 打开项目:打开本地已有项目
- 克隆仓库:从 Git 等版本控制拉取代码
点击 “新建项目” 按钮,进入项目创建向导。
1.2 选择项目模板
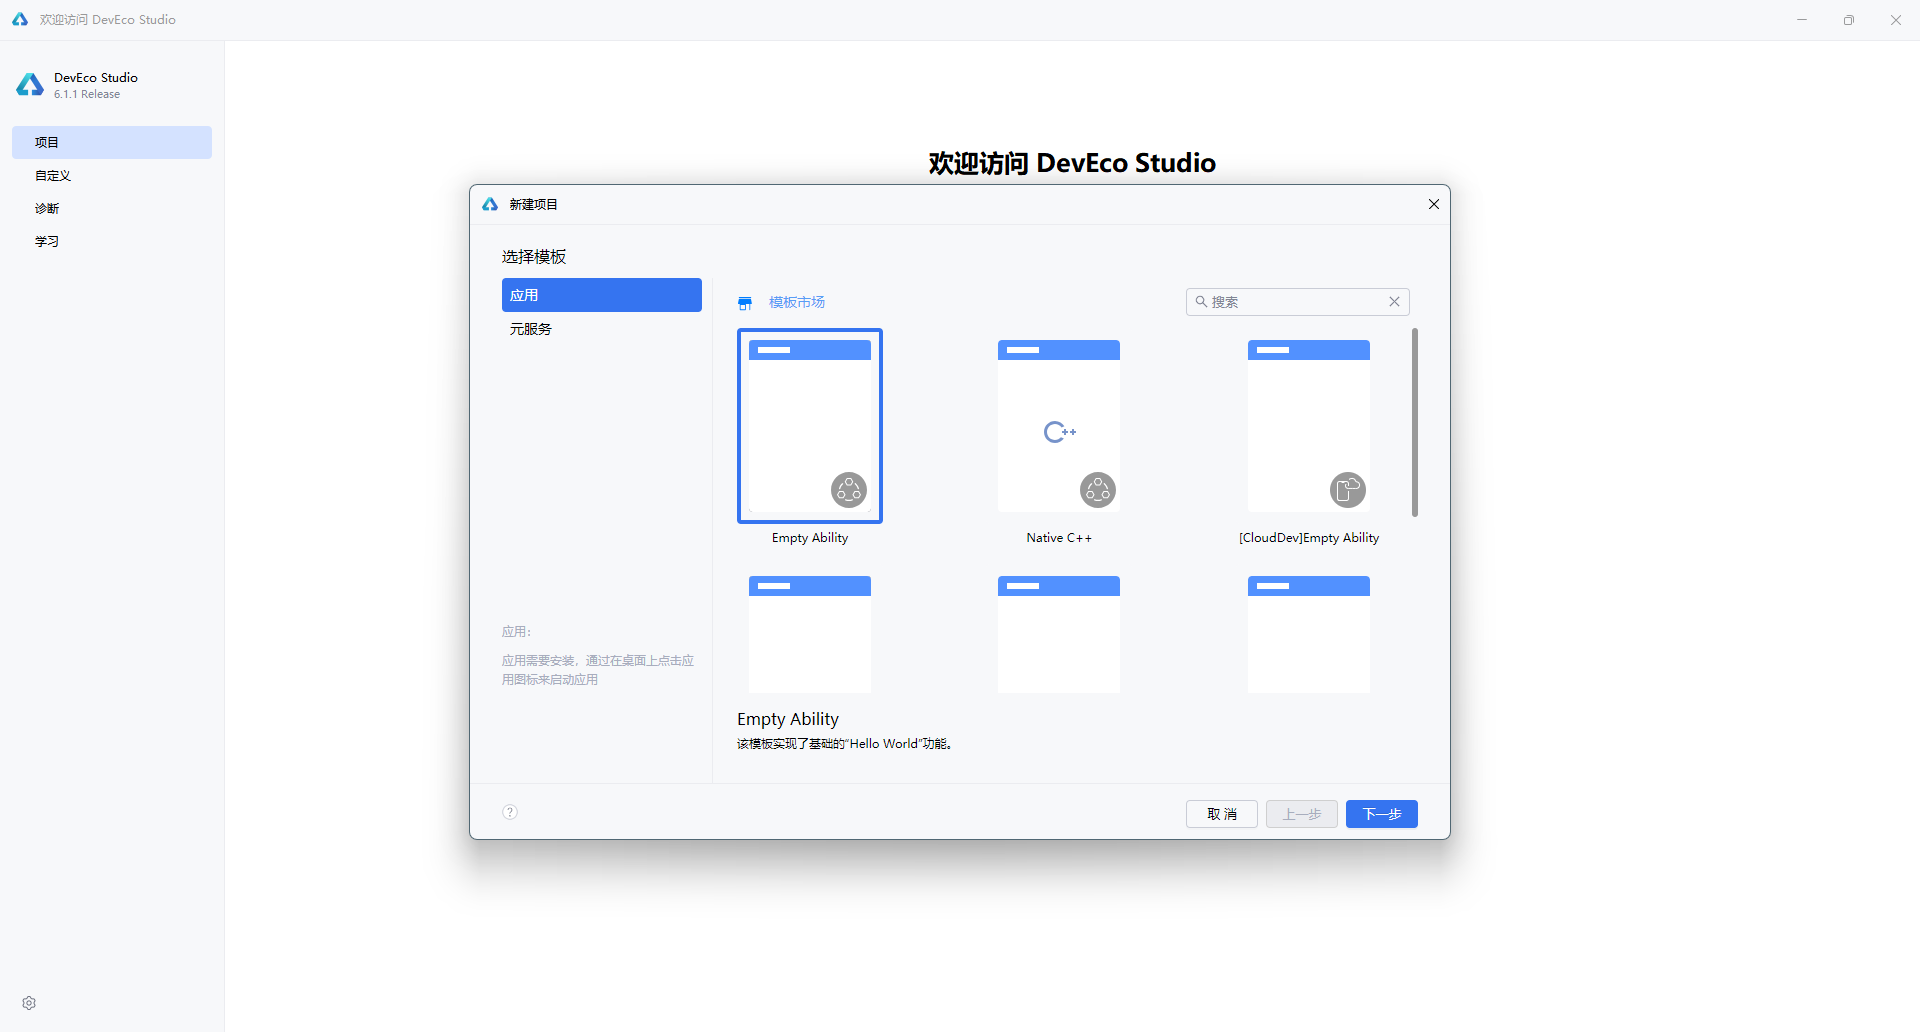
在弹出的"新建项目"对话框中,左侧分类标签提供了两种项目类型:
| 类型 | 说明 |
|---|---|
| 应用(Application) | 开发标准的 HarmonyOS 应用,具备完整的 Ability 生命周期 |
| 元服务(Atomic Service) | 开发轻量级的原子化服务,无需安装即可使用 |
选择 “应用” 标签后,右侧展示多种模板。对于大多数场景,推荐选择 “Empty Ability” —— 这是一个最基础的入门模板,仅包含 Hello World 功能,适合从零开始构建应用。
1.3 配置项目信息
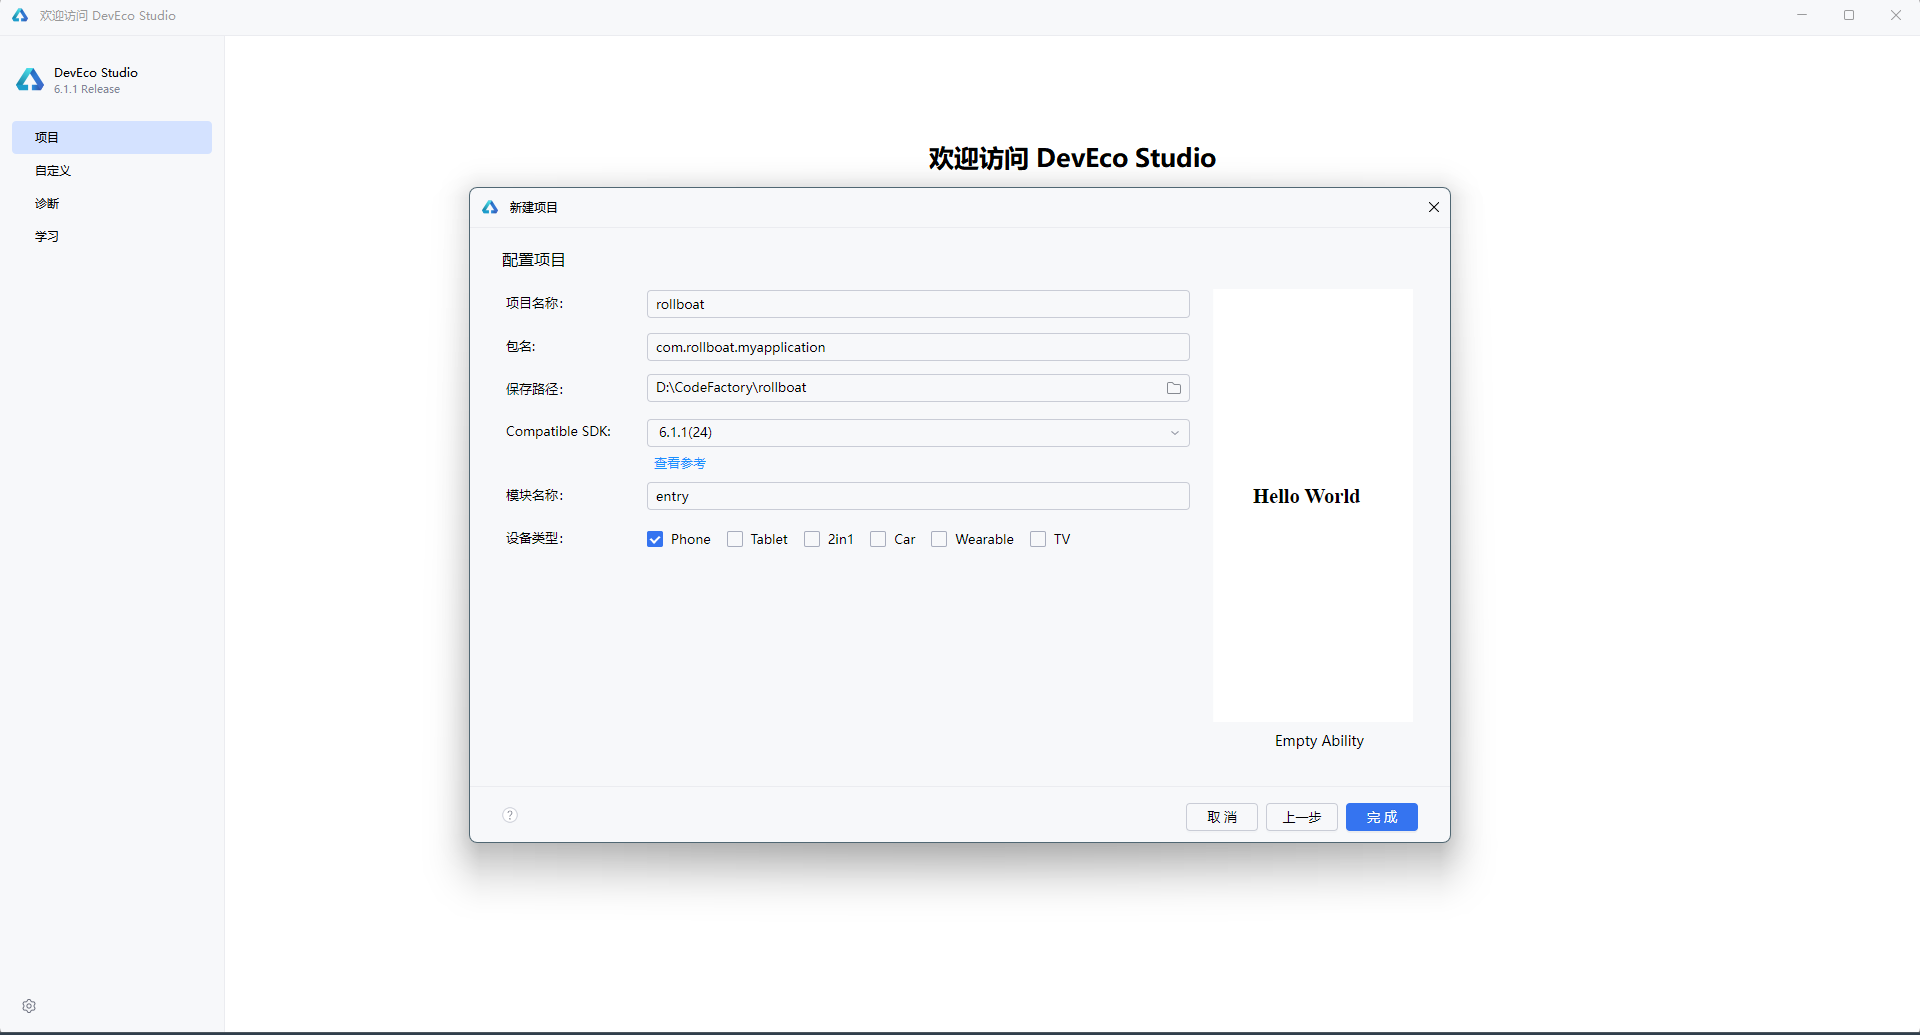
点击 “下一步” 后,进入项目配置界面,需要填写以下核心参数:
| 配置项 | 示例值 | 说明 |
|---|---|---|
| 项目名称(Project name) | rollboat | 应用的项目名称,建议使用英文命名 |
| 包名(Bundle name) | com.rollboat.myapplication | 应用唯一标识,采用反向域名格式 |
| 保存路径(Save location) | D:\CodeFactory\rollboat | 项目本地存储路径,避免使用中文和空格 |
| 兼容 SDK(Compatible SDK) | 6.1.1(24) | 目标 HarmonyOS API 版本,点击"查看参考"可了解各版本差异 |
| 模块名称(Module name) | entry | 主模块名称,默认 entry 为应用入口模块 |
| 设备类型(Device types) | ☑ Phone | 勾选目标设备:Phone / Tablet / 2in1 / Car / Wearable / TV |
右侧预览区会实时展示当前模板的默认效果 —— 一个居中显示的 “Hello World” 文本。
1.4 完成创建
确认配置无误后,点击右下角 “完成” 按钮,IDE 将自动执行以下操作:
- 生成项目骨架(Stage 模型目录结构)
- 执行
ohpm install安装依赖 - 运行 Hvigor 构建初始化(
Build Init)
构建日志中显示 “退出代码为 0” 表示项目初始化成功。
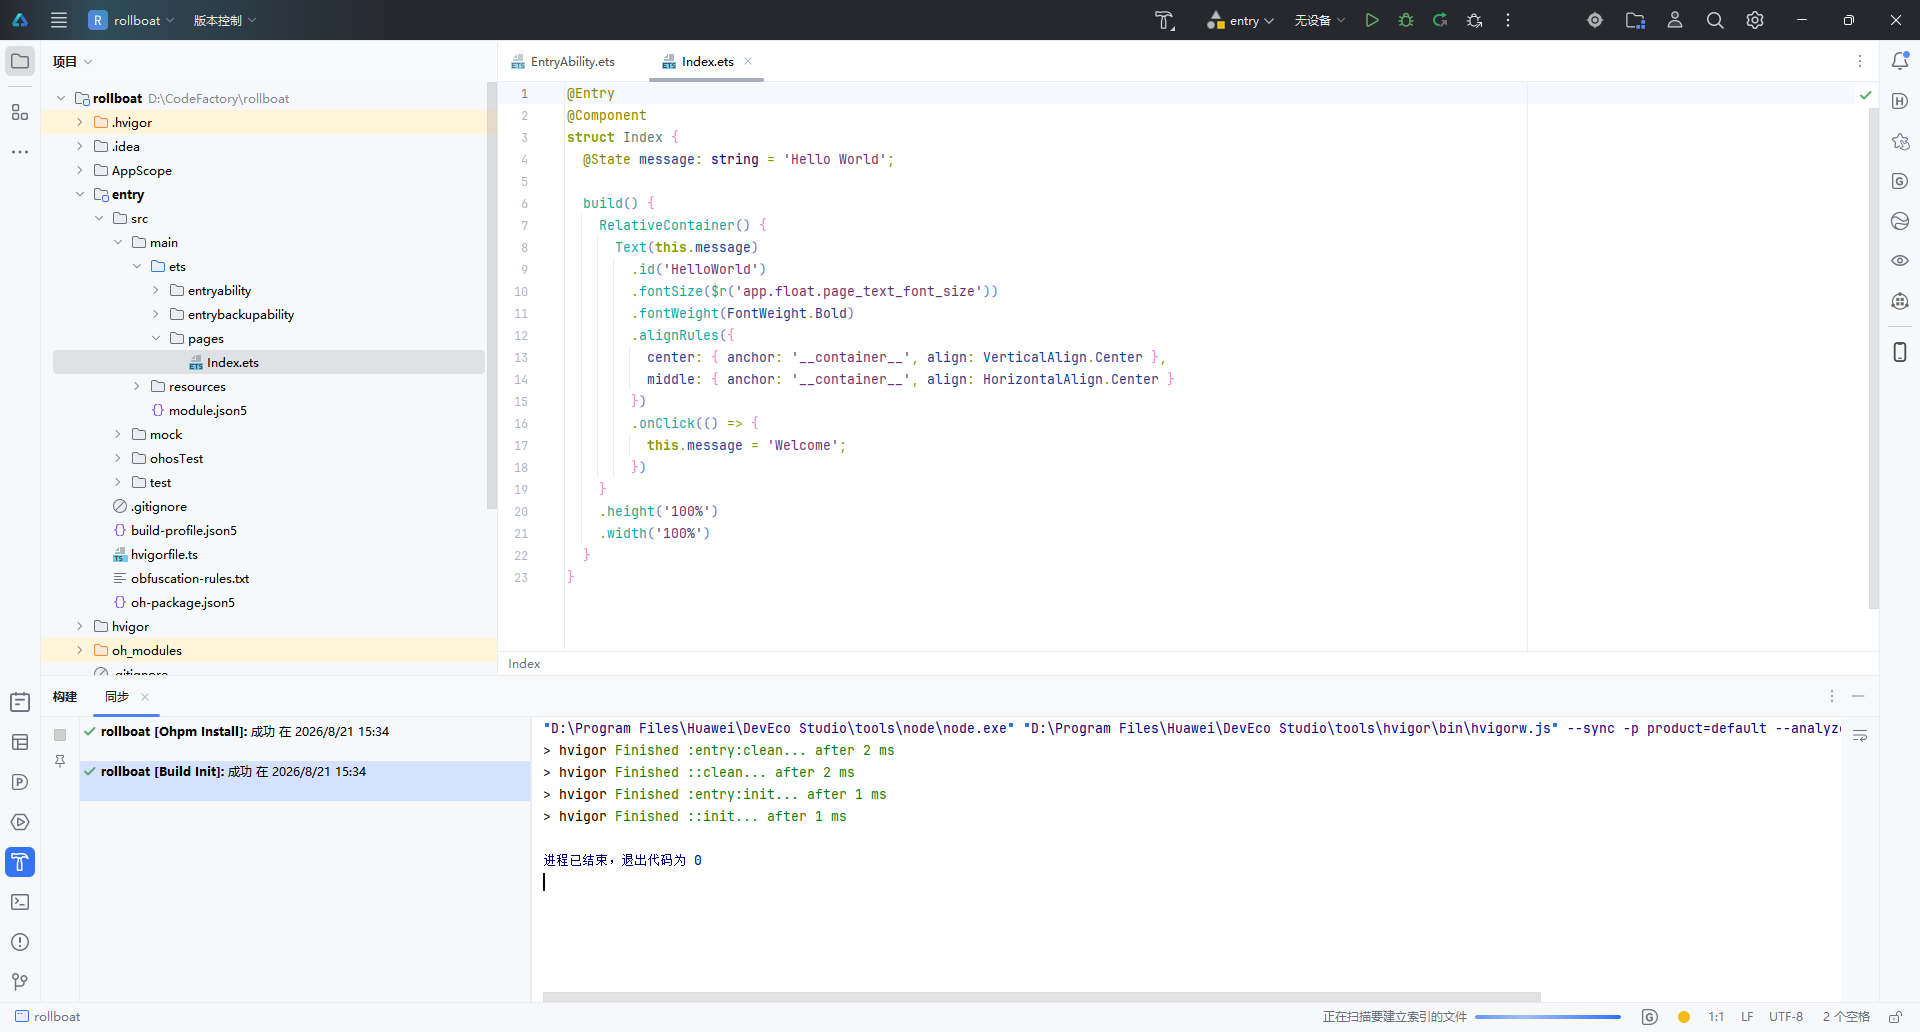
1.5 项目结构概览
创建完成后,左侧项目面板展示的是标准的 Stage 模型 目录结构:
rollboat/
├── .hvigor/                   # Hvigor 构建工具缓存
├── .idea/                     # IDE 配置文件
├── AppScope/                  # 应用级全局配置
│   └── app.json5
├── entry/                     # 主模块(入口模块)
│   ├── src/main/ets/
│   │   ├── entryability/      # Ability 生命周期管理
│   │   │   └── EntryAbility.ets
│   │   └── pages/             # UI 页面
│   │       └── Index.ets      # 首页(默认 Hello World)
│   ├── src/main/resources/    # 资源文件
│   ├── module.json5           # 模块配置
│   └── build-profile.json5    # 构建配置
├── oh_modules/                # OHPM 依赖包
├── build-profile.json5        # 工程构建配置
├── hvigorfile.ts              # Hvigor 构建脚本
└── oh-package.json5           # 包管理配置
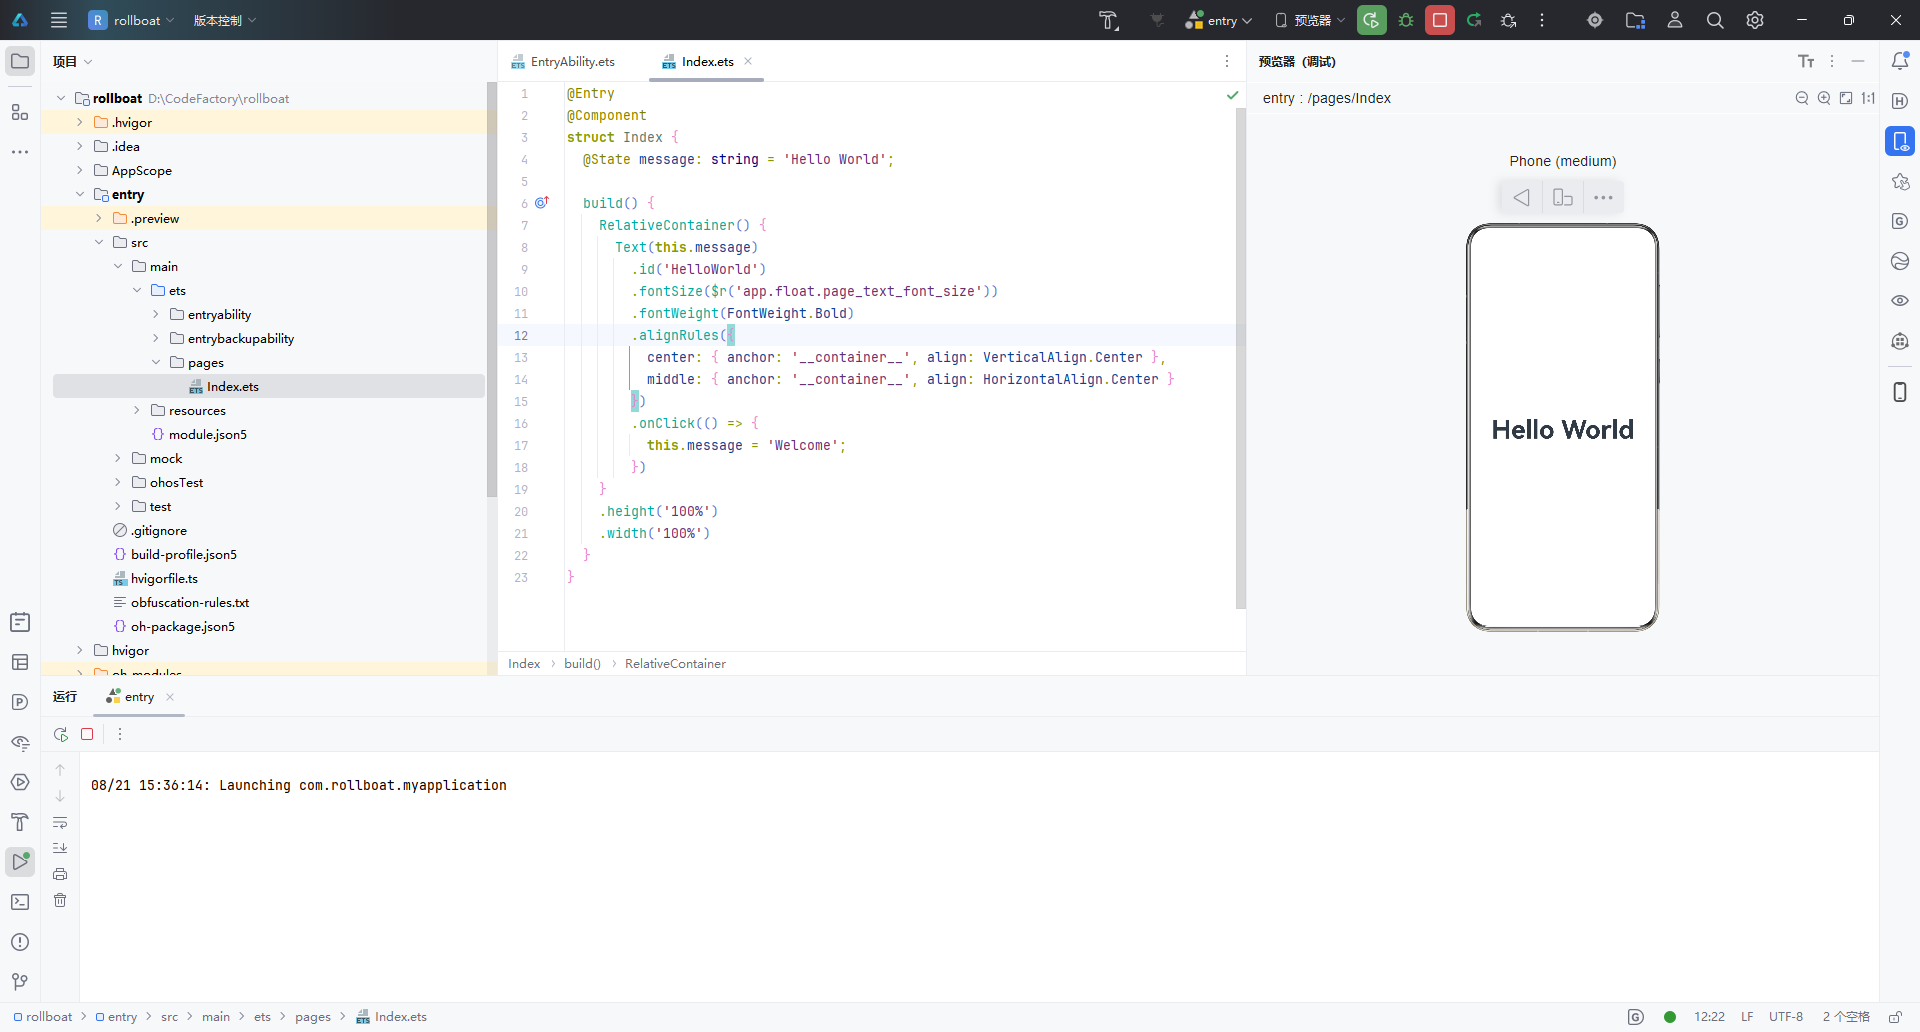
核心文件 Index.ets 的默认代码如下,采用 ArkTS 声明式 UI 语法:
@Entry
@Component
struct Index {
  @State message: string = 'Hello World';

  build() {
    RelativeContainer() {
      Text(this.message)
        .id('HelloWorld')
        .fontSize($r('app.float.page_text_font_size'))
        .fontWeight(FontWeight.Bold)
        .alignRules({
          center: { anchor: '__container__', align: VerticalAlign.Center },
          middle: { anchor: '__container__', align: HorizontalAlign.Center }
        })
        .onClick(() => {
          this.message = 'Welcome';
        })
    }
    .height('100%')
    .width('100%')
  }
}
| 关键语法 | 作用 |
|---|---|
@Entry | 标记为页面入口,可用于路由跳转 |
@Component | 声明为自定义组件 |
@State | 状态变量,数据变更时自动触发 UI 刷新 |
RelativeContainer | 相对布局容器,替代传统线性布局 |
.onClick() | 点击事件,此处点击后文本变为 “Welcome” |
打开右侧 Previewer(预览器),选择 Phone 设备,即可实时预览 Hello World 效果,无需连接真机或启动模拟器。
二、查看 SDK 版本
2.1 查看 HarmonyOS SDK
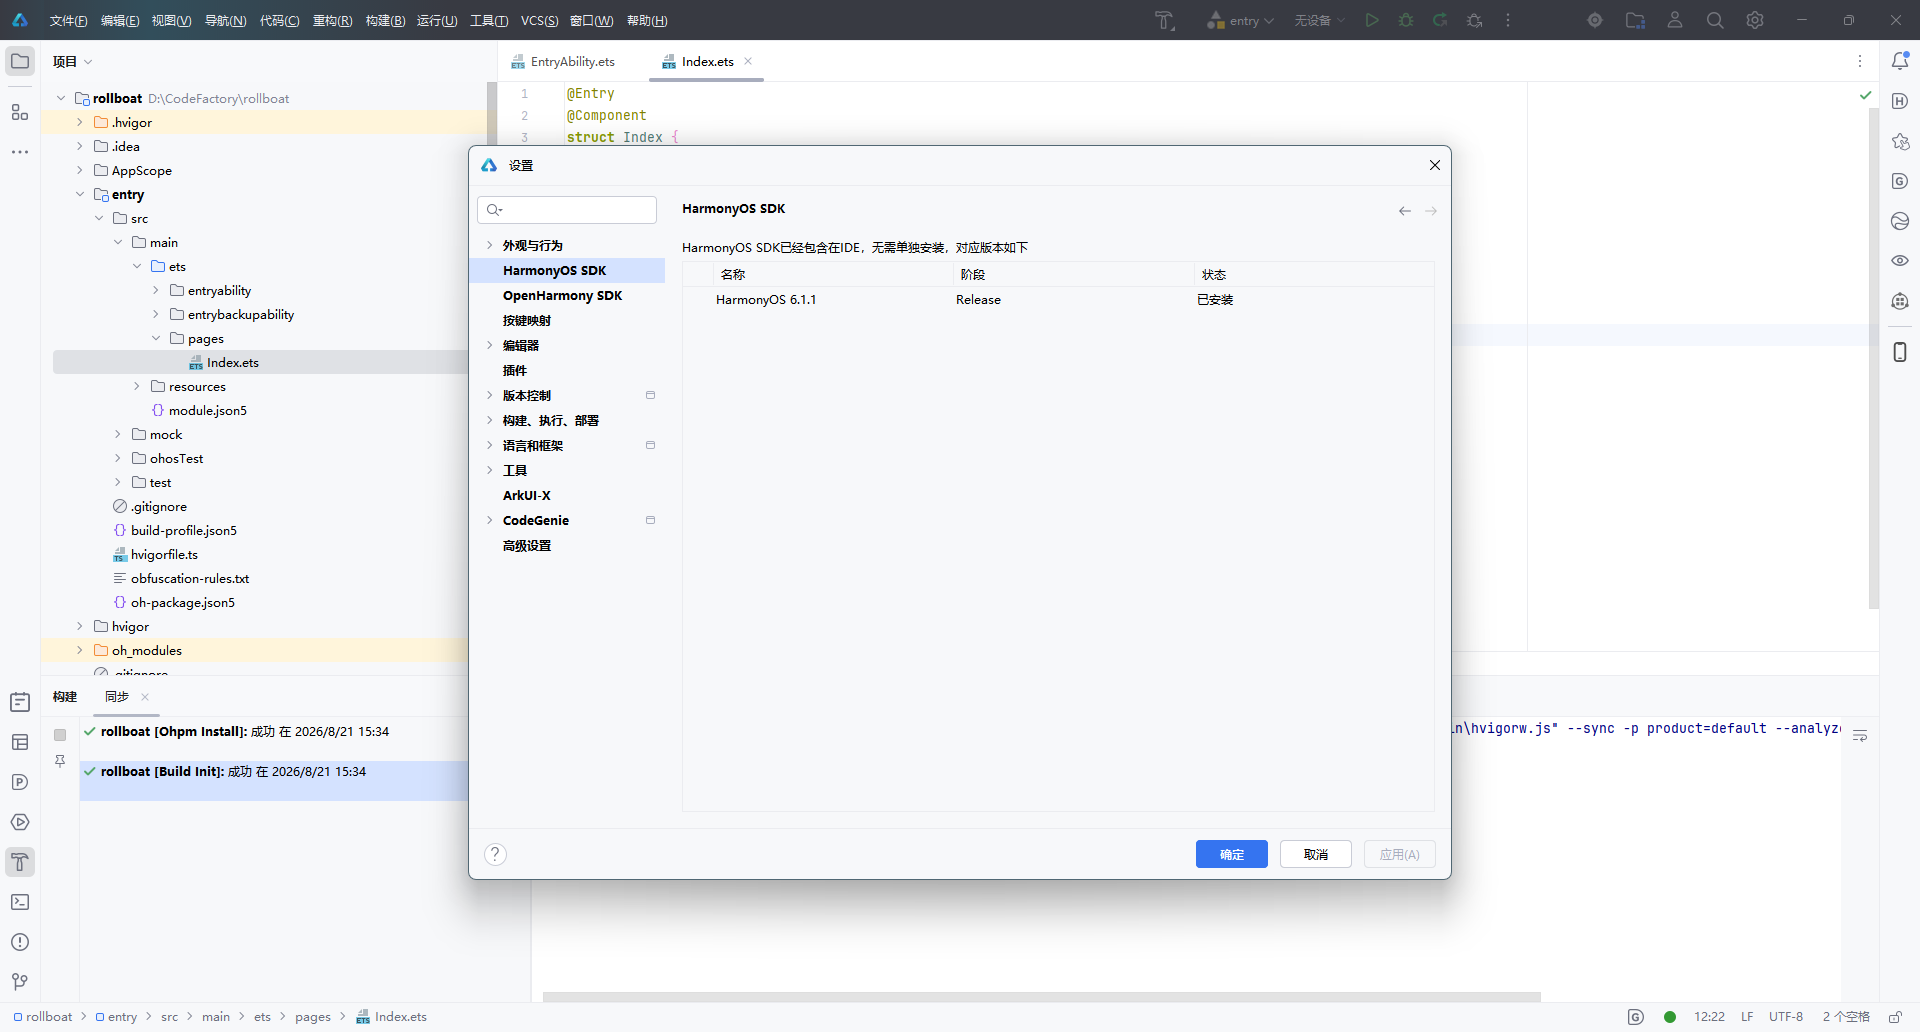
DevEco Studio 安装时已内置 HarmonyOS SDK,无需单独下载。通过以下路径查看:
文件 → 设置 → HarmonyOS SDK(或快捷键
Ctrl + Alt + S搜索 “HarmonyOS SDK”)
在设置面板中,可以看到当前已安装的 SDK 版本信息:
| 名称 | 阶段 | 状态 |
|---|---|---|
| HarmonyOS 6.1.1 | Release | ✅ 已安装 |
界面顶部提示:“HarmonyOS SDK 已经包含在 IDE,无需单独安装”,省去了手动配置 SDK 的繁琐步骤。
2.2 查看 ArkUI-X SDK(跨平台扩展)
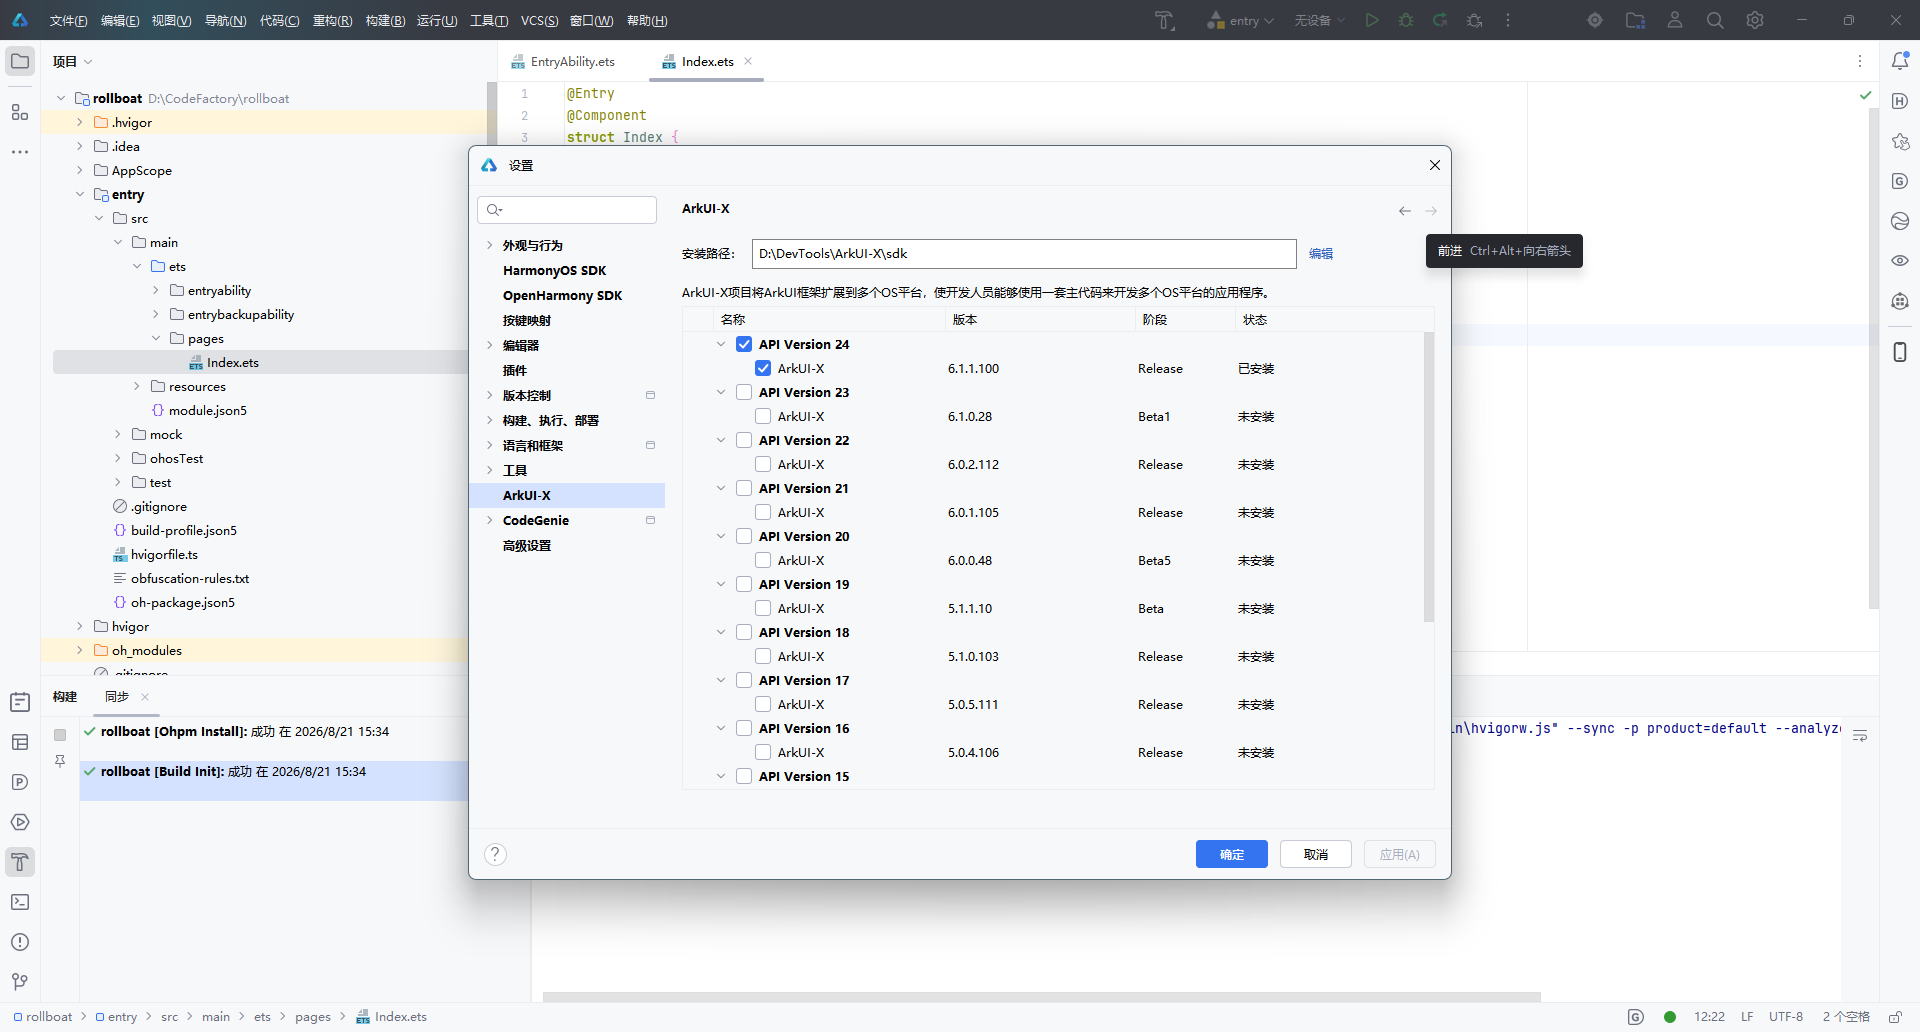
如果项目需要将 ArkUI 框架扩展到多个 OS 平台(Android / iOS / OpenHarmony),还需要配置 ArkUI-X SDK。路径如下:
文件 → 设置 → 语言和框架 → ArkUI-X
在这里可以查看已安装和可选的 ArkUI-X SDK 版本:
| 版本 | SDK 版本号 | 阶段 | 状态 |
|---|---|---|---|
| API Version 24 | 6.1.1.100 | Release | ✅ 已安装 |
| API Version 23 | 6.1.0.28 | Beta1 | 未安装 |
| API Version 22 | 6.0.2.112 | Release | 未安装 |
安装路径示例:D:\DevTools\ArkUI-X\sdk
说明:ArkUI-X 允许开发者使用一套 ArkTS 主代码,同时构建多平台应用。如果仅开发 HarmonyOS 原生应用,无需额外安装 ArkUI-X SDK。
三、小结
| 步骤 | 操作 | 关键点 |
|---|---|---|
| 创建项目 | 欢迎页 → 新建项目 → 选择 Empty Ability 模板 → 配置项目信息 → 完成 | 使用 Stage 模型 + ArkTS 语言 |
| 查看 SDK | 设置 → HarmonyOS SDK | SDK 已内置,无需手动安装 |
| 跨平台扩展 | 设置 → ArkUI-X | 根据需要安装对应 API 版本 |
至此,DevEco Studio 的项目创建与 SDK 环境确认全部完成,可以开始 HarmonyOS 应用的功能开发。
本文基于 DevEco Studio 6.1.1 Release 版本编写,不同版本界面可能存在细微差异。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 11
 0
- 0


 已为社区贡献20条内容

所有评论(0)