HarmonyOS 文件 I/O 性能优化:分片读写、偏移与资源关闭
HarmonyOS 文件 I/O 性能优化:分片读写、偏移与资源关闭
复制一个几百 MiB 的离线地图包时,最危险的实现不是“速度稍慢”,而是一次性把整个文件读进内存,再假设一次 read 或 write 一定处理完所有字节。真实 I/O 可能出现短读、短写、目标空间不足、页面退出和文件打开到一半失败。任何一个分支没有闭合,都会留下不完整文件或未关闭的文件描述符。
本文以应用沙箱内的大文件复制为例,使用 Core File Kit 的 fileIo,从路径约束、打开模式、分片循环、字节偏移到异常清理逐层实现。目标不是给出一个“能复制”的函数,而是得到一条能够核对字节数、限制内存峰值、失败后可解释的文件处理链路。
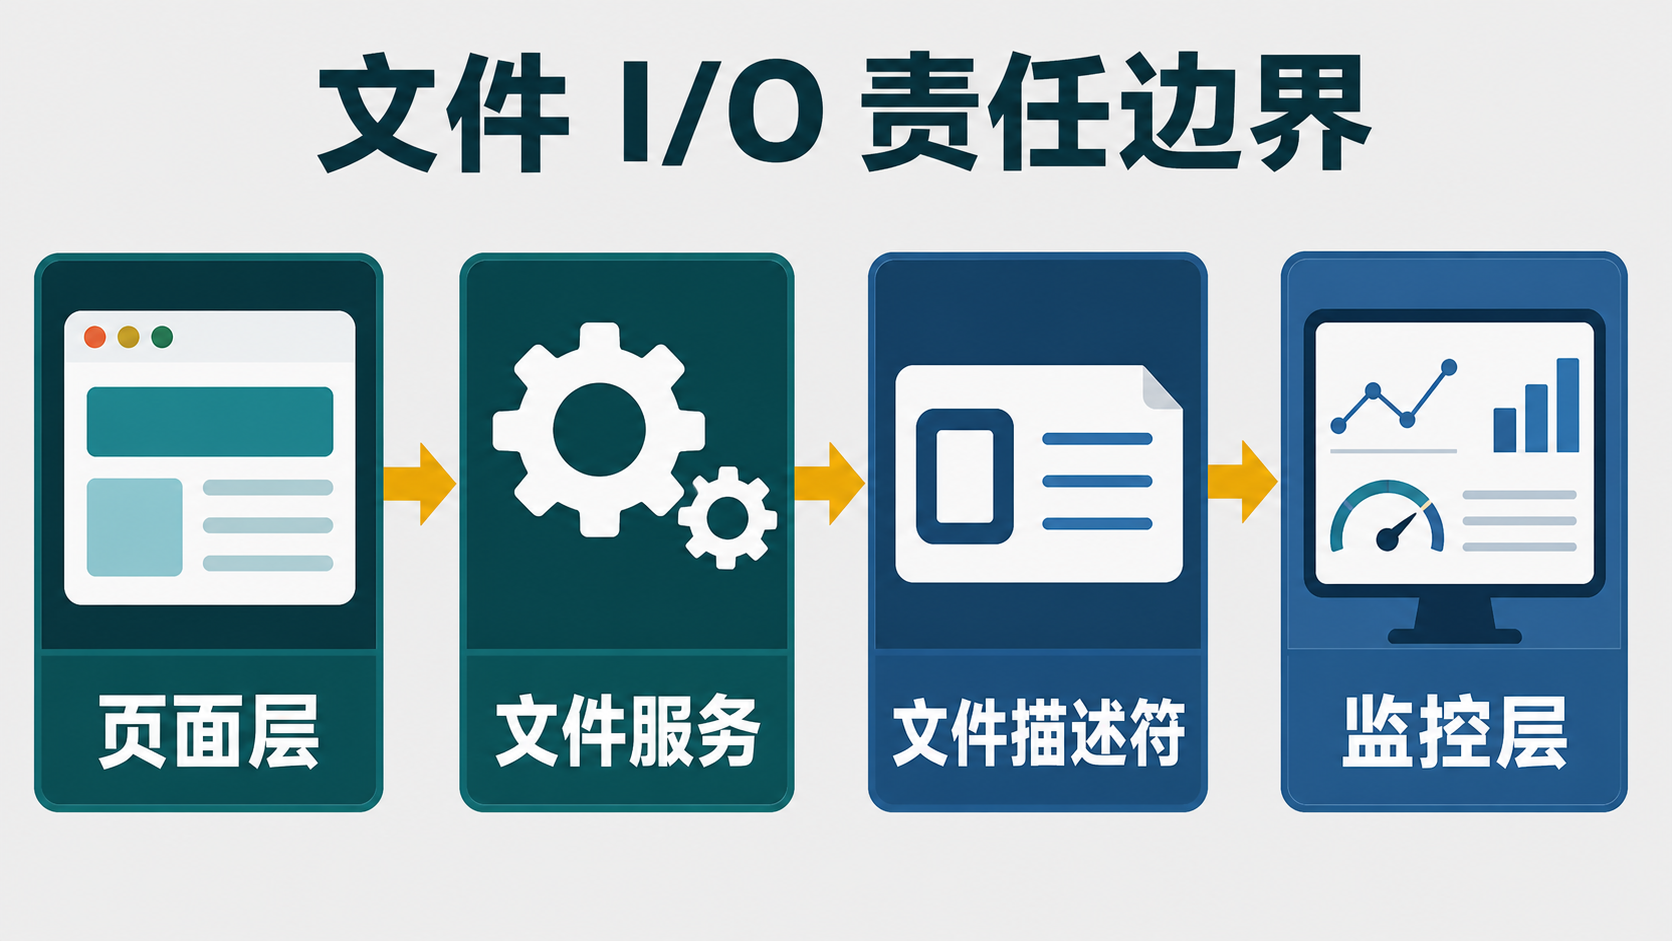
一、先把一次性读取从设计里移除
下面这种思路在小文件上看不出问题:先读取全部内容,再一次写到目标文件。文件越大,峰值内存越接近文件体积;如果为了转换又创建副本,峰值还会进一步增加。
更稳的目标是:
- 内存中只保留一个固定大小的缓冲区;
- 每次处理实际读取到的字节数;
- 写入端处理短写,而不是默认一次完成;
- 只有源文件到达 EOF 且累计字节一致时才宣布成功;
- 无论哪个步骤抛错,都关闭已经打开的文件。
分片大小并非越大越好。较大缓冲区减少系统调用次数,较小缓冲区降低单次内存占用和取消延迟,需要在目标设备上比较。
二、环境、导入与路径边界
| 项目 | 本文基线 |
|---|---|
| 开发模型 | Stage 模型 |
| 文件接口 | Core File Kit |
| 导入 | import { fileIo } from '@kit.CoreFileKit' |
| 异步打开 | fileIo.open(path, mode) |
| 异步读写 | fileIo.read、fileIo.write |
| 关闭 | fileIo.close(file) |
| 应用路径 | Context.filesDir 等沙箱目录 |
| 核对 SDK | HarmonyOS SDK API 23 |
本文只处理应用拥有访问权的沙箱文件。用户选择的公共文件、媒体 URI、分布式文件或其他应用数据需要对应的授权和文件访问方案,不能把外部 URI 当成本地路径直接传给 open。
先构造受控路径,文件名只能来自可信标识:
import { common } from '@kit.AbilityKit'

function buildSandboxFile(
  context: common.Context,
  safeName: string
): string {
  if (!/^[a-zA-Z0-9._-]+$/.test(safeName)) {
    throw new Error('文件名包含不允许的字符')
  }
  return context.filesDir + '/' + safeName
}
这里拒绝斜杠和路径跳转字符,避免调用方把目标写到预期目录之外。真实项目还要限制名称长度,并按业务生成文件名,不要直接采用网络响应里的原始名称。
三、把处理流程拆成五个可核验阶段
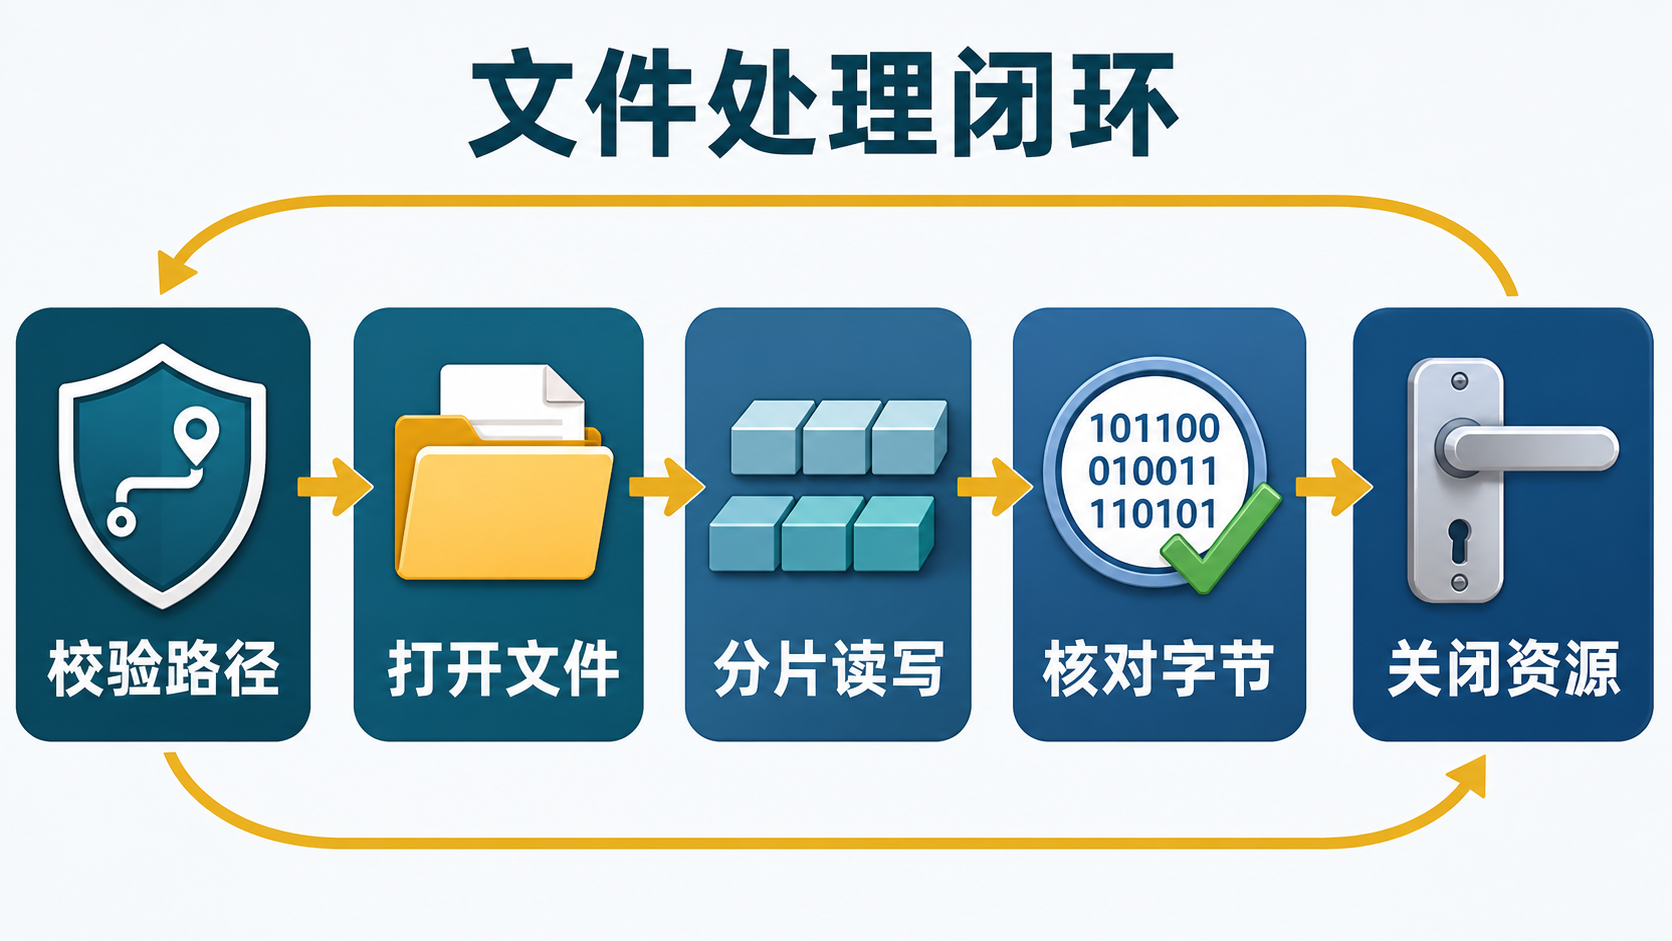
复制任务可分为:校验源目标路径、打开源文件、固定缓冲区分片读写、核对累计字节、关闭两个资源。每个阶段只接受上一阶段已经确认的结果。
定义进度和最终报告:
interface CopyProgress {
  copiedBytes: number
  sourceBytes: number
  percent: number
}

interface CopyReport {
  sourcePath: string
  targetPath: string
  copiedBytes: number
  elapsedMs: number
}

function makeProgress(
  copiedBytes: number,
  sourceBytes: number
): CopyProgress {
  const percent = sourceBytes === 0
    ? 100
    : Math.min(100, Math.floor(copiedBytes * 100 / sourceBytes))
  return { copiedBytes, sourceBytes, percent }
}
进度使用累计字节而不是循环次数,因为最后一块通常小于缓冲区。空文件被视为 100%,但仍需实际创建目标文件并完成关闭。
四、打开模式必须表达覆盖还是追加
复制操作通常希望覆盖旧目标,因此目标文件使用“只写、必要时创建、截断旧内容”的组合。源文件只读:
import { fileIo } from '@kit.CoreFileKit'

async function openSource(path: string): Promise<fileIo.File> {
  return await fileIo.open(path, fileIo.OpenMode.READ_ONLY)
}

async function openTarget(path: string): Promise<fileIo.File> {
  const mode = fileIo.OpenMode.WRITE_ONLY |
    fileIo.OpenMode.CREATE |
    fileIo.OpenMode.TRUNC
  return await fileIo.open(path, mode)
}
如果业务要断点续传,不能继续使用 TRUNC,而应先验证临时文件长度、来源版本和摘要,再从明确偏移继续。追加模式也不等于断点续传:旧文件可能来自另一份数据,盲目追加会生成不可用文件。
五、read 返回的是实际字节数,不是缓冲区大小
到达文件尾部时,read 返回值可能小于缓冲区长度,返回 0 表示没有更多数据。处理函数只读取有效范围:
async function readChunk(
  file: fileIo.File,
  buffer: ArrayBuffer,
  offset: number
): Promise<ArrayBuffer | undefined> {
  const readBytes = await fileIo.read(
    file.fd,
    buffer,
    {
      offset,
      length: buffer.byteLength
    }
  )

  if (readBytes === 0) {
    return undefined
  }
  if (readBytes < 0 || readBytes > buffer.byteLength) {
    throw new Error('读取接口返回了非法字节数:' + readBytes)
  }
  return buffer.slice(0, readBytes)
}
buffer.slice 为当前有效数据创建独立范围,避免把缓冲区尾部的旧内容写入目标文件。追求更低复制成本时可以调整写入封装以使用长度选项,但必须以当前 SDK 的 WriteOptions 定义为准,并继续保证只写有效字节。
六、write 也可能只写入一部分
可靠写入器循环处理剩余数据,直到全部写完:
async function writeAll(
  file: fileIo.File,
  data: ArrayBuffer,
  fileOffset: number
): Promise<number> {
  let consumed = 0

  while (consumed < data.byteLength) {
    const remaining = data.slice(consumed)
    const written = await fileIo.write(
      file.fd,
      remaining,
      {
        offset: fileOffset + consumed,
        length: remaining.byteLength
      }
    )
    if (written <= 0 || written > remaining.byteLength) {
      throw new Error('写入接口返回了非法字节数:' + written)
    }
    consumed += written
  }
  return consumed
}
这个循环同时维护“缓冲区已消费位置”和“目标文件偏移”。如果只增加文件偏移却每次传入完整缓冲区,短写发生后会重复写前半段;如果只切缓冲区却固定文件偏移,则会覆盖已写内容。
七、双文件资源需要一个共同的 finally
源文件打开成功、目标文件打开失败时,也必须关闭源文件。可以让两个变量在共同的 finally 中独立判断:
async function closeQuietly(file?: fileIo.File): Promise<void> {
  if (!file) {
    return
  }
  try {
    await fileIo.close(file)
  } catch (error) {
    console.error('close file failed')
  }
}

async function withCopyFiles<T>(
  sourcePath: string,
  targetPath: string,
  action: (source: fileIo.File, target: fileIo.File) => Promise<T>
): Promise<T> {
  let source: fileIo.File | undefined
  let target: fileIo.File | undefined
  try {
    source = await openSource(sourcePath)
    target = await openTarget(targetPath)
    return await action(source, target)
  } finally {
    await closeQuietly(target)
    await closeQuietly(source)
  }
}
关闭目标放在源之前,便于先结束写入端。closeQuietly 不应让关闭错误覆盖原始复制错误,但应通过可观测渠道记录;如果复制本身成功而关闭失败,调用方仍应把任务视为需要复核,不能悄悄宣布文件可用。
八、组合成固定内存上限的复制器
const DEFAULT_CHUNK_BYTES = 256 * 1024

async function copyLargeFile(
  sourcePath: string,
  targetPath: string,
  sourceBytes: number,
  onProgress: (progress: CopyProgress) => void,
  chunkBytes: number = DEFAULT_CHUNK_BYTES
): Promise<CopyReport> {
  if (sourcePath === targetPath) {
    throw new Error('源文件与目标文件不能相同')
  }
  if (sourceBytes < 0 || chunkBytes <= 0) {
    throw new Error('文件大小或分片大小不合法')
  }

  const startedAt = Date.now()
  const copiedBytes = await withCopyFiles(
    sourcePath,
    targetPath,
    async (source, target) => {
      const buffer = new ArrayBuffer(chunkBytes)
      let offset = 0

      while (true) {
        const chunk = await readChunk(source, buffer, offset)
        if (!chunk) {
          break
        }
        const written = await writeAll(target, chunk, offset)
        offset += written
        onProgress(makeProgress(offset, sourceBytes))
      }
      return offset
    }
  )

  if (copiedBytes !== sourceBytes) {
    throw new Error(
      '复制字节数不一致:源=' + sourceBytes + ',目标=' + copiedBytes
    )
  }
  return {
    sourcePath,
    targetPath,
    copiedBytes,
    elapsedMs: Date.now() - startedAt
  }
}
调用方提供的 sourceBytes 必须来自可信的文件属性查询,而不是网络声明值。复制结束后再比较累计字节;若不一致,目标文件只能留在临时区,不能覆盖正式文件。
九、采用“临时文件 + 校验 + 替换”避免半成品被读取
直接写正式路径时,其他页面可能读到只完成一半的文件。更稳的发布过程是:
正式文件:map_package.bin
临时文件:map_package.bin.part

1. 所有分片先写入 .part
2. 核对长度与摘要
3. 关闭临时文件
4. 原子能力允许时再替换正式文件
5. 失败则保留或删除 .part,不暴露为正式结果
临时文件名要与任务 ID 绑定,避免两个并发任务写同一 .part。替换前若要删除旧文件,应确认平台提供的移动/重命名语义和当前文件系统边界;不要先删除正式文件,再开始漫长复制。
定义任务路径:
interface CopyPaths {
  finalPath: string
  tempPath: string
}

function buildCopyPaths(finalPath: string, jobId: string): CopyPaths {
  if (!/^[a-zA-Z0-9_-]+$/.test(jobId)) {
    throw new Error('jobId 不合法')
  }
  return {
    finalPath,
    tempPath: finalPath + '.' + jobId + '.part'
  }
}
任务失败后,临时文件可用于受控恢复,但必须附带源摘要、已完成偏移和任务版本。没有这些元数据时,删除临时文件重新开始通常比盲目续写更安全。
十、进度更新要节流,不能每个小块都触发重绘
256 KiB 分片复制大文件时可能产生数千次回调。可以按时间或百分比节流:
class ProgressThrottle {
  private lastPercent: number = -1
  private lastTime: number = 0

  shouldEmit(progress: CopyProgress): boolean {
    const now = Date.now()
    const percentChanged = progress.percent !== this.lastPercent
    const waitedLongEnough = now - this.lastTime >= 200
    const finished = progress.percent === 100

    if ((percentChanged && waitedLongEnough) || finished) {
      this.lastPercent = progress.percent
      this.lastTime = now
      return true
    }
    return false
  }
}
节流只影响 UI 通知,不影响真实累计字节和最终核验。复制服务仍然处理每个分片,页面最多每 200 ms 接收一次可见更新。
十一、取消检查点应放在分片边界
文件接口不一定能强行取消已经发出的单次读写,但复制循环可以在下一分片前停止:
class CopyCancellation {
  private canceled: boolean = false

  cancel(): void {
    this.canceled = true
  }

  throwIfCanceled(): void {
    if (this.canceled) {
      throw new Error('FILE_COPY_CANCELED')
    }
  }
}
在 while 循环每次读取前调用 throwIfCanceled。分片越大,取消响应通常越慢;分片越小,系统调用次数越多。因此取消体验也是选择分片大小的一个指标。
用户取消后不要把临时文件直接改名为正式文件。产品可选择删除临时文件,或保留受版本校验保护的断点数据。
十二、不要在 UI 线程调用大文件同步接口
异步 open/read/write/close 不会要求页面线程等待整个文件完成。同步接口适合极小且确定的配置操作,不适合大文件循环。即使异步接口内部处理高效,页面仍需避免这些行为:
- 在每个分片后做大量 JSON 序列化;
- 每个分片更新多个
@State字段; - 同时启动多个不受限的大文件任务;
- 在复制循环内计算高成本摘要却不做任务调度;
- 页面退出后继续向已失效组件回写进度。
文件 I/O、摘要计算和 UI 状态是三个不同责任边界。大摘要计算可按数据特点使用 TaskPool,但不能让同一缓冲区在所有权未明确时同时被读写。
十三、错误处理要保留可恢复信息
| 现象 | 首要原因 | 应记录的信息 | 恢复方式 |
|---|---|---|---|
| 打开源文件失败 | 路径不存在或无权限 | 受控路径、错误码 | 重新选择或重新下载 |
| 目标打开失败 | 空间、路径、模式错误 | 剩余空间、目标目录 | 清理空间后重试 |
read 返回异常值 | 描述符或参数问题 | 偏移、缓冲区长度 | 关闭任务并复核源文件 |
write 短写 | 系统只接受部分数据 | 已消费字节、文件偏移 | writeAll 继续剩余部分 |
| 复制后长度不一致 | 源变化或循环错误 | 源长度、累计长度 | 禁止发布临时文件 |
| 关闭失败 | 描述符状态异常 | 文件角色、错误码 | 标记任务需复核 |
日志中可以记录经过脱敏的任务 ID、偏移和字节数,不要记录用户完整路径或文件内容。
十四、验证时要主动制造边界场景
建议准备以下样本:
- 0 字节空文件;
- 小于一个分片的文件;
- 刚好等于分片大小的文件;
- 比分片大 1 字节的文件;
- 数百 MiB 的常规大文件;
- 复制过程中触发取消;
- 目标空间不足;
- 源文件在复制期间被替换或改变。
每个样本至少核对源目标字节数和摘要。摘要算法与文件内容规模有关,计算过程也应分片,不要为了“校验”再次一次性读取完整文件。
function assertCopyReport(
  report: CopyReport,
  expectedBytes: number
): void {
  if (report.copiedBytes !== expectedBytes) {
    throw new Error('CopyReport 字节数不符合预期')
  }
  if (report.elapsedMs < 0) {
    throw new Error('耗时记录不合法')
  }
}
十五、交付前核对表
- 路径来自应用沙箱或已授权文件访问流程。
- 外部输入不能通过
../或斜杠跳出目标目录。 - 源文件使用只读模式,目标覆盖明确使用
CREATE | TRUNC。 - 读取端只处理
read返回的实际字节数。 - 写入端支持短写,并同时推进缓冲区和文件偏移。
- 源目标文件在共同的
finally中独立关闭。 - 正式文件不会暴露半成品,复制先写临时路径。
- 进度按累计字节计算并进行 UI 节流。
- 取消只在安全分片边界停止,并正确处理临时文件。
- 空文件、边界长度、大文件、空间不足和取消均已验证。
总结
大文件 I/O 的稳定性来自一组小而明确的约束:固定内存上限,按实际读取字节处理;把短写当作正常边界,用偏移循环完成剩余数据;资源打开到哪一步,就在统一的 finally 中关闭到哪一步;正式结果只在临时文件完成长度与摘要核验后发布。这样即使任务被取消或存储异常,应用也能知道已处理多少、留下了什么、下一次能否继续。
参考资料
- 华为开发者文档:应用文件访问
- HarmonyOS SDK API 23:
@ohos.file.fs.d.ts
官方文件访问文档用于确认应用沙箱与外部文件的能力边界,本地 SDK 声明用于核对 Promise 形式的 open/read/write/close 以及读写选项。公共文件 URI、媒体文件和跨设备文件应采用各自的授权与访问方案,不能直接套用本文的沙箱路径示例。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 7
 0
- 0


 已为社区贡献239条内容

所有评论(0)