HarmonyOS Node-API 跨语言性能优化:ArrayBuffer、异步任务与生命周期
HarmonyOS Node-API 跨语言性能优化:ArrayBuffer、异步任务与生命周期
ArkTS 调用 C++ 并不自动变快。如果把十万个数拆成十万次跨语言函数调用,边界转换的成本可能比计算本身更高;如果在主线程里直接执行重计算,原生代码同样会卡住界面;如果异步任务仍然引用已经失效的缓冲指针,问题会进一步变成随机崩溃。
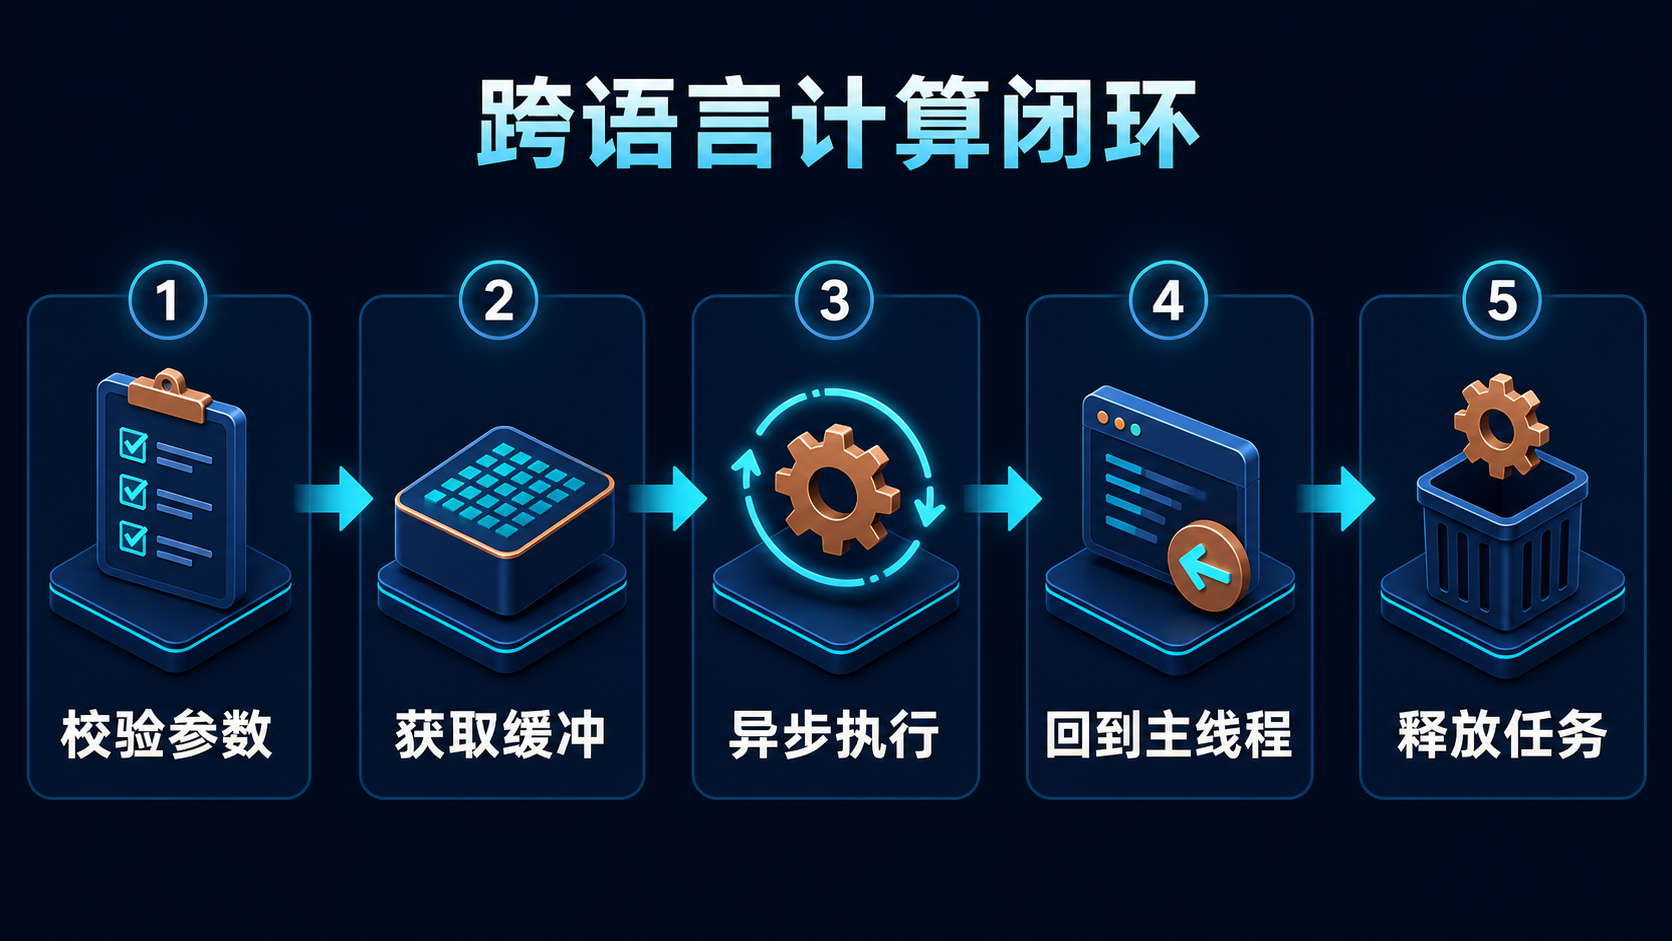
本文实现一个批量归一化示例:ArkTS 用 ArrayBuffer 一次传入整块 Int32Array 数据,Node-API 在主线程完成参数校验和数据快照,把纯 C++ 计算排入异步工作队列,最后回到原线程创建返回值并兑现 Promise。示例重点不在算法复杂度,而在跨语言责任边界是否正确。
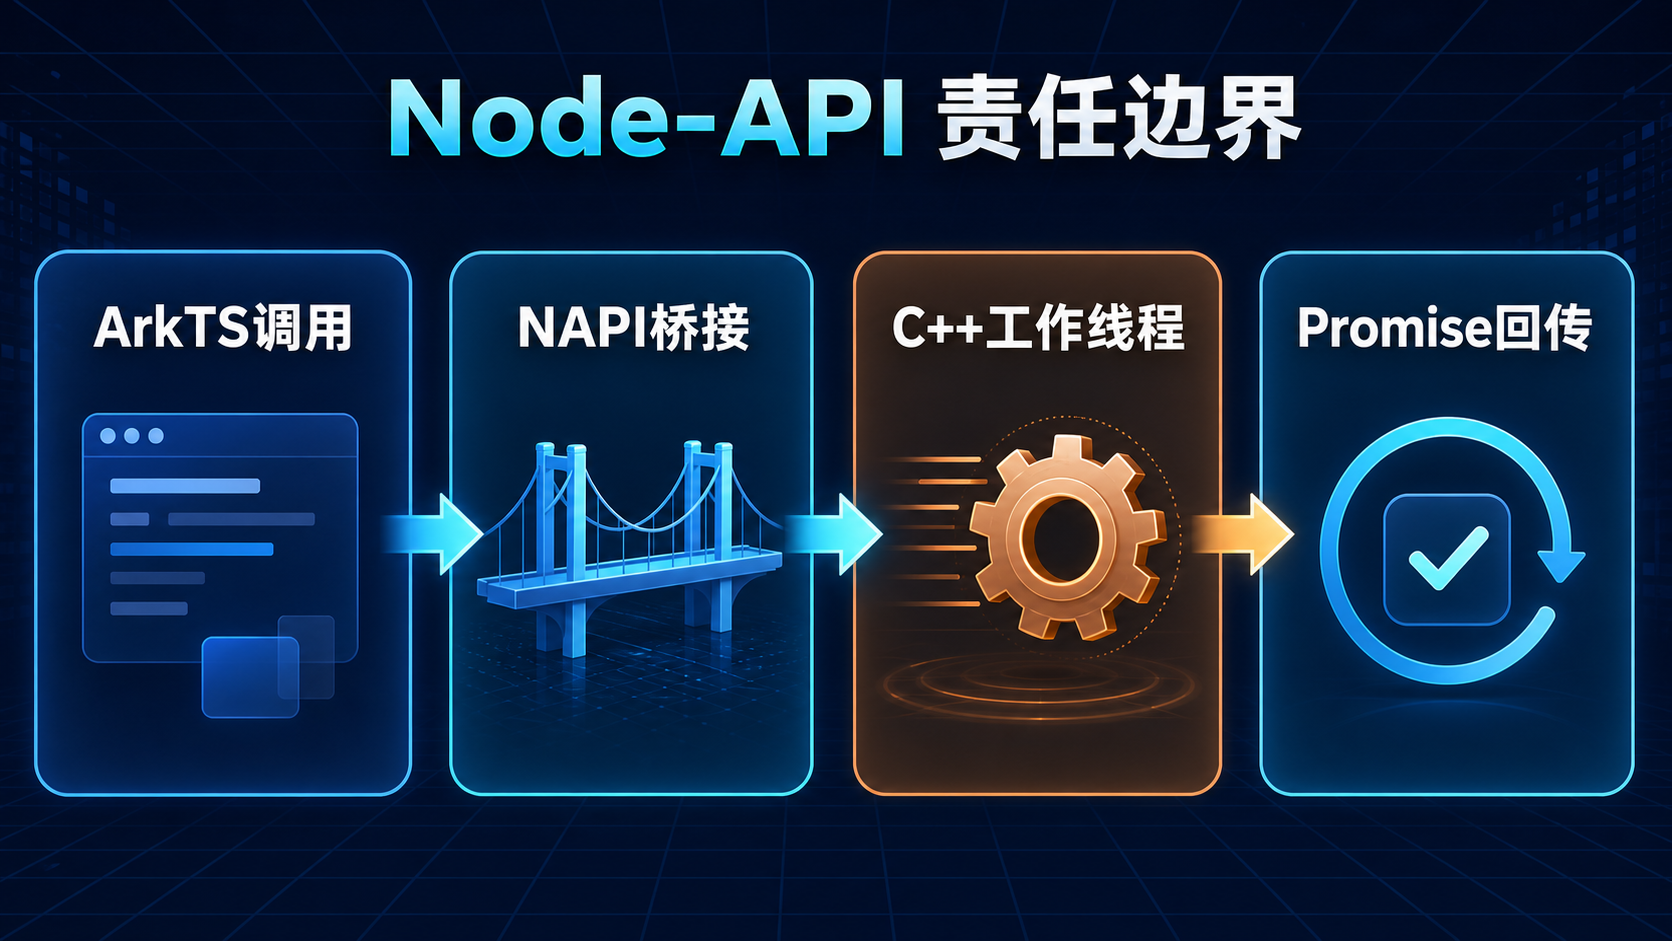
一、先判断任务是否值得下沉到原生层
适合 Node-API 的工作通常具备以下特征:
- 计算量足够大,边界成本相对较小;
- 数据可以批量传输,而不是逐元素回调;
- 算法已有可靠 C/C++ 实现或需要原生库;
- 工作过程不依赖 ArkUI 组件和 ArkTS 对象;
- 可以明确输入、输出、错误和释放时机。
简单字符串拼接、少量字段转换或单个加法没有必要进入原生层。跨语言层应是粗粒度业务能力,而不是把每一行 ArkTS 都包装成 C++ 函数。
二、设计一个窄而稳定的接口
本文只暴露一个函数:输入 ArrayBuffer,返回 Promise<ArrayBuffer>。ArkTS 类型声明放在 entry/src/main/cpp/types/libentry/index.d.ts:
export const normalizeInt32:
  (input: ArrayBuffer) => Promise<ArrayBuffer>
这种接口有三个优点:
- 一次传入整块连续数据,减少跨语言次数;
- Promise 清楚表达任务不是同步完成;
- 输出仍是缓冲区,调用方可以选择
Int32Array、Uint8Array等视图解释。
接口契约还应写明元素类型、字节序、空输入行为、数值范围和失败类型。仅写 ArrayBuffer 并不能说明里面装的是什么。
三、ArkTS 侧只负责组织输入和消费结果
import { normalizeInt32 } from 'libentry.so'

export async function normalizeScores(
  values: number[]
): Promise<Int32Array> {
  const input = Int32Array.from(values)
  const outputBuffer = await normalizeInt32(input.buffer)
  return new Int32Array(outputBuffer)
}
调用方不要逐个元素调用原生方法:
// 不建议:边界往返次数与元素数量相同。
for (const value of values) {
  result.push(nativeNormalizeOne(value))
}
一次调用处理一批数据,通常比“更小的原生函数”更有意义。批量大小也不是越大越好,超大输入会增加复制、等待和峰值内存,需要结合业务分片。
四、CMake只链接必要的Node-API库
entry/src/main/cpp/CMakeLists.txt 保持依赖最小:
cmake_minimum_required(VERSION 3.5.0)
project(NodeApiBatchDemo)

set(NATIVERENDER_ROOT_PATH ${CMAKE_CURRENT_SOURCE_DIR})

add_library(entry SHARED napi_init.cpp)
target_link_libraries(entry PUBLIC libace_napi.z.so)
如果计算逻辑拆到独立源文件,再显式加入 add_library。不要为了一个简单任务链接无关图形、媒体或网络库,否则会增加构建、包体和维护成本。
五、异步上下文要拥有自己的数据
通过 napi_get_arraybuffer_info() 获得的指针由 JavaScript 引擎管理,不能 delete 或 free。更重要的是,异步工作排队后,原始 ArkTS 缓冲区的生命周期和并发修改都需要谨慎处理。
本文选择在创建任务的线程中复制一份输入,使工作线程只依赖 C++ 自有内存:
#include <algorithm>
#include <cstdint>
#include <cstring>
#include <limits>
#include <string>
#include <vector>
#include "napi/native_api.h"

struct NormalizeContext {
    napi_async_work work = nullptr;
    napi_deferred deferred = nullptr;
    std::vector<int32_t> input;
    std::vector<int32_t> output;
    std::string error;
};
这次复制有成本,但换来了明确的所有权和线程安全。如果业务要进一步减少复制,需要用引用保持输入对象存活,并严格评估工作期间调用方是否会修改底层数据,复杂度明显更高。
六、参数校验必须在排队前完成
主线程回调中先取得参数,确认是 ArrayBuffer,再检查字节长度是否能被 int32_t 整除:
static bool ReadInt32Buffer(
    napi_env env,
    napi_callback_info info,
    std::vector<int32_t>& output)
{
    size_t argc = 1;
    napi_value argv[1] = { nullptr };
    if (napi_get_cb_info(env, info, &argc, argv, nullptr, nullptr)
        != napi_ok || argc != 1) {
        napi_throw_type_error(env, nullptr, "Expected one ArrayBuffer");
        return false;
    }

    bool isArrayBuffer = false;
    if (napi_is_arraybuffer(env, argv[0], &isArrayBuffer) != napi_ok ||
        !isArrayBuffer) {
        napi_throw_type_error(env, nullptr, "Input must be ArrayBuffer");
        return false;
    }

    void* raw = nullptr;
    size_t byteLength = 0;
    if (napi_get_arraybuffer_info(env, argv[0], &raw, &byteLength)
        != napi_ok) {
        napi_throw_error(env, nullptr, "Cannot read ArrayBuffer");
        return false;
    }

    if (byteLength % sizeof(int32_t) != 0) {
        napi_throw_range_error(env, nullptr, "Invalid Int32 byte length");
        return false;
    }

    if (byteLength == 0) {
        output.clear();
        return true;
    }
    if (raw == nullptr) {
        napi_throw_error(env, nullptr, "ArrayBuffer data is null");
        return false;
    }

    const auto* begin = static_cast<const int32_t*>(raw);
    output.assign(begin, begin + byteLength / sizeof(int32_t));
    return true;
}
当 byteLength 为 0 时,不应对空指针执行无意义运算。正式实现可以把空输入直接返回空缓冲,或者按接口契约拒绝;无论选择哪一种,都要固定行为。
七、工作线程只运行纯C++计算
napi_create_async_work() 的 execute 回调运行在工作线程。这里不能使用原来的 env 创建 napi_value,也不要触碰 ArkUI 状态。
static void ExecuteNormalize(napi_env env, void* data)
{
    auto* context = static_cast<NormalizeContext*>(data);
    if (context->input.empty()) {
        context->output.clear();
        return;
    }

    const auto [minIt, maxIt] = std::minmax_element(
        context->input.begin(), context->input.end());
    const int64_t minValue = *minIt;
    const int64_t maxValue = *maxIt;
    const int64_t range = maxValue - minValue;

    context->output.resize(context->input.size());
    if (range == 0) {
        std::fill(context->output.begin(), context->output.end(), 0);
        return;
    }

    for (size_t i = 0; i < context->input.size(); ++i) {
        const int64_t shifted =
            static_cast<int64_t>(context->input[i]) - minValue;
        context->output[i] =
            static_cast<int32_t>((shifted * 1000) / range);
    }
}
中间计算使用 int64_t,避免 int32_t 相减和乘法溢出。算法选择和边界类型同样属于接口正确性,不应因为代码进入 C++ 就忽略。
八、完成回调负责创建返回值和释放任务
complete 回调回到原 ArkTS 线程,可以创建 ArrayBuffer、兑现 Promise,并删除异步工作。输出缓冲由引擎创建,C++ 只把结果复制进去:
static napi_value CreateError(napi_env env, const std::string& message)
{
    napi_value text = nullptr;
    napi_value error = nullptr;
    napi_create_string_utf8(
        env, message.c_str(), message.size(), &text);
    napi_create_error(env, nullptr, text, &error);
    return error;
}

static void CompleteNormalize(
    napi_env env,
    napi_status status,
    void* data)
{
    auto* context = static_cast<NormalizeContext*>(data);

    if (status != napi_ok || !context->error.empty()) {
        const std::string message = context->error.empty()
            ? "Async work failed"
            : context->error;
        napi_reject_deferred(
            env, context->deferred, CreateError(env, message));
    } else {
        void* outputData = nullptr;
        napi_value arrayBuffer = nullptr;
        const size_t bytes =
            context->output.size() * sizeof(int32_t);

        if (napi_create_arraybuffer(
            env, bytes, &outputData, &arrayBuffer) == napi_ok) {
            if (bytes > 0) {
                std::memcpy(outputData, context->output.data(), bytes);
            }
            napi_resolve_deferred(env, context->deferred, arrayBuffer);
        } else {
            napi_reject_deferred(
                env,
                context->deferred,
                CreateError(env, "Cannot create output ArrayBuffer"));
        }
    }

    napi_delete_async_work(env, context->work);
    delete context;
}
napi_delete_async_work() 只调用一次,context 也只释放一次。输入指针来自引擎时从未手工释放,复制后的 std::vector 则随上下文析构。
九、创建Promise、任务并处理排队失败
入口函数把前面几段连接起来:
static napi_value NormalizeInt32(
    napi_env env,
    napi_callback_info info)
{
    auto* context = new NormalizeContext();
    if (!ReadInt32Buffer(env, info, context->input)) {
        delete context;
        return nullptr;
    }

    napi_value promise = nullptr;
    if (napi_create_promise(env, &context->deferred, &promise) != napi_ok) {
        delete context;
        napi_throw_error(env, nullptr, "Cannot create Promise");
        return nullptr;
    }

    napi_value resourceName = nullptr;
    napi_create_string_utf8(
        env,
        "NormalizeInt32",
        NAPI_AUTO_LENGTH,
        &resourceName);

    napi_status status = napi_create_async_work(
        env,
        nullptr,
        resourceName,
        ExecuteNormalize,
        CompleteNormalize,
        context,
        &context->work);

    if (status != napi_ok) {
        napi_reject_deferred(
            env,
            context->deferred,
            CreateError(env, "Cannot create async work"));
        delete context;
        return promise;
    }

    status = napi_queue_async_work(env, context->work);
    if (status != napi_ok) {
        napi_delete_async_work(env, context->work);
        napi_reject_deferred(
            env,
            context->deferred,
            CreateError(env, "Cannot queue async work"));
        delete context;
    }
    return promise;
}
创建失败与排队失败是两条不同清理路径:前者还没有有效 work,后者已经创建但没有执行,需要先删除 work。任何提前返回都要核对上下文、Promise 和 work 各自由谁负责。
十、注册导出函数时保持名称一致
static napi_value Init(napi_env env, napi_value exports)
{
    napi_property_descriptor properties[] = {
        {
            "normalizeInt32",
            nullptr,
            NormalizeInt32,
            nullptr,
            nullptr,
            nullptr,
            napi_default,
            nullptr
        }
    };
    napi_define_properties(
        env,
        exports,
        sizeof(properties) / sizeof(properties[0]),
        properties);
    return exports;
}

EXTERN_C_START
static napi_module entryModule = {
    .nm_version = 1,
    .nm_flags = 0,
    .nm_filename = nullptr,
    .nm_register_func = Init,
    .nm_modname = "entry",
    .nm_priv = nullptr,
    .reserved = { 0 }
};
EXTERN_C_END

extern "C" __attribute__((constructor))
void RegisterEntryModule(void)
{
    napi_module_register(&entryModule);
}
nm_modname、生成的共享库名、类型声明目录和 ArkTS import 必须对应。出现“模块能加载但找不到函数”时,先逐项核对这四个名称,不要先怀疑计算逻辑。
十一、为什么这里没有在工作线程直接使用输入指针
napi_get_arraybuffer_info() 返回数据地址和长度,但地址所有权仍属于引擎。异步任务至少要回答两个问题:
- 工作执行期间,ArrayBuffer 如何保持可达并且不被回收?
- ArkTS 是否可能同时修改同一块缓冲,形成数据竞争?
复制输入把这两个问题转换成明确的 C++ 所有权,适合多数中等规模计算。若数据巨大且复制成为主要成本,可考虑更高级的零拷贝方案,但必须同时设计引用生命周期、只读约束、并发访问和异常清理,不能只删除 memcpy 就称为零拷贝。
十二、批量大小需要在延迟和吞吐之间取舍
单次 100 个元素时,异步调度可能比计算本身更贵;单次几千万个元素时,复制和等待又可能造成峰值内存过高。可以对多个批量做基准:
async function benchmarkBatch(size: number): Promise<number> {
  const input = new Int32Array(size)
  for (let i = 0; i < size; i++) {
    input[i] = (i * 17) % 10000
  }

  const start = Date.now()
  await normalizeInt32(input.buffer)
  return Date.now() - start
}
至少测试 1K、10K、100K 和业务真实上限,并分别记录总耗时、主线程响应、峰值内存和并发任务数。不要用 Debug 单次结果决定 Release 策略。
十三、为并发任务设置入口限流
异步不代表资源无限。如果用户快速重复点按,多个大任务会同时复制输入并占用工作队列。ArkTS 服务层可以限制同一业务只运行一个任务:
class NativeNormalizeService {
  private running: boolean = false

  async execute(input: Int32Array): Promise<Int32Array> {
    if (this.running) {
      throw new Error('A normalize task is already running')
    }
    this.running = true
    try {
      const result = await normalizeInt32(input.buffer)
      return new Int32Array(result)
    } finally {
      this.running = false
    }
  }
}
需要并行时,应根据 CPU、任务长度和内存预算设置上限,并定义排队、取消和页面离开后的结果处理规则。
十四、正确性用边界数据验证
至少覆盖:
1. 空数组
2. 单元素数组
3. 所有元素相同
4. 正数与负数混合
5. INT32_MIN 与 INT32_MAX
6. 字节长度不是4的倍数
7. 传入非ArrayBuffer
8. 连续并发调用
9. 页面离开后任务完成
10. 原生任务创建或排队失败
归一化结果还要和一份 ArkTS 参考实现逐项比较。性能优化不能改变算法语义,尤其要关注整数溢出、除零、舍入方式和输出字节解释。
十五、上线前生命周期清单
- 接口按批传输,不在循环中频繁跨语言调用;
-
ArrayBuffer的元素类型、字节长度和空输入行为已写入契约; - 引擎拥有的输入指针从未被
delete或free; - 工作线程只访问 C++ 自有数据,不创建
napi_value; - Promise 的 resolve/reject 只发生一次;
- create、queue、execute、complete 每条失败路径都能释放资源;
-
napi_delete_async_work()与上下文析构各执行一次; - 并发入口有限流,超大输入有分片或上限;
- Release 真机比较边界次数、总耗时、主线程响应和峰值内存;
- 边界数据结果与 ArkTS 参考算法一致。
十六、性能来自清晰的跨语言边界
Node-API 性能优化首先是边界设计,其次才是 C++ 算法。用 ArrayBuffer 把大量元素合并成一次调用,用异步工作把纯计算移出 ArkTS 主线程,再让完成回调负责创建结果和释放任务,三层责任才真正闭合。
示例主动复制输入,是在性能与可证明生命周期之间做出的保守选择。只有基准数据证明复制已经成为瓶颈,并且团队能完整处理引用、并发和异常时,才值得进入更复杂的共享内存方案。
Node-API资料索引

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 9
 0
- 0


 已为社区贡献239条内容

所有评论(0)