灯光模拟HarmonyOS应用实战-59-生成1000题不代表规则都覆盖:用RuleId与场景维度建立覆盖账本
灯光模拟HarmonyOS应用实战-59-生成1000题不代表规则都覆盖:用RuleId与场景维度建立覆盖账本
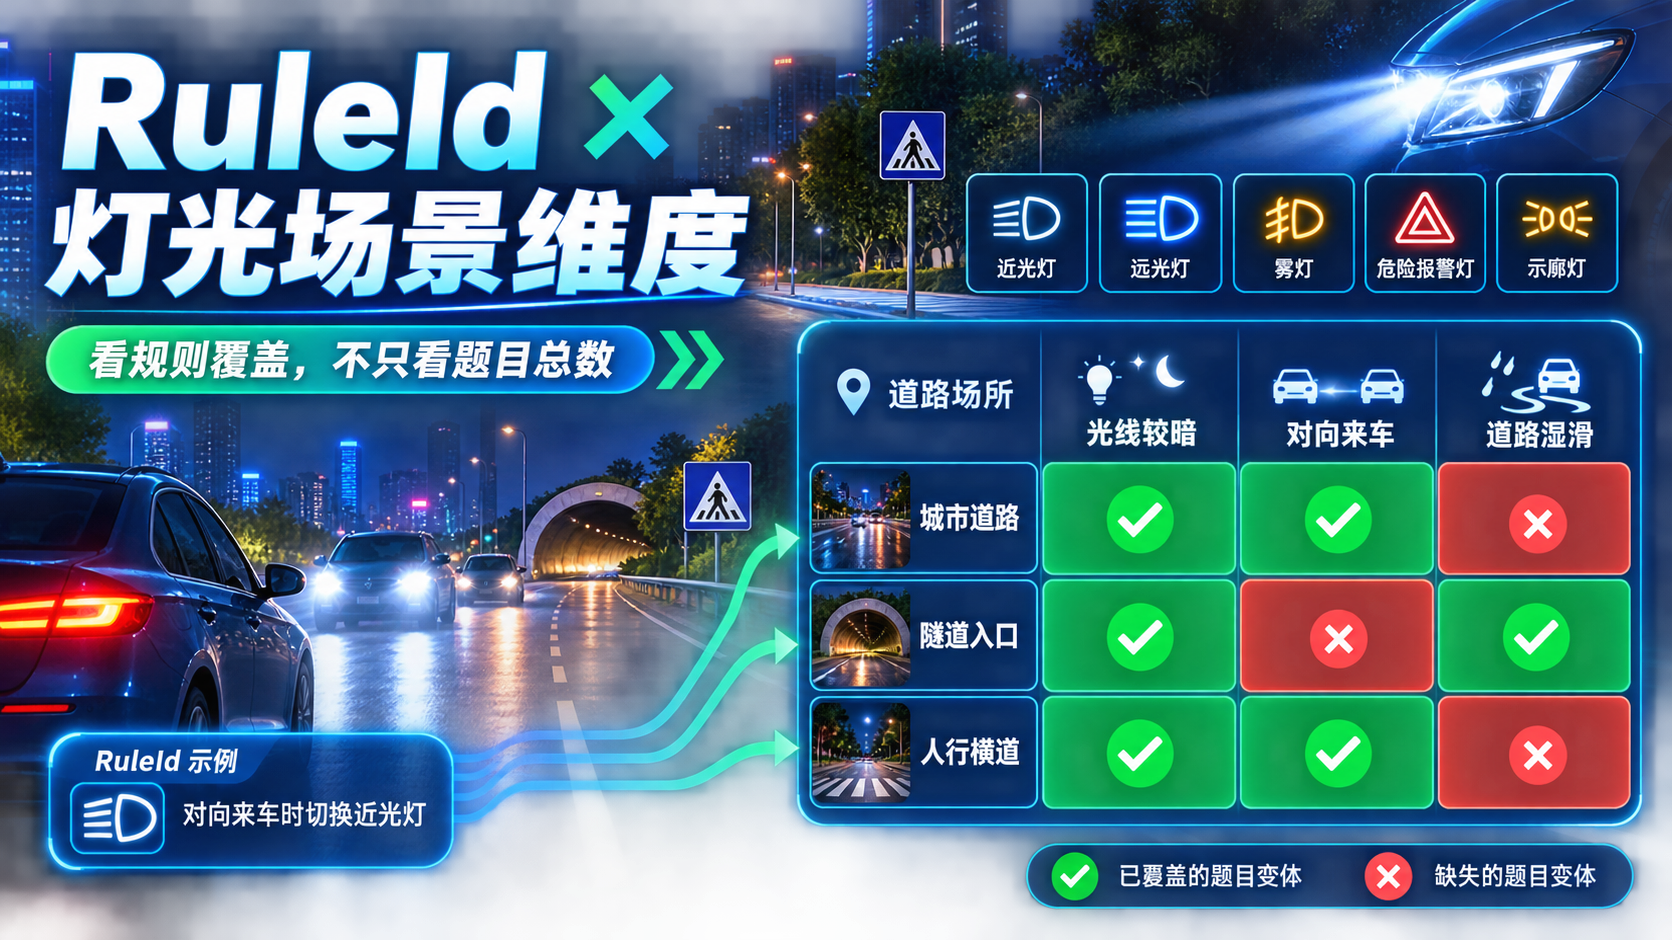
批量生成题库很容易给人一种安全感:科二和科四各生成1000题,列表足够长,搜索也能找到许多不同道路与条件。可是题目数量回答的是“产出了多少条记录”,不是“覆盖了多少条驾驶规则”。同一条“会车时切换近光灯”可以在几十种地点和条件下反复改写,数量不断增加;与此同时,另一条灯光规则可能一次都没有进入生成链。
The_kemusan 当前生成种子保存分类、场景、正确项、三个干扰项和解析,变体文本由道路地点与驾驶条件组合而来,最后通过循环索引选择种子。生成结果没有显式携带规则身份和维度值,因此发布前很难直接回答:哪些规则已经覆盖,哪些道路场所缺题,哪些条件组合只是题干换词。本文建立 RuleId、批准的场景维度和覆盖账本,把题目总数留作容量指标,把规则与场景覆盖单独核算。
一、当前种子描述题面内容,没有描述规则身份
QuestionBank.ets 第286—294行的 GeneratedQuestionSeed 包含 category、scenario、正确文本、三个错误文本和 explanation。这些字段足以生成一题,却无法稳定指出该题对应哪条业务规则。两条种子可能描述同一规则,也可能使用相似场景但要求不同动作。
interface GeneratedQuestionSeed {
  category: string;
  scenario: string;
  correct: string;
  wrongOne: string;
  wrongTwo: string;
  wrongThree: string;
  explanation: string;
}

const GENERATED_SUBJECT_COUNT: number = 1000;
scenario 是面向读者的自然语言,不适合充当稳定键。修改“夜间通过人行横道前”为“夜间接近人行横道时”,规则没有变化,字符串却变了。反过来,相同句子在不同科目中也可能承担不同教学目标。覆盖统计若以题干、解析或数组下标分组,会把编辑调整误认成规则新增或删除。
| 字段 | 当前用途 | 能否稳定衡量规则 | 原因 |
|---|---|---|---|
category | 题库筛选 | 不能 | 一个分类包含多条规则 |
scenario | 生成题干主体 | 不适合 | 文案可改,也可能近似重复 |
explanation | 复盘说明 | 不适合 | 允许改写且可能合并多点 |
| 种子数组下标 | 循环取种子 | 不能 | 插入或排序后位置变化 |
| 生成题总数 | 控制容量 | 不能 | 同一规则可产生大量变体 |
二、索引循环会把数量与覆盖混在一起
第567—582行先用 index 计算 round,每8个索引才切换一次地点与条件;第674—690行又用 index % seeds.length 选择种子,并生成 ${prefix}_${index + 1}。这两个周期叠在一起,最后出现哪些“种子 × 地点 × 条件”组合取决于数组长度、数字8和总生成数的共同关系。
function buildVariantText(index: number): string {
  const round = Math.floor(index / 8);
  const place = VARIANT_PLACES[round % VARIANT_PLACES.length];
  const condition = VARIANT_CONDITIONS[
    Math.floor(round / VARIANT_PLACES.length) % VARIANT_CONDITIONS.length
  ];
  return `${place}、${condition}`;
}

const seed = seeds[index % seeds.length];
const title = buildGeneratedTitle(subject, seed, index);
不能仅凭1000大于“种子数 × 地点数 × 条件数”就断言全部组合出现,因为这里不是三层独立枚举。即使数学上某个周期最终遍历到全部余数组合,业务上也仍缺少明确证据:哪些组合被批准、哪些组合不适用、每条规则期望覆盖几种场景、生成后是否被去重逻辑移除。
更可靠的方式是先定义期望覆盖集合,再让生成器按集合出题;生成数量应是集合与变体策略的结果,而不是覆盖结论的替代品。
三、RuleId只表达驾驶规则,不绑定题目措辞
给种子增加稳定规则标识。命名可以采用科目、规则域和动作语义组合,但一经发布就不应因文案润色而改变。
type LightingRuleId =
  | 'S2_ICON_LOW_BEAM_MEANING'
  | 'S2_PRECHECK_CLEAR_HIGH_BEAM'
  | 'S2_NIGHT_CROSSWALK_SIGNAL'
  | 'S4_ONCOMING_USE_LOW_BEAM'
  | 'S4_FOG_USE_WARNING_LIGHTS';

interface LightingRuleSeed {
  ruleId: LightingRuleId;
  subject: string;
  category: string;
  scenarioText: string;
  expectedAction: string;
  distractors: string[];
  explanation: string;
}
ruleId 负责回答“这道题在考哪条规则”,不负责区分同一规则生成的每一道题。后者属于题目身份,第61篇会单独处理。把两者分开很重要:覆盖账本可以把一百个题目身份归到同一 ruleId,而错题历史仍能定位其中某个具体变体。
规则目录还应附带维护人可读说明、启用状态和适用维度集合。不要把删除种子当作删除规则;停用规则需要留下迁移记录,说明历史引用和旧报告如何解释。
四、场景维度要使用稳定键而不是展示文本
当前地点数组包含城市主干道、隧道入口附近、人行横道附近等文本,条件数组包含光线较暗、对向来车较多、道路湿滑等文本。展示文本可以继续用于题干,但覆盖键应更稳定。
type PlaceId =
  | 'CITY_ARTERIAL'
  | 'TUNNEL_ENTRANCE'
  | 'CROSSWALK_APPROACH'
  | 'CURVED_ROAD'
  | 'SCHOOL_FRONT';

type ConditionId =
  | 'LOW_LIGHT'
  | 'ONCOMING_TRAFFIC'
  | 'WET_ROAD'
  | 'DENSE_FLOW'
  | 'PEDESTRIANS_PRESENT';

interface ScenarioDimension {
  placeId: PlaceId;
  placeText: string;
  conditionId: ConditionId;
  conditionText: string;
}
稳定键用于聚合,中文文本用于出题。这样“隧道入口附近”改成“接近隧道入口”不会让历史覆盖突然归零。地点与条件也不应无限自由组合:例如某条图标认知规则可能与道路地点无关,强行扩展全部地点只会制造没有教学价值的句子。
因此,规则目录需要为每条 ruleId 声明适用维度策略,可以是具体组合列表,也可以是带约束的生成函数。覆盖目标来自这份批准列表,不来自两个全局数组的笛卡尔积。
五、先建立期望单元格,再按单元格生成题目
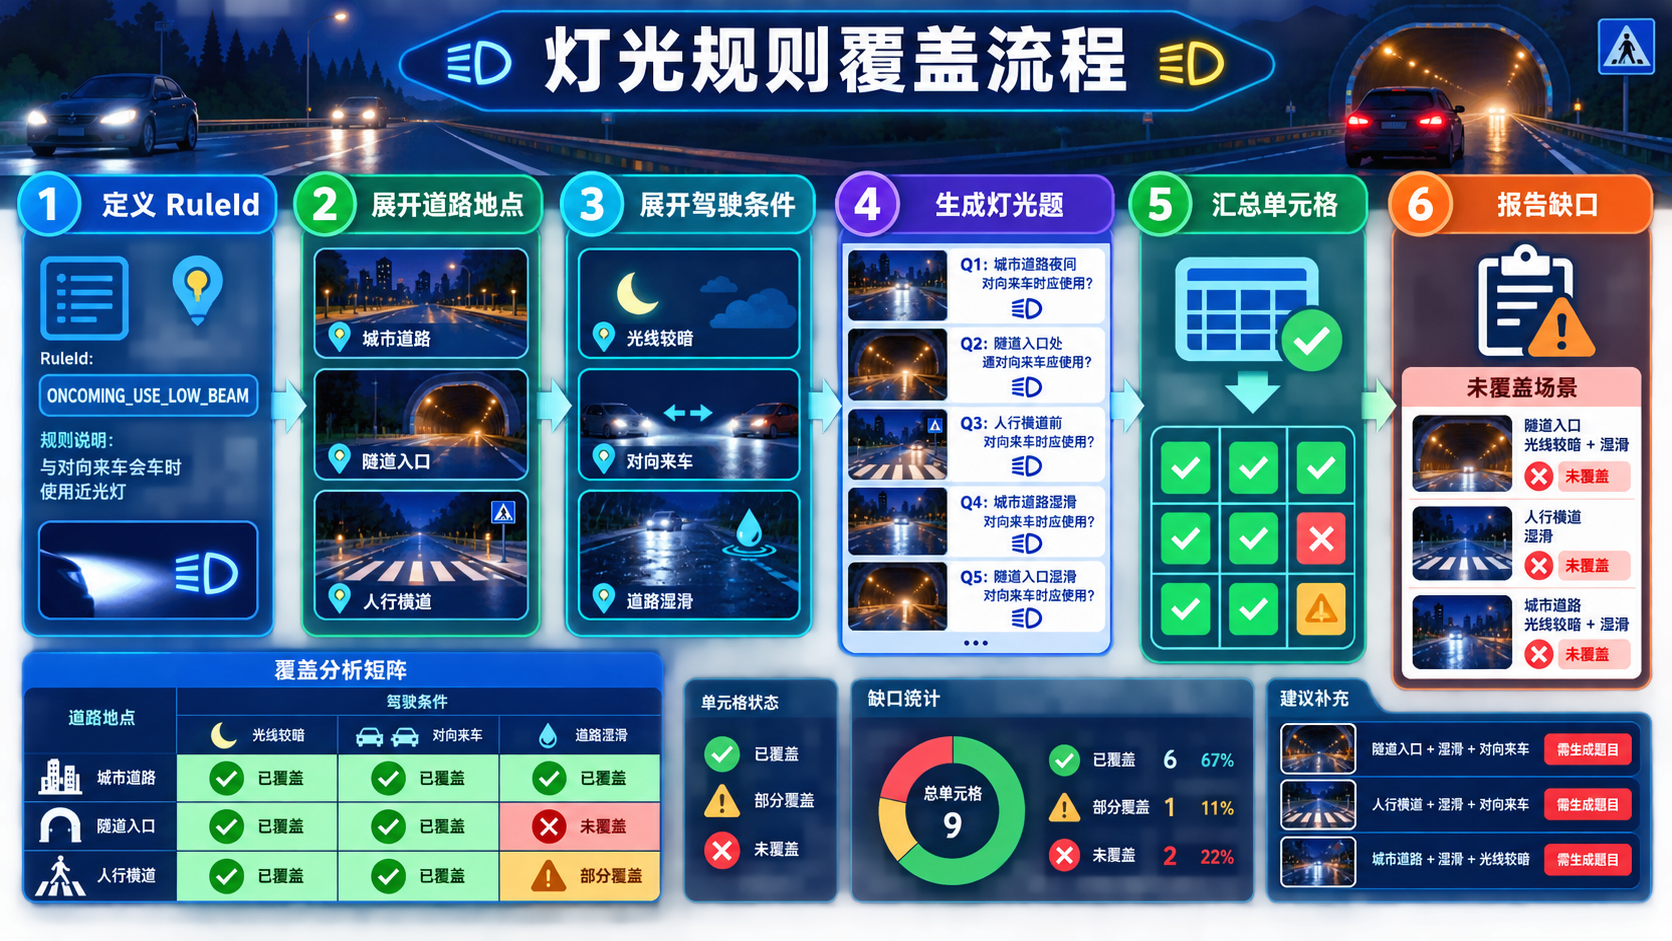
把一个覆盖单元格定义为 ruleId + placeId + conditionId。生成前先取得本批应覆盖的单元格,每个单元格至少生成一条基础变体;若需要多个措辞版本,再增加独立的文案变体编号。
interface CoverageCell {
  ruleId: LightingRuleId;
  placeId: PlaceId;
  conditionId: ConditionId;
}

interface RuleCoveragePlan {
  ruleId: LightingRuleId;
  cells: CoverageCell[];
  variantsPerCell: number;
}

function coverageKey(cell: CoverageCell): string {
  return `${cell.ruleId}|${cell.placeId}|${cell.conditionId}`;
}
variantsPerCell 控制同一单元格的题面丰富度,它不会增加已覆盖单元格数量。比如某单元格生成3种措辞,题目数量增加3,规则覆盖仍只增加1。报告同时展示“覆盖单元格数”和“生成题数”,读者才能区分内容广度与措辞密度。
计划可以按科目版本保存。若某条规则只需要地点维度而不需要条件维度,可以使用明确的 NOT_APPLICABLE 条件键或另一种单维结构;不要用空字符串,因为空值无法区分“不适用”和“遗漏”。
六、生成结果必须携带覆盖元数据
只在计划阶段有单元格还不够,生成后的题目需要保留元数据,才能核对去重、过滤和合并后实际留下了什么。可以在 QuestionItem 外建立伴随记录,降低对现有页面模型的影响。
interface GeneratedQuestionRecord {
  question: QuestionItem;
  coverage: {
    ruleId: LightingRuleId;
    placeId: PlaceId;
    conditionId: ConditionId;
    wordingVariant: number;
  };
}

function createGeneratedRecord(
  seed: LightingRuleSeed,
  dimension: ScenarioDimension,
  wordingVariant: number
): GeneratedQuestionRecord {
  const title = `${seed.scenarioText},场景为${dimension.placeText}、${dimension.conditionText},应如何处理?`;
  return {
    question: buildQuestionFromRule(seed, title, wordingVariant),
    coverage: {
      ruleId: seed.ruleId,
      placeId: dimension.placeId,
      conditionId: dimension.conditionId,
      wordingVariant
    }
  };
}
示例中的 buildQuestionFromRule() 代表现有选项构建能力的适配层,没有假定它已经存在。覆盖元数据不从生成后的标题反向解析;反向解析容易被标点、措辞和多语言变化破坏。元数据还应在去重之后保留,若某题因标题相同被舍弃,报告要记录对应单元格是否仍由其他题覆盖。
不要把 ruleId、地点和条件直接展示为答案提示。它们适合内容治理与报告,不一定都应该进入作答页或公开日志。
七、覆盖账本以集合聚合,不重复计算同一单元格
账本读取最终保留的生成记录,把每个覆盖键放入集合。再用期望集合减去实际集合,得到缺口;用实际集合减去期望集合,得到未经批准的组合。
interface CoverageSummary {
  expectedCellCount: number;
  coveredCellCount: number;
  missingKeys: string[];
  unexpectedKeys: string[];
  questionCount: number;
}

function summarizeCoverage(
  plans: RuleCoveragePlan[],
  records: GeneratedQuestionRecord[]
): CoverageSummary {
  const expected = new Set<string>();
  const actual = new Set<string>();
  plans.forEach((plan) => plan.cells.forEach((cell) => expected.add(coverageKey(cell))));
  records.forEach((record) => actual.add(coverageKey(record.coverage)));

  const missing = Array.from(expected).filter((key) => !actual.has(key));
  const unexpected = Array.from(actual).filter((key) => !expected.has(key));
  return {
    expectedCellCount: expected.size,
    coveredCellCount: expected.size - missing.length,
    missingKeys: missing.sort(),
    unexpectedKeys: unexpected.sort(),
    questionCount: records.length
  };
}
集合天然去除同一单元格的重复题,因此不会让十种近似措辞把覆盖率放大十倍。报告仍保留 questionCount,以便发现“单元格很少但题量很大”的密度失衡。unexpectedKeys 同样重要:它可能说明规则计划过期,也可能说明生成器组合出了业务不适用场景。
在 ArkTS 环境中采用 Set、Array.from 和回调写法前,应以项目目标 SDK 和编译规则复核。若受限,可以用显式循环与字符串字典实现同样语义,不能因语法调整改变集合运算结果。
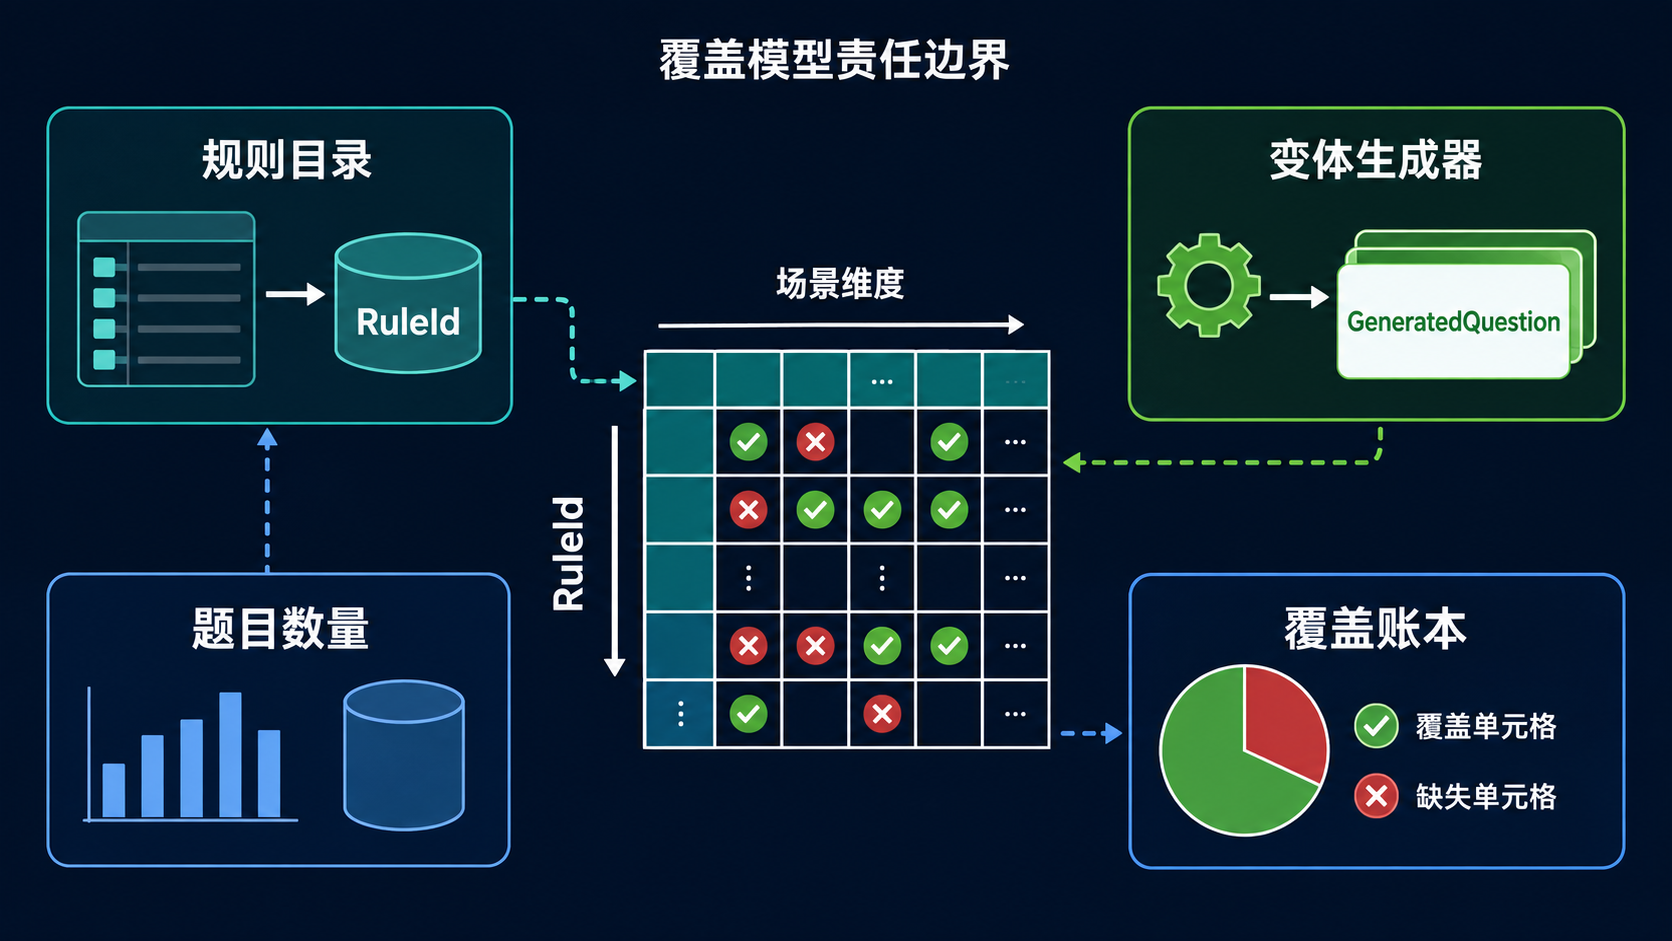
八、覆盖报告要同时显示广度、密度与缺口
一个“总题数2000”的数字无法指导补题。更有用的报告按科目、分类和规则分组,至少包含以下字段:
| 指标 | 含义 | 异常信号 |
|---|---|---|
| 规则总数 | 当前启用的稳定 ruleId 数量 | 分类有题但规则数为0 |
| 期望单元格 | 批准的规则与场景组合数 | 计划意外膨胀 |
| 已覆盖单元格 | 最终题库实际留下的组合数 | 少于期望集合 |
| 缺失单元格 | 期望减实际 | 发布前需要补充或说明 |
| 额外单元格 | 实际减期望 | 生成器越界或计划未更新 |
| 题目密度 | 题目数除以已覆盖单元格 | 少数单元格重复过多 |
| 规则最小覆盖 | 单条规则覆盖单元格的最小值 | 某条规则被完全遗漏 |
报告还应带规则目录版本、维度目录版本、生成器版本和输入摘要。这样两次报告数字变化时,能判断是新增规则、调整场景范围,还是生成逻辑变化。只保存最终百分比会丢失追溯依据。
九、用有意构造的缺口验证账本
覆盖逻辑最怕“全绿但算错”。验证时应主动删除一条记录、制造重复变体和加入未经批准组合,确认报告分别出现缺失、密度变化和额外项。
function assertCoverageScenario(): void {
  const summary = summarizeCoverage(FIXED_PLANS, FIXED_RECORDS);
  if (summary.expectedCellCount !== 9) {
    throw new Error('EXPECTED_CELL_COUNT_CHANGED');
  }
  if (summary.coveredCellCount !== 8) {
    throw new Error('MISSING_CELL_NOT_FOUND');
  }
  if (summary.missingKeys.length !== 1) {
    throw new Error('MISSING_KEY_COUNT_WRONG');
  }
  if (summary.questionCount <= summary.coveredCellCount) {
    throw new Error('DENSITY_FIXTURE_NOT_EFFECTIVE');
  }
}
这个固定用例故意让题数大于覆盖单元格数,用来证明账本没有把重复变体当作新增覆盖。测试数据应使用明确的灯光规则与道路条件,不从生产题库随机抽取,否则源数组一变,覆盖算法是否正确就难以区分。
还应加入空计划、空记录、重复单元格、未知 ruleId、失效地点键和规则停用等边界。对每种失败,报告只输出稳定键和数量,不输出完整题干或答案。
十、验证清单、排障表与事实边界
- 每条生成规则拥有稳定且唯一的
RuleId。 -
RuleId不随题干、解析或数组位置变化。 - 地点与驾驶条件使用稳定键和独立展示文本。
- 每条规则明确声明适用场景,不默认扩展全部组合。
- 生成结果直接携带覆盖元数据,不从标题反向猜测。
- 去重后重新汇总实际覆盖,丢弃记录有原因。
- 重复措辞只增加题目密度,不增加覆盖单元格。
- 报告同时列出缺失组合和额外组合。
- 固定用例故意包含缺口、重复和越界组合。
- 日志只记录稳定键、版本与数量,不记录完整答案。
| 症状 | 优先检查 | 常见原因 | 处理方向 |
|---|---|---|---|
| 题目有1000条但某规则为0 | 规则目录与种子映射 | 只按数组循环,没有 RuleId | 先建规则计划再生成 |
| 文案一改覆盖报告大幅变化 | 聚合键 | 使用题干作为规则身份 | 改用稳定规则键与维度键 |
| 同一场景改写十次覆盖率上涨 | 集合逻辑 | 按题目条数计覆盖 | 用单元格键去重 |
| 报告全部通过但缺少道路湿滑题 | 期望集合 | 只汇总实际,没有计划基线 | 用期望减实际得到缺口 |
| 出现业务不适用组合 | 额外集合 | 直接做全量笛卡尔积 | 为每条规则声明批准组合 |
| 去重后单元格消失却没有提示 | 汇总时机 | 在去重前生成报告 | 对最终保留记录重新汇总 |
| 规则停用后历史无法解释 | 目录版本 | 直接删除旧键 | 保留停用记录和迁移说明 |
当前源码能够确认:生成种子没有 RuleId;地点与条件由索引计算后拼入题干;种子按循环余数选择;科二和科四分别请求生成1000题;生成结果保留分类但没有显式场景维度元数据。本文没有证明现有题库一定漏掉某条具体驾驶规则。文中的规则目录、稳定维度键、覆盖计划、伴随记录和覆盖账本均为建议方案,尚未合入或写入 The_kemusan。本次未构建项目,没有生成新的 HAP,也没有在模拟器或真机设备上验证题库生成、搜索或作答行为。接入后仍需以业务批准的规则集合、目标 SDK 编译结果和最终题库报告补齐验收。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 4
 0
- 0


 已为社区贡献283条内容

所有评论(0)