灯光模拟HarmonyOS应用实战-66-JSON语法合法字段仍可能非法-逐字段解码软硬损坏与幂等修复
灯光模拟HarmonyOS应用实战-66-JSON语法合法字段仍可能非法-逐字段解码软硬损坏与幂等修复
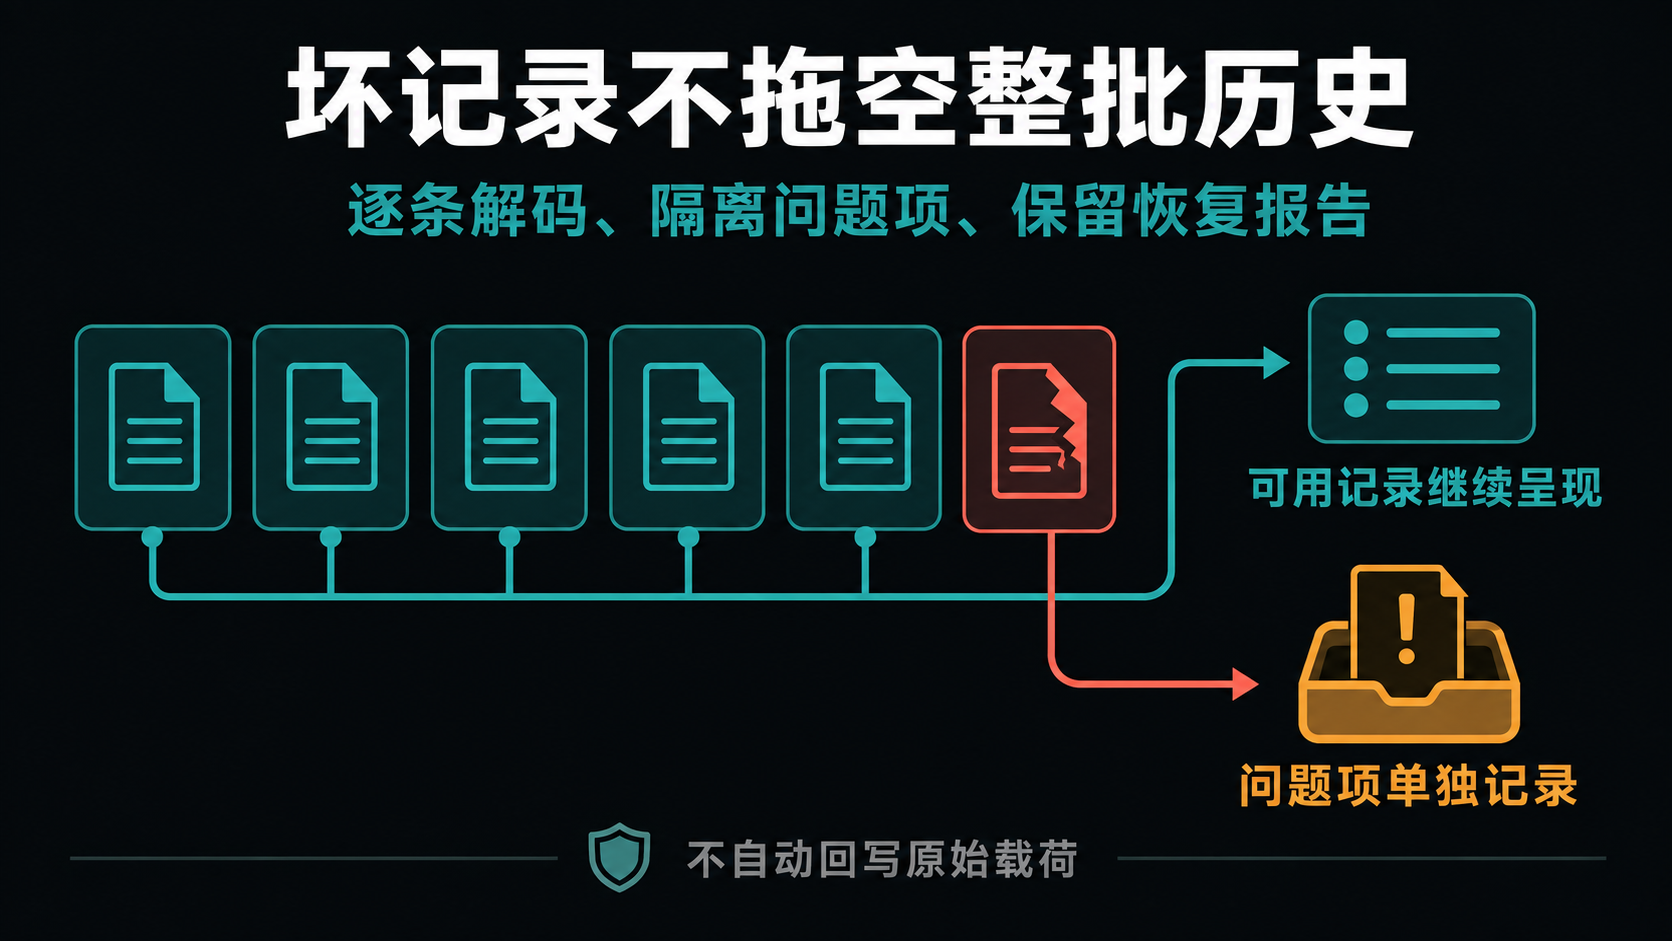
JSON.parse() 成功,只能说明文本符合 JSON 语法,不能说明数组中的每个对象都满足 PracticeRecord 契约。null、空对象、字符串形式的布尔值、无效时间戳、超出范围的分数以及重复 ID 都可以出现在语法完全合法的 JSON 中。
当前 PracticeStore.listRecords() 把解析结果直接断言为 LegacyRecord[],随后由 normalizeRecord() 复制多个必填字段。类型断言不会执行运行时校验,所以某些条目会在访问属性时抛错,另一些条目则携带 undefined 或错误类型继续流入排序和页面。本文不再讨论 JSON 语法错误,也不把“单项异常导致整批返回空”作为主体;重点是语法合法后的逐字段解码、软损坏与硬损坏分类、隔离报告和显式幂等修复。
所有示例都只描述建议设计,没有读取任何真实用户数据。问题项的原始内容不应直接写日志;修复前保留原始载荷,修复结果必须可重复计算,并由明确操作决定是否回写。
一、合法 JSON 可以包含多种非法业务值
下面六个元素都能被 JSON.parse() 接受,但只有第一个接近当前记录契约。其余元素分别代表空值、缺少必填字段、类型错误、数值关系错误和重复身份。
[
  {
    "id": "r-001",
    "subject": "subject3",
    "mode": "科三灯光模拟",
    "passed": true,
    "score": 10,
    "total": 10,
    "reason": "完成",
    "durationSeconds": 45,
    "createdAt": 1750000000000
  },
  null,
  {},
  {
    "id": "r-004",
    "passed": "yes",
    "score": "1",
    "total": 1,
    "createdAt": "today"
  },
  {
    "id": "r-005",
    "passed": false,
    "score": 8,
    "total": 3,
    "durationSeconds": -2,
    "createdAt": 1750000000000
  },
  {
    "id": "r-001",
    "passed": true,
    "score": 1,
    "total": 1,
    "durationSeconds": 1,
    "createdAt": 1750000001000
  }
]
这段数据用的是虚构值,只用于说明结构,不代表设备中存在这些记录。解析成功后的问题至少分三层:
- 元素层:
null、数组或字符串并不是记录对象。 - 字段层:对象存在,但
id/passed/score/createdAt的类型不对或缺失。 - 关系层:单个字段类型都对,组合却违反
score <= total、时长非负或 ID 唯一等约束。
因此,解码器不能只写一串 typeof 判断后返回布尔值。它需要指出哪一项、哪个字段、什么原因、是否可安全补默认值,以及该项能否进入正常历史。
二、当前断言和规范化没有运行时保护
PracticeStore.ets 当前的读取路径先解析,再把结果断言成 LegacyRecord[]。编译器会按开发者声明继续推导,但运行时对象不会因 as LegacyRecord[] 自动补字段或转换类型。
async listRecords(): Promise<PracticeRecord[]> {
  const raw = await this.getString(HISTORY_KEY, '[]');
  try {
    const source = JSON.parse(raw) as LegacyRecord[];
    const records: PracticeRecord[] = [];
    for (let index = 0; index < source.length; index++) {
      records.push(this.normalizeRecord(source[index]));
    }
    return records.sort(
      (left: PracticeRecord, right: PracticeRecord) =>
        right.createdAt - left.createdAt
    );
  } catch (err) {
    return [];
  }
}
normalizeRecord() 只为 subject、mode、几个选项字段和 mastered 提供回退,其余字段直接复制:
private normalizeRecord(record: LegacyRecord): PracticeRecord {
  const subject = record.subject ? record.subject : SUBJECT_THREE;
  const mode = record.mode ? record.mode : '科三灯光模拟';
  return {
    id: record.id,
    subject,
    mode,
    passed: record.passed,
    score: record.score,
    total: record.total,
    reason: record.reason,
    wrongQuestionId: record.wrongQuestionId
      ? record.wrongQuestionId
      : '',
    correctOption: record.correctOption
      ? record.correctOption
      : '',
    selectedOption: record.selectedOption
      ? record.selectedOption
      : '',
    durationSeconds: record.durationSeconds,
    createdAt: record.createdAt,
    mastered: record.mastered ? true : false
  };
}
null 会在读取 record.subject 时抛错;空对象通常不会在这里抛错,却会形成 id/passed/score/total/reason/durationSeconds/createdAt 为 undefined 的对象。后者更隐蔽,因为它可能直到排序、格式化或字符串访问时才表现异常。
| 字段 | 当前处理 | 语法合法但非法的例子 | 可能后果 |
|---|---|---|---|
id | 直接复制 | 缺失、数字、空串、重复 | 列表身份不稳定或记录冲突 |
passed | 直接复制 | "false"、0、缺失 | 真值判断与真实含义不一致 |
score/total | 直接复制 | 字符串、负数、score>total | 展示错误、统计失真 |
createdAt | 直接复制 | 字符串、非有限值语义 | 排序比较得到异常结果 |
durationSeconds | 直接复制 | 负数、字符串 | 页面显示无意义时长 |
subject/mode | 真值回退 | 空白串、未知枚举 | 分类含义模糊 |
| 选项字段 | 真值回退为空串 | 数字、对象 | 后续字符串操作风险 |
这张表说明,默认值只适合确实可缺省的字段。对 id 或 passed 使用默认值会凭空制造业务事实,应归为硬损坏。
三、先定义软损坏与硬损坏的边界
硬损坏表示“无法在不猜测关键事实的前提下构造正常记录”。软损坏表示“核心身份和结果仍可信,非关键字段可以按明确规则修复或降级”。边界必须由产品和数据契约共同确定,不能让解码器临时决定。
建议的错误模型如下:
export enum IssueSeverity {
  SOFT = 'soft',
  HARD = 'hard'
}

export enum HistoryIssueCode {
  NOT_OBJECT = 'NOT_OBJECT',
  MISSING_ID = 'MISSING_ID',
  BAD_BOOLEAN = 'BAD_BOOLEAN',
  BAD_NUMBER = 'BAD_NUMBER',
  SCORE_OUT_OF_RANGE = 'SCORE_OUT_OF_RANGE',
  NON_FINITE_TIME = 'NON_FINITE_TIME',
  NEGATIVE_DURATION = 'NEGATIVE_DURATION',
  UNKNOWN_SUBJECT = 'UNKNOWN_SUBJECT',
  BAD_OPTION_TEXT = 'BAD_OPTION_TEXT',
  DUPLICATE_ID = 'DUPLICATE_ID'
}

export interface FieldIssue {
  index: number;
  field: string;
  code: HistoryIssueCode;
  severity: IssueSeverity;
}
一种可执行的分类建议是:
| 场景 | 严重级别 | 能否进入正常列表 | 理由 |
|---|---|---|---|
元素是 null 或非对象 | 硬 | 否 | 没有可读取记录 |
id 缺失、非字符串或空白 | 硬 | 否 | 无法稳定标识 |
passed 不是布尔值 | 硬 | 否 | 不能猜结果 |
score/total 非有限数或关系非法 | 硬 | 否 | 成绩事实不可信 |
createdAt 非有限数 | 硬 | 否 | 无法可靠排序和展示 |
durationSeconds 缺失但旧协议允许 | 软 | 有条件 | 可按“未知时长”降级,而不是伪造 1 秒 |
mastered 缺失 | 软 | 是 | 当前字段本来可选,可回退为 false |
| 可选选项字段缺失 | 软 | 是 | 用空串表示未提供 |
subject 为已知旧值 | 软 | 迁移后可以 | 需要带版本映射 |
| ID 重复 | 硬或隔离后项 | 只保留策略明确的一项 | 两条记录不能共享身份 |
“软”不代表静默忽略。每次补默认值都应进入问题清单,报告这条记录被迁移过。否则随着版本演进,维护者无法区分原始值和解码器补出的值。
四、字段解码器返回值和问题而不是抛出
逐字段函数应返回明确结果,避免任一可预期数据问题通过异常跳出整条循环。下面使用 TypeScript 风格展示接口,目标 ArkTS 是否接受 unknown、泛型联合与内置类型守卫,需要按项目 SDK 调整。
interface DecodedField<T> {
  ok: boolean;
  value: T | undefined;
  issue: FieldIssue | undefined;
}

function decodeRequiredString(
  value: unknown,
  index: number,
  field: string
): DecodedField<string> {
  if (typeof value !== 'string' || value.trim().length === 0) {
    return {
      ok: false,
      value: undefined,
      issue: {
        index,
        field,
        code: HistoryIssueCode.MISSING_ID,
        severity: IssueSeverity.HARD
      }
    };
  }
  return { ok: true, value, issue: undefined };
}

function decodeFiniteNumber(
  value: unknown,
  index: number,
  field: string
): DecodedField<number> {
  if (typeof value !== 'number' || !Number.isFinite(value)) {
    return {
      ok: false,
      value: undefined,
      issue: {
        index,
        field,
        code: HistoryIssueCode.BAD_NUMBER,
        severity: IssueSeverity.HARD
      }
    };
  }
  return { ok: true, value, issue: undefined };
}
每个函数只处理一个字段规则,调用方决定组合关系。对 passed 必须接受真正的布尔值,不能使用 Boolean(value):字符串 "false" 转成布尔值反而是 true,会把坏数据“修”成相反结论。
对时间戳还要检查业务范围。Number.isFinite() 能排除非有限值,但一个极端大数仍可能不适合格式化。范围上限和下限属于产品协议,应结合历史最早版本与设备时间策略决定,不能在文章里随意写死。
软字段可以返回默认值并附带问题:
function decodeMastered(
  value: unknown,
  index: number
): DecodedField<boolean> {
  if (value === undefined) {
    return {
      ok: true,
      value: false,
      issue: {
        index,
        field: 'mastered',
        code: HistoryIssueCode.BAD_BOOLEAN,
        severity: IssueSeverity.SOFT
      }
    };
  }
  if (typeof value !== 'boolean') {
    return {
      ok: false,
      value: undefined,
      issue: {
        index,
        field: 'mastered',
        code: HistoryIssueCode.BAD_BOOLEAN,
        severity: IssueSeverity.HARD
      }
    };
  }
  return { ok: true, value, issue: undefined };
}
这里把“缺失”视为旧协议可迁移,把“存在但类型错误”视为硬损坏。两者在 JSON 中都可能看起来像“没有正确布尔值”,但证据含义不同。
五、记录解码器一次收集所有字段问题
如果遇到第一个坏字段就返回,修复人员每次只能看到一项问题,改完重试后才发现下一项。更有用的解码器会收集整条记录的问题,在硬损坏存在时拒绝正常对象,在只有软问题时返回迁移后的对象和完整清单。
interface RecordAccepted {
  kind: 'accepted';
  index: number;
  record: PracticeRecord;
  issues: FieldIssue[];
}

interface RecordRejected {
  kind: 'rejected';
  index: number;
  issues: FieldIssue[];
}

type RecordDecodeResult = RecordAccepted | RecordRejected;

function decodePracticeRecord(
  raw: unknown,
  index: number
): RecordDecodeResult {
  if (raw === null || typeof raw !== 'object' || Array.isArray(raw)) {
    return {
      kind: 'rejected',
      index,
      issues: [{
        index,
        field: '$',
        code: HistoryIssueCode.NOT_OBJECT,
        severity: IssueSeverity.HARD
      }]
    };
  }

  const object = raw as Record<string, unknown>;
  const id = decodeRequiredString(object.id, index, 'id');
  const score = decodeFiniteNumber(object.score, index, 'score');
  const total = decodeFiniteNumber(object.total, index, 'total');
  const createdAt = decodeFiniteNumber(
    object.createdAt,
    index,
    'createdAt'
  );
  const issues = collectIssues([id, score, total, createdAt]);

  if (score.ok && total.ok && score.value! > total.value!) {
    issues.push({
      index,
      field: 'score',
      code: HistoryIssueCode.SCORE_OUT_OF_RANGE,
      severity: IssueSeverity.HARD
    });
  }

  if (issues.some((item) => item.severity === IssueSeverity.HARD)) {
    return { kind: 'rejected', index, issues };
  }

  return {
    kind: 'accepted',
    index,
    record: buildRecordFromDecodedFields(object, id, score, total),
    issues
  };
}
示例省略了 passed、reason、时长、科目与选项字段的完整调用,真实实现必须逐一覆盖,不能照抄后误以为只有四个字段。buildRecordFromDecodedFields() 只能接收已经解码的值,不应重新从 object 直接取必填字段,否则前面的守卫会被绕过。
关系规则也在这一层执行。score 和 total 单独都是有限数,不代表组合合法;durationSeconds 还应非负;若记录种类区分单题与整场,不同种类要有不同字段不变量。
六、数组加载器逐条隔离并处理重复 ID
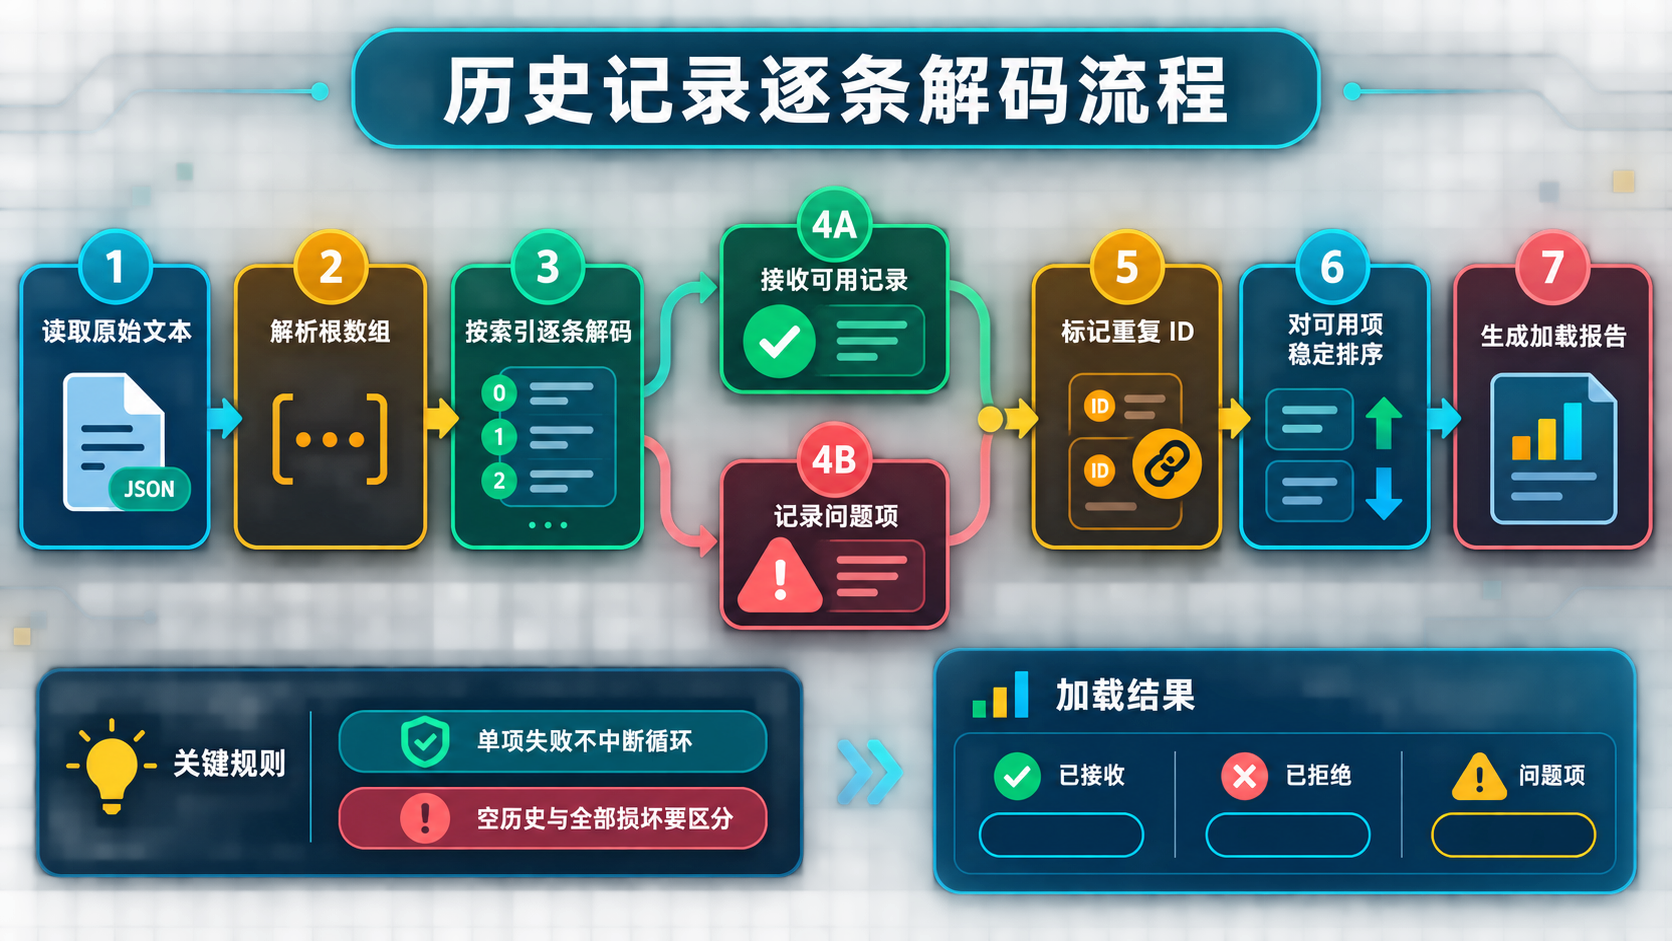
本文前提是根文本已经成功解析。加载器仍应确认根值确实是数组,然后按索引调用解码器。单项拒绝只进入问题清单,不中断后续元素。重复 ID 需要稳定策略:例如保留第一条已接受记录,把后续同 ID 项标记为硬问题;不能依赖排序后偶然留下某一条。
interface HistoryLoadReport {
  accepted: PracticeRecord[];
  rejectedIndexes: number[];
  issues: FieldIssue[];
  rootWasArray: boolean;
}

function decodeHistoryArray(parsed: unknown): HistoryLoadReport {
  if (!Array.isArray(parsed)) {
    return {
      accepted: [],
      rejectedIndexes: [],
      issues: [{
        index: -1,
        field: '$',
        code: HistoryIssueCode.NOT_OBJECT,
        severity: IssueSeverity.HARD
      }],
      rootWasArray: false
    };
  }

  const accepted: PracticeRecord[] = [];
  const rejectedIndexes: number[] = [];
  const issues: FieldIssue[] = [];
  const seenIds: Set<string> = new Set();

  for (let index = 0; index < parsed.length; index++) {
    const result = decodePracticeRecord(parsed[index], index);
    issues.push(...result.issues);

    if (result.kind === 'rejected') {
      rejectedIndexes.push(index);
      continue;
    }
    if (seenIds.has(result.record.id)) {
      rejectedIndexes.push(index);
      issues.push(duplicateIssue(index));
      continue;
    }
    seenIds.add(result.record.id);
    accepted.push(result.record);
  }

  return {
    accepted: stableSortByCreatedAt(accepted),
    rejectedIndexes,
    issues,
    rootWasArray: true
  };
}
“保留第一条”是可选业务策略,发布前应确认是否更适合保留时间更新的一条或全部隔离。无论选择什么,规则都要稳定且可测试。同一输入多次解码必须得到同样的接受索引、拒绝索引和排序。
稳定排序还要保留原始索引作为同时间戳的次级键,避免比较结果为 0 时不同运行环境产生不同顺序。不能把 createdAt 非法项先塞进数组再期望排序器自行处理。
七、隔离报告只保存位置、错误码和摘要
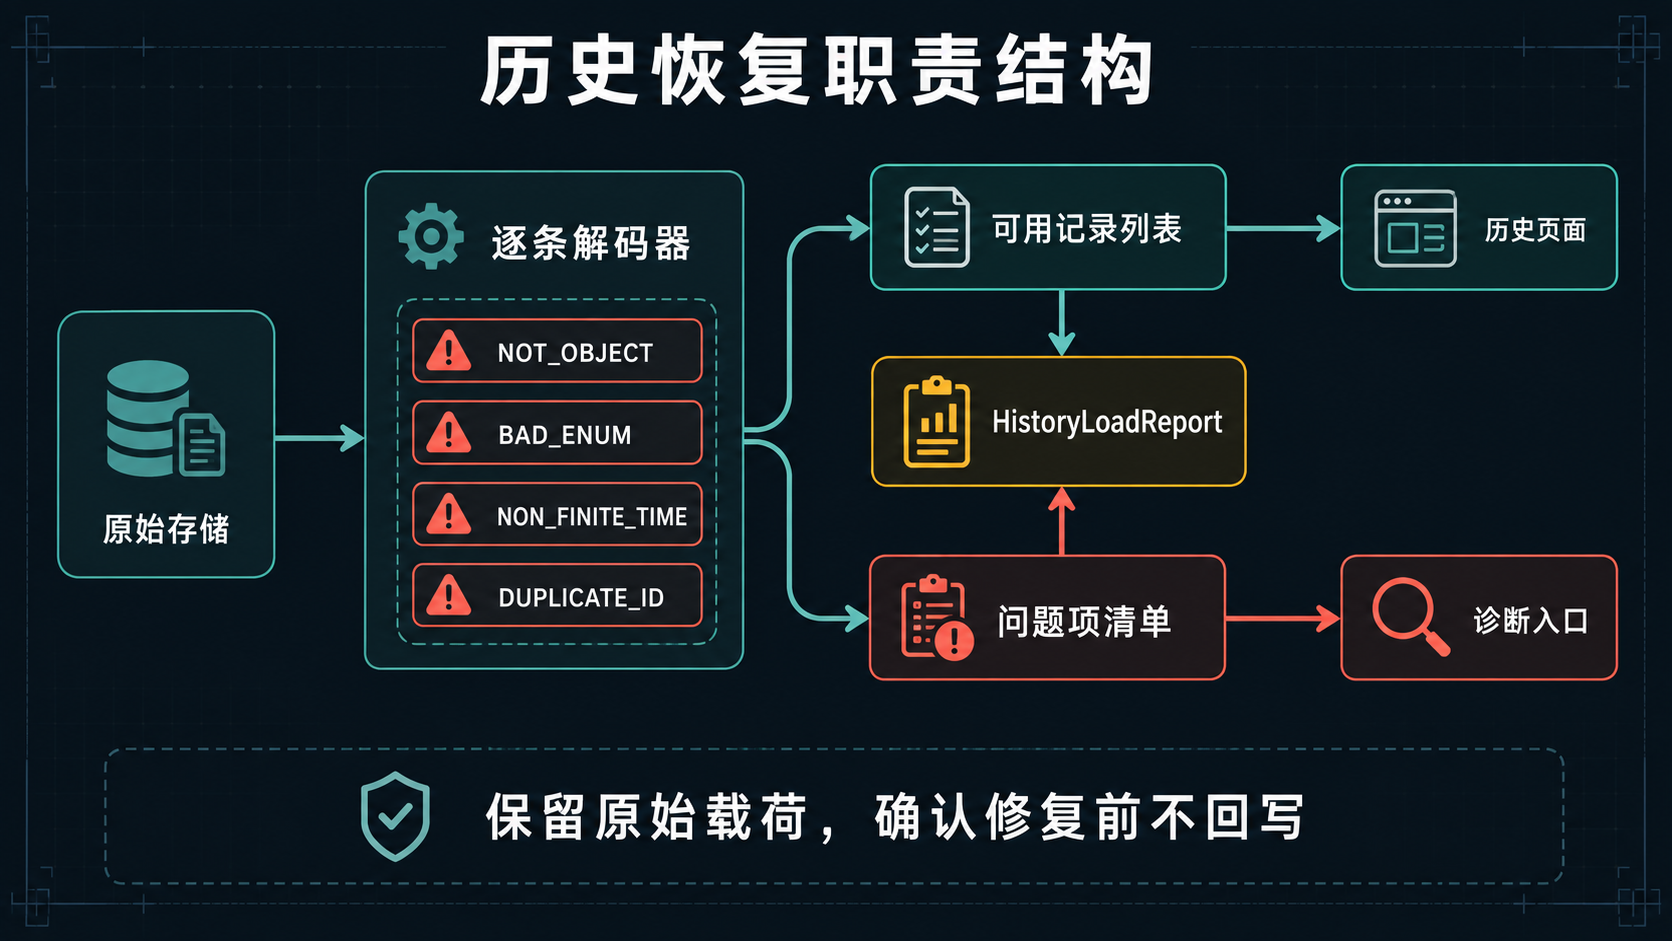
问题报告需要帮助定位,但不应复制完整答题内容到日志。建议保存原始数组索引、字段名、稳定错误码、严重级别和整条元素的摘要。摘要端口如何实现要根据项目可用库决定,不能把哈希词汇自动等同于安全承诺。
interface QuarantineEntry {
  index: number;
  issueCodes: HistoryIssueCode[];
  rawDigest: string;
  rawLength: number;
}

interface HistoryRecoveryView {
  acceptedCount: number;
  rejectedCount: number;
  softIssueCount: number;
  hardIssueCount: number;
  quarantine: QuarantineEntry[];
}
原始 exam_history 在确认修复前保持不变。隔离报告可以存到独立、受控的诊断 key,或者只在本次加载会话中提供给维护入口;是否持久化要考虑空间和隐私。不要用数组元素正文作为日志参数,也不要显示选项文本或失败原因。
报告还应区分四种页面状态:
| 状态 | accepted | rejected | 页面含义 |
|---|---|---|---|
| 真正空历史 | 0 | 0 | 用户尚无记录或已主动清空 |
| 部分可恢复 | 大于 0 | 大于 0 | 展示可用记录,并提示存在问题项 |
| 全部字段损坏 | 0 | 大于 0 | 不能伪装成从未练习 |
| 读取基础设施失败 | 未知 | 未知 | 与数据内容问题分开报告 |
当前 getString() 会把存储未初始化、读取异常和非字符串值都回退成 [],所以要实现上述区分,存储端口也必须返回带原因的读取结果。否则解码器再精细,也拿不到“真实空数组”和“读取失败”的差别。
八、修复必须显式、可预览且幂等
自动读取可以对软字段使用明确默认值,但不应立即覆盖原始 exam_history。修复流程应先生成预览,列出将保留、修改和隔离的数量;用户或维护策略确认后,才把候选值写到暂存区、回读、再提交。
幂等修复意味着:同一原始载荷、同一修复策略版本,重复执行得到相同候选字节和相同报告,不重复追加记录,也不不断改变 ID 或时间戳。
interface RepairPlan {
  sourceDigest: string;
  policyVersion: number;
  acceptedIndexes: number[];
  rejectedIndexes: number[];
  candidateJson: string;
}

function createRepairPlan(
  raw: string,
  report: HistoryLoadReport,
  policyVersion: number
): RepairPlan {
  const candidate = report.accepted.map(toStableDto);
  return {
    sourceDigest: digest(raw),
    policyVersion,
    acceptedIndexes: acceptedSourceIndexes(report),
    rejectedIndexes: [...report.rejectedIndexes],
    candidateJson: stableStringify(candidate)
  };
}
stableStringify() 必须固定字段顺序和数组顺序;toStableDto() 不能使用 Date.now() 生成新值,否则重复运行结果会变化。若确实需要新的修复批次 ID,应把它放进回执,不要写进每条业务记录。
提交前再次读取正式原文并比较 sourceDigest。如果期间产生了新历史,计划已经过期,应重新解码和预览,不能用旧候选覆盖新记录。
async function commitRepair(plan: RepairPlan): Promise<string> {
  const currentRaw = await historyPort.readRaw();
  if (digest(currentRaw) !== plan.sourceDigest) {
    return 'SOURCE_CHANGED';
  }

  await historyPort.writeCandidate(plan.candidateJson);
  const readback = await historyPort.readCandidate();
  if (readback !== plan.candidateJson) {
    return 'CANDIDATE_READBACK_MISMATCH';
  }

  await historyPort.commitCandidate();
  const committed = await historyPort.readRaw();
  return committed === plan.candidateJson
    ? 'COMMITTED'
    : 'COMMIT_READBACK_MISMATCH';
}
这些端口不是当前 PracticeStore 方法。Preferences 是否能为多 key 提供所需耐久顺序,需要按 ArkData 文档和故障实验确认。文章只给出业务步骤,不把它描述成平台事务。
九、字段矩阵与幂等用例必须使用合法 JSON
回归样本应全部保持 JSON 语法正确,才能确认用例在测试字段解码而不是解析异常。建议固定下面这组矩阵:
| 用例 | 合法 JSON 元素 | 预期分类 | 关键断言 |
|---|---|---|---|
| D01 | 完整合法对象 | 接受 | 无硬问题 |
| D02 | null | 硬损坏 | NOT_OBJECT,后续项仍处理 |
| D03 | {} | 硬损坏 | 一次返回多个必填字段问题 |
| D04 | passed:"false" | 硬损坏 | 不用真值转换 |
| D05 | score:"1" | 硬损坏 | 不自动转数字 |
| D06 | score>total | 硬损坏 | SCORE_OUT_OF_RANGE |
| D07 | 缺失可选 mastered | 软损坏 | 回退 false 并留问题 |
| D08 | 两条相同 ID | 后项隔离 | DUPLICATE_ID |
| D09 | 时间戳相同 | 均接受 | 按原始索引稳定排序 |
| D10 | 全部损坏 | 无可用项 | 与真正空数组区分 |
| D11 | 同一输入修复两次 | 两次候选相同 | 摘要和字节一致 |
| D12 | 预览后新增历史 | 拒绝旧计划 | SOURCE_CHANGED |
一个幂等断言可以很直接:
const parsed = JSON.parse(validSyntaxButMixedFieldsJson);
const firstReport = decodeHistoryArray(parsed);
const firstPlan = createRepairPlan(raw, firstReport, 2);

const secondReport = decodeHistoryArray(parsed);
const secondPlan = createRepairPlan(raw, secondReport, 2);

expect(secondPlan.candidateJson).toBe(firstPlan.candidateJson);
expect(secondPlan.rejectedIndexes).toEqual(
  firstPlan.rejectedIndexes
);
expect(secondPlan.sourceDigest).toBe(firstPlan.sourceDigest);
集成层再使用临时 Preferences,覆盖候选写入失败、回读不一致、提交前来源变化和进程重建。不要把单元层输出当成存储耐久证据。
十、验证清单、排障表与事实边界
实现后可逐项核对:
- 根 JSON 可解析后仍校验根值是否为数组。
- 每个数组元素单独调用记录解码器。
-
null、数组、字符串和空对象不会进入正常历史。 - 必填字符串拒绝缺失、错误类型和空白值。
- 布尔字段不使用
Boolean(value)猜测。 - 数字字段要求类型正确且有限。
-
score/total、时长和时间戳还有关系与范围约束。 - 可缺省与类型错误采用不同严重级别。
- 单项一次收集多个字段问题。
- 重复 ID 使用稳定、经过确认的隔离策略。
- 同时间戳记录按原始索引稳定排序。
- 报告不包含题目、答案或失败原因正文。
- 真正空历史、部分恢复、全部损坏和读取失败分别呈现。
- 自动读取不回写原始载荷。
- 修复先预览、再暂存、回读、提交、再次回读。
- 相同输入和策略版本生成相同候选。
- 来源变化时旧计划拒绝提交。
- ArkTS 类型守卫与 Preferences 行为经过文档和编译核对。
| 症状 | 优先核对 | 常见原因 | 修复方向 |
|---|---|---|---|
JSON.parse 成功但排序异常 | createdAt 类型与有限性 | 断言代替解码 | 在进入排序前拒绝非法时间 |
| 空对象进入页面后才出错 | 必填字段列表 | 只给可选字段默认值 | 聚合必填字段硬问题 |
字符串 "false" 被当成通过 | 布尔解码 | 使用 Boolean(value) | 只接受真正布尔值 |
| 一条有多个问题却只显示一个 | 解码返回策略 | 首错立即返回 | 收集整条问题后决定接受或拒绝 |
| 每次修复候选都不同 | 稳定序列化 | 使用当前时间或随机 ID | 业务记录不生成新随机值 |
| 修复覆盖了新产生的历史 | 提交前来源摘要 | 预览后没有再次读取 | 比较 sourceDigest,变化则重做 |
| 全部损坏看起来像从未练习 | 页面状态判断 | 只看 accepted.length | 同时读取 rejectedCount |
| 日志出现完整答题内容 | 隔离记录结构 | 直接打印原始元素 | 只记索引、错误码、长度和摘要 |
| 重复 ID 每次保留不同项 | 去重顺序 | 先排序后依赖不稳定顺序 | 按原始索引执行固定策略 |
| 软字段错误被静默吞掉 | 报告聚合 | 默认值不留原因 | 接受记录同时保留软问题 |
当前源码能够确认的是:listRecords() 将 JSON.parse(raw) 直接断言成 LegacyRecord[];normalizeRecord() 只为部分字段提供回退,多个必填字段直接复制;当前读取接口没有逐字段错误码、隔离项或恢复报告。本文没有读取任何真实 exam_history,也没有证明设备中已经存在上述问题项。
逐字段函数、软硬分类、HistoryLoadReport、隔离摘要、稳定修复计划和提交端口都属于改进方案,尚未写入 The_kemusan。本次没有运行项目构建,没有生成新的 HAP,没有在模拟器或真机注入历史数据,也没有验证 Preferences 故障时序。示例使用 TypeScript 风格表达算法,最终 ArkTS 语法、摘要实现、可选字段策略和提交耐久性必须结合目标 SDK 文档、编译与设备实验确认。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 3
 0
- 0


 已为社区贡献283条内容

所有评论(0)