【共创稿事节】HarmonyOS 7 视觉 AI 实战:系统级场景化控件,低门槛接入端侧视觉能力
本文基于 HarmonyOS 7(API 26)官方《新能力一览》、Vision Kit(场景化视觉服务)与 Core Vision Kit(基础视觉服务)的官方文档整理。文中活体检测与图像超分的接口名、起始版本均摘自官方 API 参考并标注出处;未核验到公开 API 名的部分只讲能力与接入思路,示意代码均已注明"接口名以官方 SDK 文档为准"。未做真机实测,识别准确率等表现一律以真机实测为准。
引子:你缺的不是模型,是集成
V哥先讲个真事。前段时间有个做商务社交应用的朋友找V哥诉苦:产品经理要给名片扫描页加"拍照识名片、自动填充"的功能,团队评估了一轮——选模型、找数据、转格式、端侧部署、内存调优、再加隐私合规评审,排期三个月起步。朋友问V哥:就为了识别一张固定版式的名片,值得吗?
V哥的答案是不值得,因为方向就错了。视觉 AI 的门槛从来不在模型,在集成。识别证件、扫描文档、抠图、文字提取这些事,算法本身早就是"标准件"了,难的是把标准件塞进你的应用:模型转换、推理框架、机型适配、内存功耗、数据合规——每一项都是坑,每一项都跟你的业务价值无关。
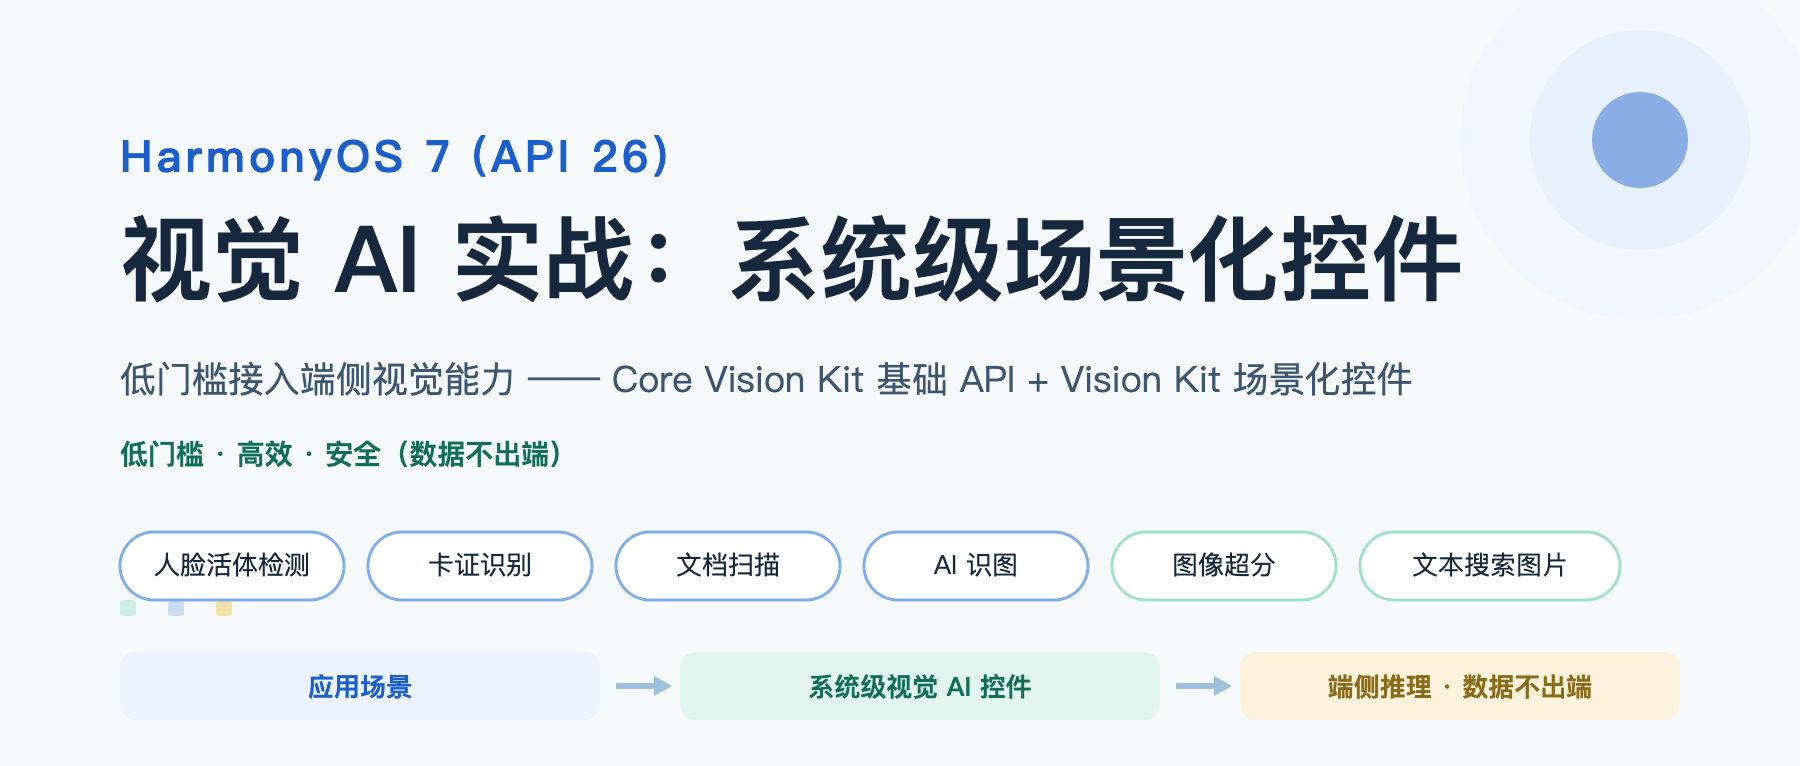
HarmonyOS 7(API 26)正是冲着这个痛点来的。官方《新能力一览》对"视觉 AI 能力"的原文表述是:
提供视觉 AI 的基础能力和场景化控件,助力开发者低门槛、高效、安全地构建端侧视觉 AI 处理能力。
这三十多个字里藏着三个关键词:低门槛(场景化控件开箱即用)、高效(不用自建推理链路)、安全(推理在端侧完成,数据不出设备)。这一期V哥把这两个官方 Kit 的能力地图、真实接入方式、以及"什么时候该用系统控件、什么时候必须自己端模型"的判断标准,一次讲透。
一、能力地图:两个 Kit,一个卖积木,一个卖成品
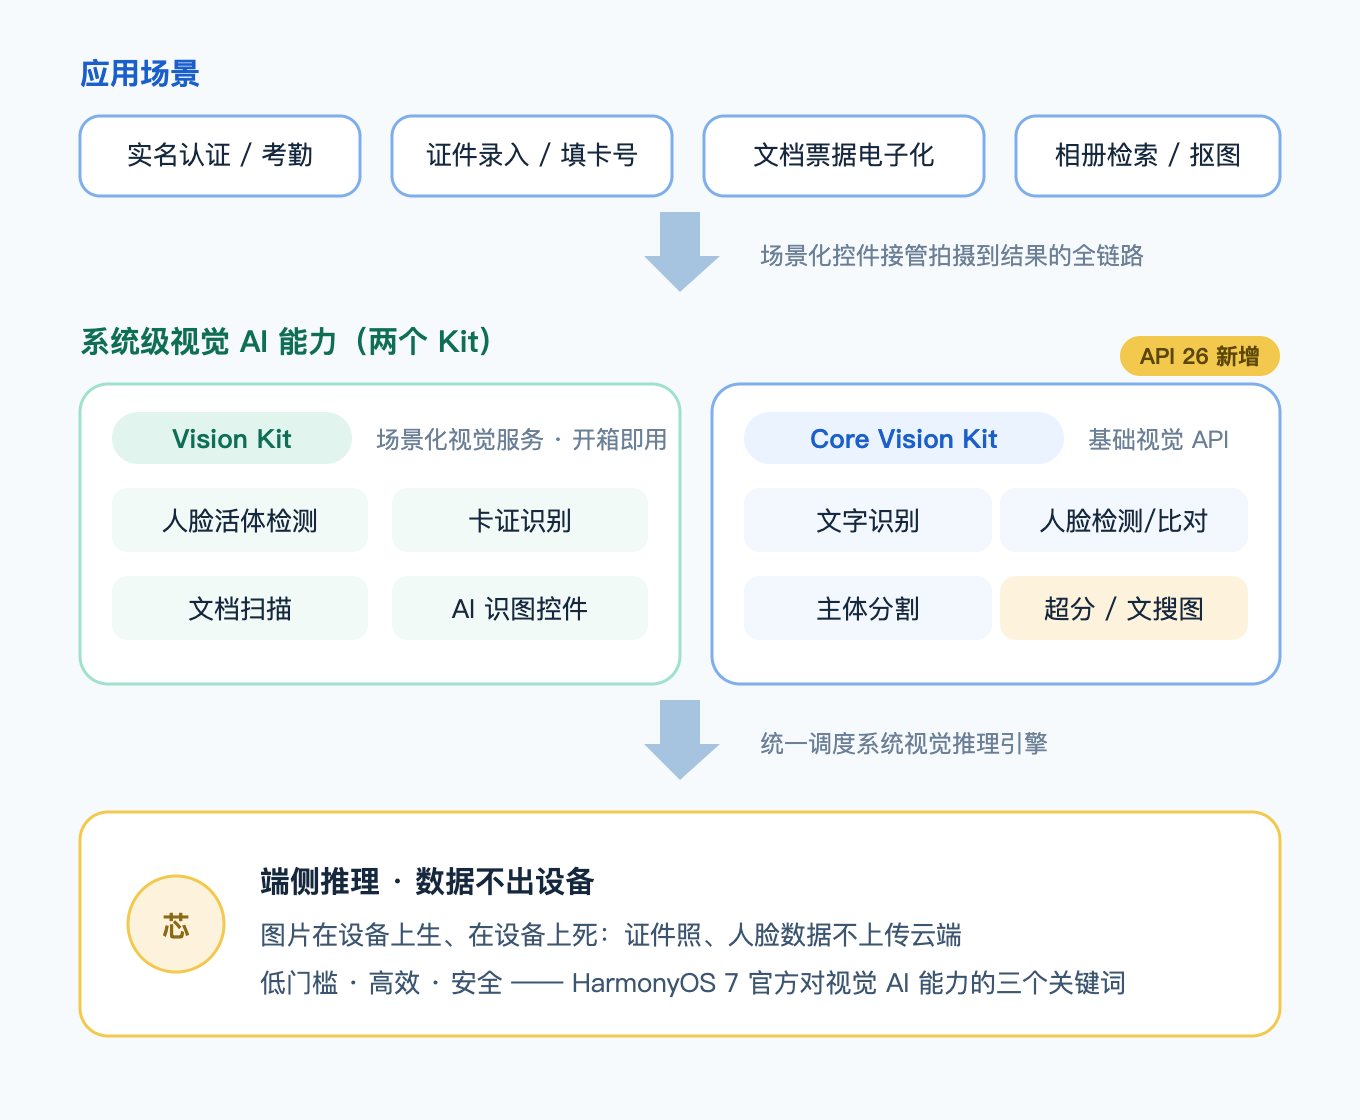
HarmonyOS 的端侧视觉能力拆成两个 Kit,分工非常清晰(官方 AI 能力一览、Vision Kit 官方页):
| Kit | 定位 | 能力清单 | 适合谁 |
|---|---|---|---|
| Core Vision Kit(基础视觉服务) | “积木”:机器视觉基础 API | 通用文字识别、人脸检测、人脸比对、主体分割、多目标识别、骨骼点检测;7.0 新增图像超分、通过文本搜索图片 | 想自建视觉业务逻辑的团队 |
| Vision Kit(场景化视觉服务) | “成品”:开箱即用的场景化控件 | 人脸活体检测(interactiveLiveness)、卡证识别(CardRecognition)、文档扫描(DocumentScanner)、AI 识图控件(visionImageAnalyzer) | 想最快上线的业务团队 |
V哥打个比方:Core Vision Kit 给你的是面粉和烤箱,Vision Kit 给你的是直接出炉的面包。大部分应用要的其实是一片面包——证件识别就识别证件,文档扫描就扫描文档,犯不上自己开面包房。
要澄清一个容易误读的点:场景化控件并不是 7.0 才有的,Vision Kit 的活体检测等能力起始版本在 API 12(5.0.0)就已开放(官方 API 参考标注)。7.0 做的事是把这条产品线整体升级并明确为系统级开放能力,同时在 Core Vision Kit 侧新增了图像超分和文搜图两项 26.0.0 起始的新 API。所以准确的说法是:HarmonyOS 7 时代,"系统级视觉 AI"已经是应用侧可以放心依赖的一等公民能力,而不只是某个版本的零散接口。
还有一条硬边界:Core Vision Kit 的图像超分等接口仅支持 Stage 模型(官方 API 参考原文),FA 模型工程先迁移再说。另外,7.0 相关能力需升级至 HarmonyOS 7 并以实际支持机型为准。
二、场景化控件四件套:每个都对着一类业务
Vision Kit 官方页把四个能力的服务场景写得非常直白(Vision Kit),V哥翻译成业务视角:
① 人脸活体检测(interactiveLiveness):验证用户是否为真实活体,抵御照片、视频等攻击。对应用户实名认证、金融风控、考勤打卡——凡是"要确认屏幕对面是个活人"的场景。
② 卡证识别(CardRecognition):身份证、行驶证、驾驶证、护照、银行卡的结构化识别。对应用户填卡号、实名录入、车辆信息登记——把"用户对着证件打字"变成"用户对着证件拍照"。
③ 文档扫描(DocumentScanner):拍摄文档并转换为高清扫描件,还能识别表格生成表单文档。对着教育办公、票据归档场景。
④ AI 识图控件(visionImageAnalyzer):场景化的文本识别、主体分割、识图搜索。对着相册里的长按提取文字、一键抠图这类"图片可玩性"场景。
注意这四件的共同点:控件形态。也就是说系统不但给你识别能力,连拍摄、引导、裁切、结果回传的 UI 流程都封装好了。你做的只是"在合适的时机把它唤起来,然后接住结果"。这就是"低门槛"三个字的具体含义——不是 API 简单点,是整条交互链路都被系统接管了。
三、动手:二十行接入人脸活体检测
V哥用官方 Codelab 的写法(Vision Kit Codelab)走一遍活体检测的完整接入。先声明相机权限,再配置检测参数、唤起控件、接住结果:
// LivenessDemo.ets —— 人脸活体检测最小接入示例
import { interactiveLiveness } from '@kit.VisionKit';
import { abilityAccessCtrl, common, Permissions } from '@kit.AbilityKit';
import { BusinessError } from '@kit.BasicServicesKit';

const CAMERA_PERMISSIONS: Permissions[] = ['ohos.permission.CAMERA'];

async function startLiveness(context: common.UIAbilityContext): Promise<void> {
  // ① 活体检测依赖相机,先走标准权限申请流程
  const atManager = abilityAccessCtrl.createAtManager();
  const result = await atManager.requestPermissionsFromUser(context, CAMERA_PERMISSIONS);
  if (!result.authResults.every(status => status === 0)) {
    return; // 用户拒绝授权,走引导文案,不强求
  }

  // ② 配置检测参数:动作活体模式、随机 3 个动作、完成后返回原页面
  const config: interactiveLiveness.InteractiveLivenessConfig = {
    isSilentMode: interactiveLiveness.DetectionMode.INTERACTIVE_MODE, // 动作活体检测
    actionsNum: interactiveLiveness.ActionsNumber.THREE_ACTION,       // 随机 3 个动作(眨眼/点头/张嘴等)
    routeMode: interactiveLiveness.RouteRedirectionMode.BACK_MODE      // 检测完成 router.back 回原页
  };

  // ③ 唤起系统活体检测控件:拍摄、动作引导、判定全由系统页面完成
  await interactiveLiveness.startLivenessDetection(config);

  // ④ 回来之后取结果:livenessType 标记是否通过,附带最具活体特征的照片
  interactiveLiveness.getInteractiveLivenessResult()
    .then((data: interactiveLiveness.InteractiveLivenessResult) => {
      console.info(`liveness result type: ${data.livenessType}`); // V哥提示:以此判定真活体,别自己另想歪招
    })
    .catch((err: BusinessError) => {
      console.error(`failed, code: ${err.code}, message: ${err.message}`);
    });
}
V哥数了一下:业务代码不到二十行。对比一下三年前自己接活体检测的清单——算法选型、SDK 集成、.camera 流管理、动作引导 UI、对抗样本测试……现在这些全部变成系统控件内部的事。你的应用只负责两件事:申请权限、接结果。
三个容易踩的点V哥先标出来:
- 活体检测不支持模拟器和预览器,必须真机调——别在模拟器上折腾半天以为集成坏了。
actionsNum目前支持 3 或 4 个动作,动作序列由系统随机生成、规则内置(比如眨眼与注视不相邻),这是防攻击设计的一部分,不要试图干预。- 该能力虽通过了金融级认证,官方仍建议高风险支付场景叠加额外安全措施——系统控件是底座,不是免死金牌。
四、7.0 新增:图像超分,给老照片和低清图续命
Core Vision Kit 这次在 API 26 新增的两项能力里,V哥最看好图像超分(开发指南、API 参考)。官方定位:对输入的低分辨率图像进行超分辨率重建,适用于提升图片质量、修复老照片等场景,起始版本 26.0.0,Phone / PC·2in1 / Tablet 均支持。
接入方式是标准的"分析器"模式:创建实例、处理、销毁。V哥按官方指南写的骨架:
// ImageSRDemo.ets —— 图像超分最小骨架(依据官方开发指南改写)
import { imageSuperResolution } from '@kit.CoreVisionKit';
import { image } from '@kit.ImageKit';

@Component
struct ImageSRPage {
  // 分析器实例:随组件生命周期创建与释放,避免常驻占内存
  private analyzer: imageSuperResolution.ImageSRAnalyzer | null = null;

  async aboutToAppear(): Promise<void> {
    // V哥提醒:create 是异步的,页面完全就绪前别急着发起 process
    this.analyzer = await imageSuperResolution.ImageSRAnalyzer.create();
  }

  async aboutToDisappear(): Promise<void> {
    // 用完就销毁——超分是重推理,实例挂着不放是纯浪费
    await this.analyzer?.destroy();
    this.analyzer = null;
  }

  // 低清 PixelMap 进,高清 PixelMap 出:官方说明像素同步放大四倍
  private async enhanceLowResImage(src: image.PixelMap): Promise<image.PixelMap | null> {
    if (!this.analyzer) {
      return null;
    }
    // process 的具体入参结构以官方 SDK 文档为准,此处只表达调用意图
    const response: imageSuperResolution.ISPResponse = await this.analyzer.process(src);
    return response.pixelMap;
  }
}
配合图像超分的另一项新增是通过文本搜索图片:端侧基于文本语义完成图片索引构建与检索,官方给的应用方向是图片检索、相册管理、内容推荐。V哥没用它的具体接口名写代码——该项的 API 细节以官方 SDK 文档为准,但接入思路值得说:索引构建在端侧完成、检索也在端侧完成,相册类应用不用再把用户图片上传云端做向量化了。
这两项能力合起来看很有意思:超分管"让图变好",文搜图管"把图找到",加上原有的文字识别、主体分割,Core Vision Kit 正在从"识别"扩展到"增强"和"检索"——基础视觉能力的版图补齐了。
五、V哥的判断:什么时候用系统控件,什么时候必须自己端模型
写到这,必须回答那个最尖锐的问题:系统控件这么香,还有自研模型的必要吗?V哥给一个三问判断法:
第一问:场景是"标准的"还是"你的"? 证件、文档、人脸、通用物体——这些是所有应用共有的标准场景,系统控件用算法团队的整体水位替你兜底,准确率、对抗鲁棒性、机型覆盖都是系统级投入,你自研大概率做不过。但如果你的产品差异点就是视觉——比如工业质检里识别特定零件缺陷、医疗影像里判读特定病灶——这种"长尾域"没有现成模型,差异点必须握在自己手里。V哥一句话总结:通用能力别造轮子,产品差异不外包。
第二问:数据合规的账怎么算? 系统控件全部在端侧推理,证件照片、人脸数据不出设备,合规叙事非常干净。自己端模型同样可以端侧部署,但工程量和责任边界完全不同——模型质量、安全防护都是你的。两者都"数据不出端",但一个是系统替你保证,一个是你自己保证。
第三问:交互链路要不要系统接管? 卡证识别的场景化控件连拍摄引导、边缘检测、裁切框都做好了;自己端模型则意味着连 UI 流程都要自建。除非交互本身就是你的产品(比如相机应用),否则白送的系统链路没有拒绝的理由。
三个问题问完,决策基本就出来了:标准场景 + 无特殊交互 → 系统控件;标准场景 + 定制交互 → Core Vision Kit 基础 API 自组链路;长尾差异场景 → 自研模型,并且值得。大部分团队卡在"该不该自研"上空转,其实真正该自研的,从来只有第三种。
六、收尾:端侧是视觉 AI 的终局形态
回头看整个脉络:视觉 AI 这件事,行业早年走的是"云端识别"路线——图片上传、云端推理、结果回传。它好用,但两笔账躲不开:延迟(弱网卡成PPT)和隐私(证件照躺在了别人的服务器上)。
HarmonyOS 7 把基础能力和场景化控件直接开给应用,本质上是把这两笔账一次性结清:推理在端侧,延迟跟着芯片算力走,数据在设备上生也在设备上死。官方那句"低门槛、高效、安全",V哥认为重心在"安全"——当视觉能力的默认形态是端侧的,"数据不出端"就不再是应用的成本,而是系统的默认值。
给准备动手的同学三条落地建议:先去官方页把两个 Kit 的能力清单和限制条件读一遍(各能力支持的语言、机型、模式都有明确边界);用 Codelab 跑通一个控件再评估排期——按 V哥的经验,跑通的成本远低于你的心理预估;能力表现(识别准确率、超分效果)一律以自己业务图片的真机实测为准,官方没有承诺通用数字,V哥也不会替它编一个。
参考与出处
本文涉及的官方表述、能力清单与接口信息均来自以下页面:
- HarmonyOS 7 新能力一览(华为开发者联盟)——"视觉 AI 能力"官方原文
- HarmonyOS AI 能力与服务一览——Core Vision Kit / Vision Kit 定位与能力清单
- Vision Kit(场景化视觉服务)官方页——四大控件与服务场景
- Vision Kit Codelab(华为开发者官网)——活体检测接入流程与限制
- 图像超分开发指南(Core Vision Kit)
- imageSuperResolution API 参考
最后一句:视觉 AI 的下半场,比的不是谁训得出模型,而是谁把系统递到手边的能力接得快、用得稳——端侧的算力已经在那了,差的就是你 import 的那一行。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 1
 0
- 0


 已为社区贡献102条内容

所有评论(0)