HarmonyOS 7 端侧 AI 视觉能力实战 02:低清图片如何做超分增强
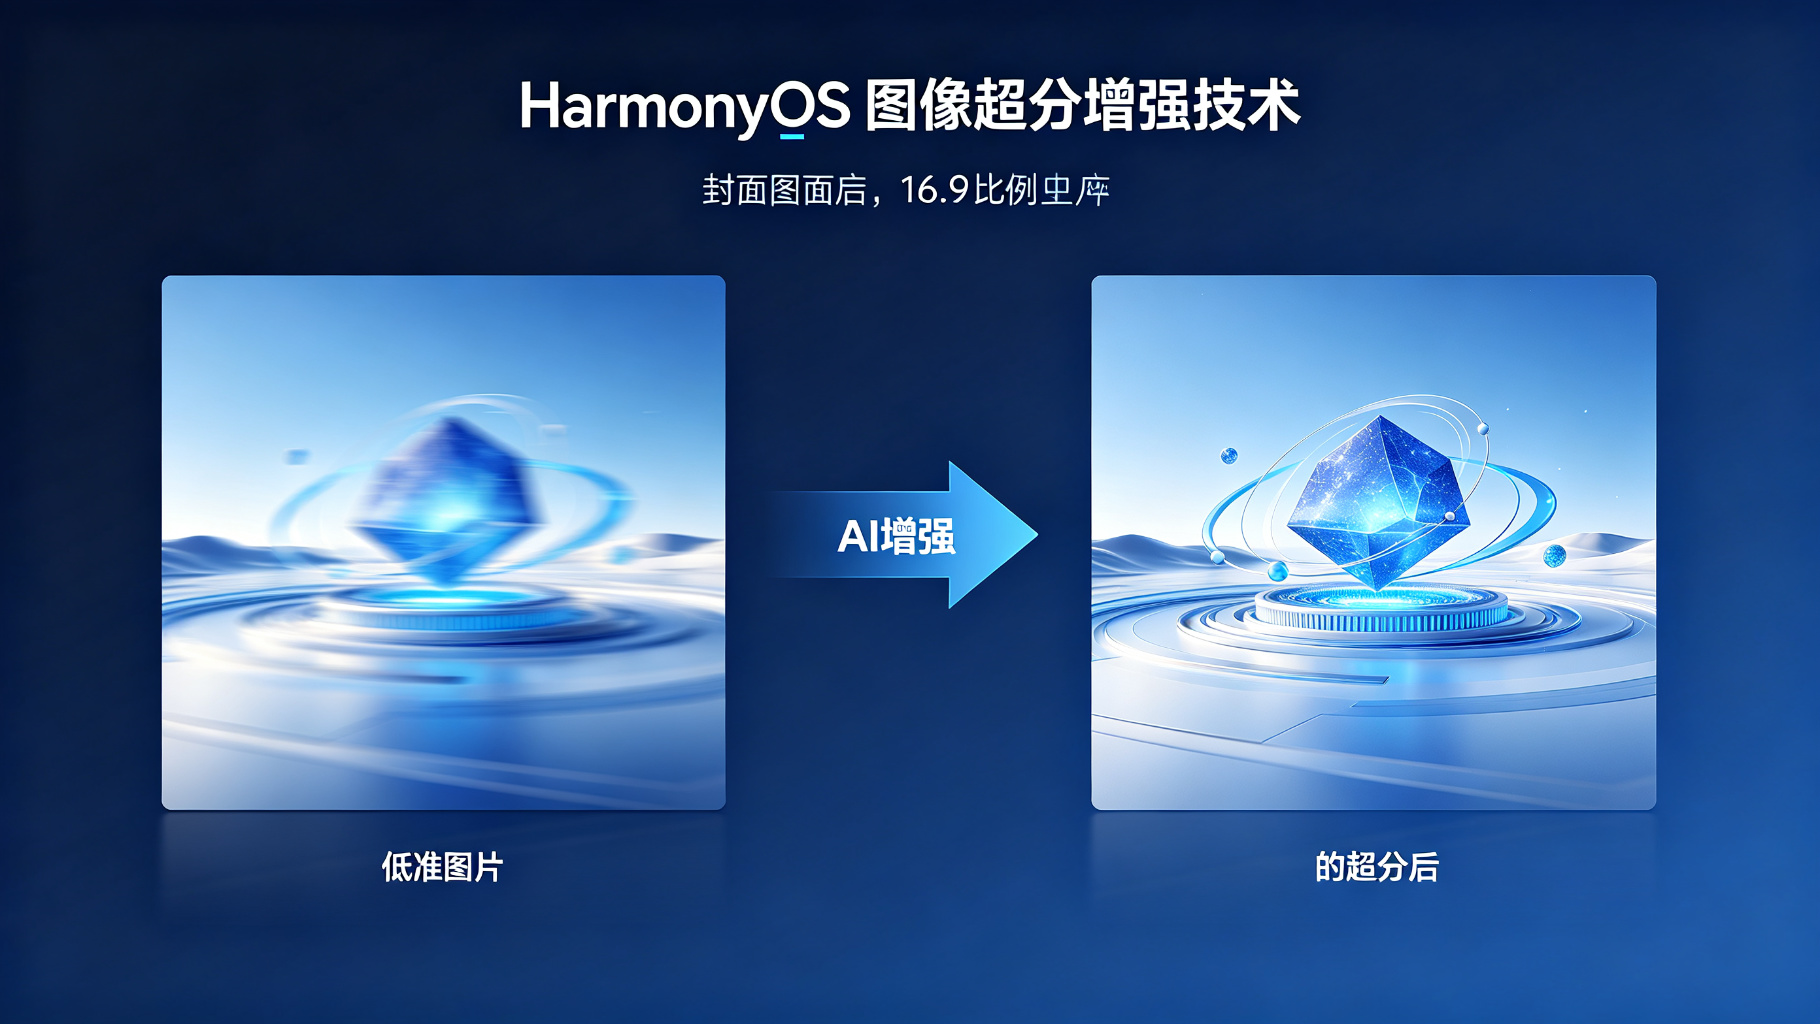
上一篇做了 OCR 文字识别,实际用下来发现一个问题:用户拍的图片经常是模糊的、低分辨率的,OCR 识别率就上不去。尤其是票据、截图这类内容,原始分辨率不高的时候,文字边缘都是锯齿,识别出来全是错的。
这时候就需要先把图片做超分增强,把低清图放大变清晰,再去做识别。HarmonyOS 7 有端侧的图像超分能力,这篇就讲讲怎么把它集成到我们的图片处理流程里。
一、真实开发中遇到的问题
最开始我们直接把原图丢给 OCR,测试的时候用清晰的图效果不错。但真用户上传的图什么都有——微信压缩过的截图、晚上拍的票据、分辨率只有 720p 的老照片。这些图直接识别,准确率能掉一半。
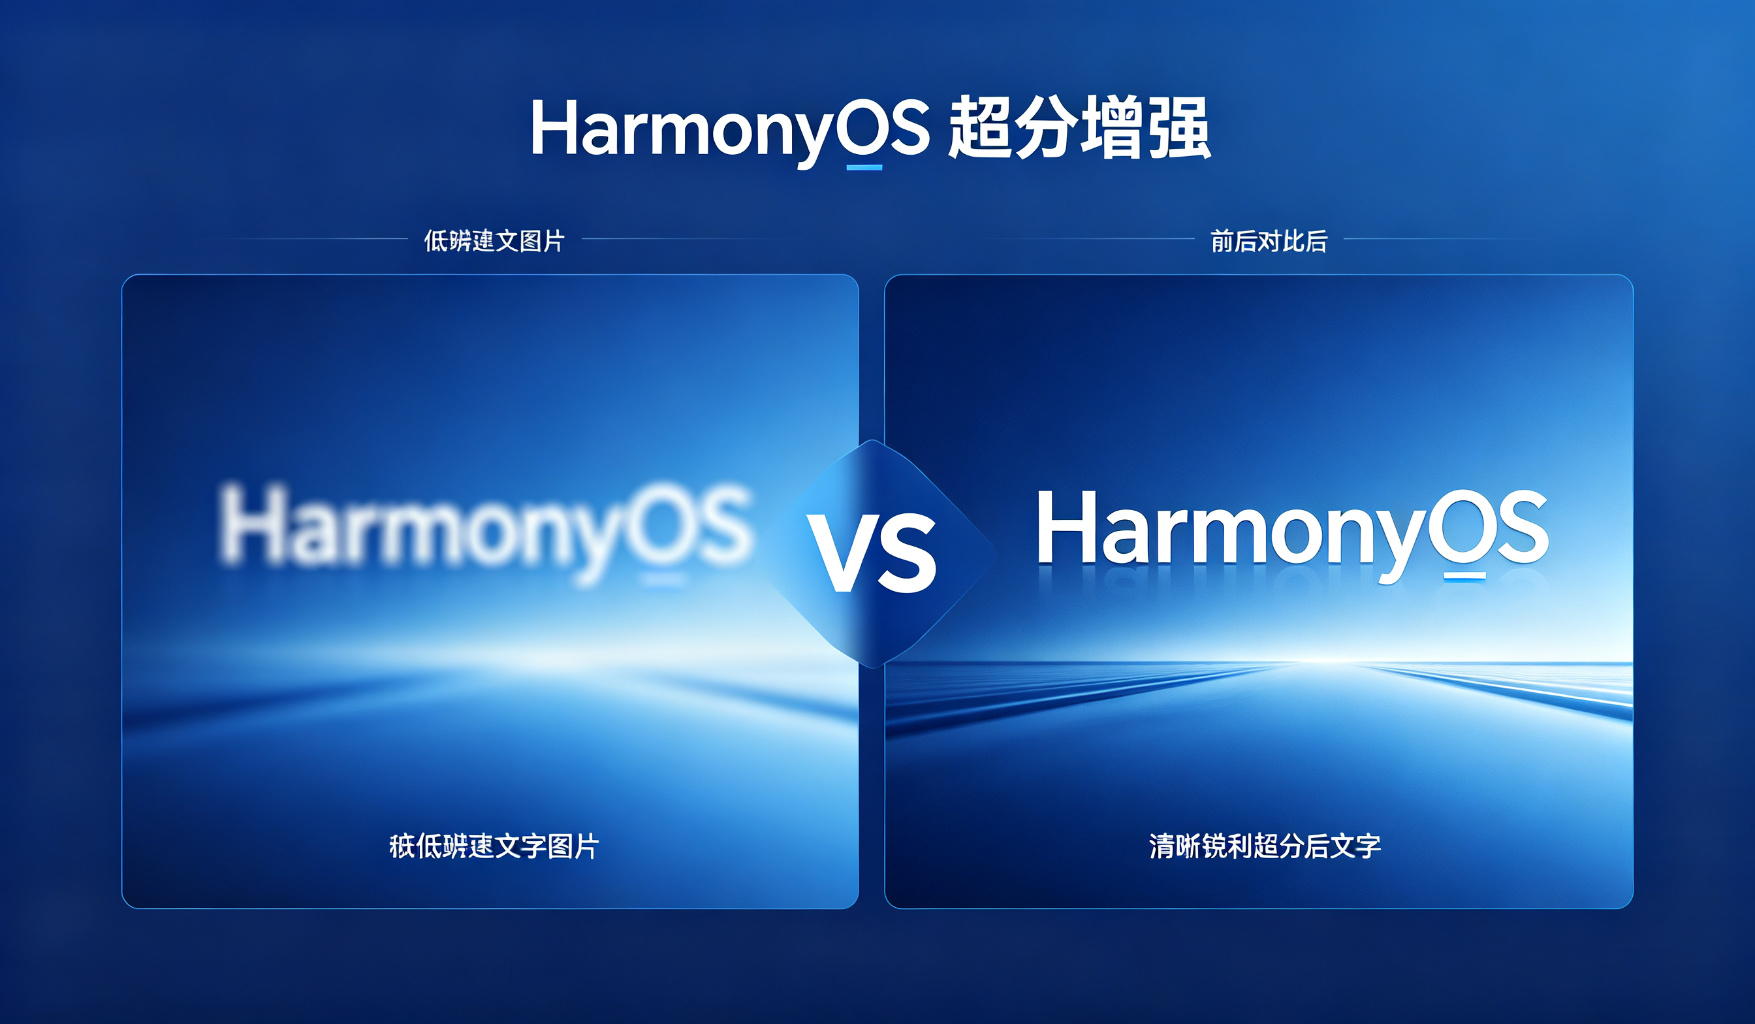
尝试过用普通的图像放大(比如双线性插值),放大是放大了,但边缘更模糊了,文字反而更难认。普通放大只是把像素拉大,没有补细节。
后来发现 HarmonyOS 7 的 ImageSuperResolution Kit 专门做这个——端侧 AI 超分,能把低清图放大 2 倍或者 4 倍,同时补出细节,文字边缘会变锐利。这正是我们需要的。
但接入的时候又遇到新问题:超分很慢,一张大图要好几秒;内存占用高,处理一张 4K 图直接占几百 MB;还有些图超分之后反而更糟,得判断什么时候该做超分。
二、这个能力怎么接入
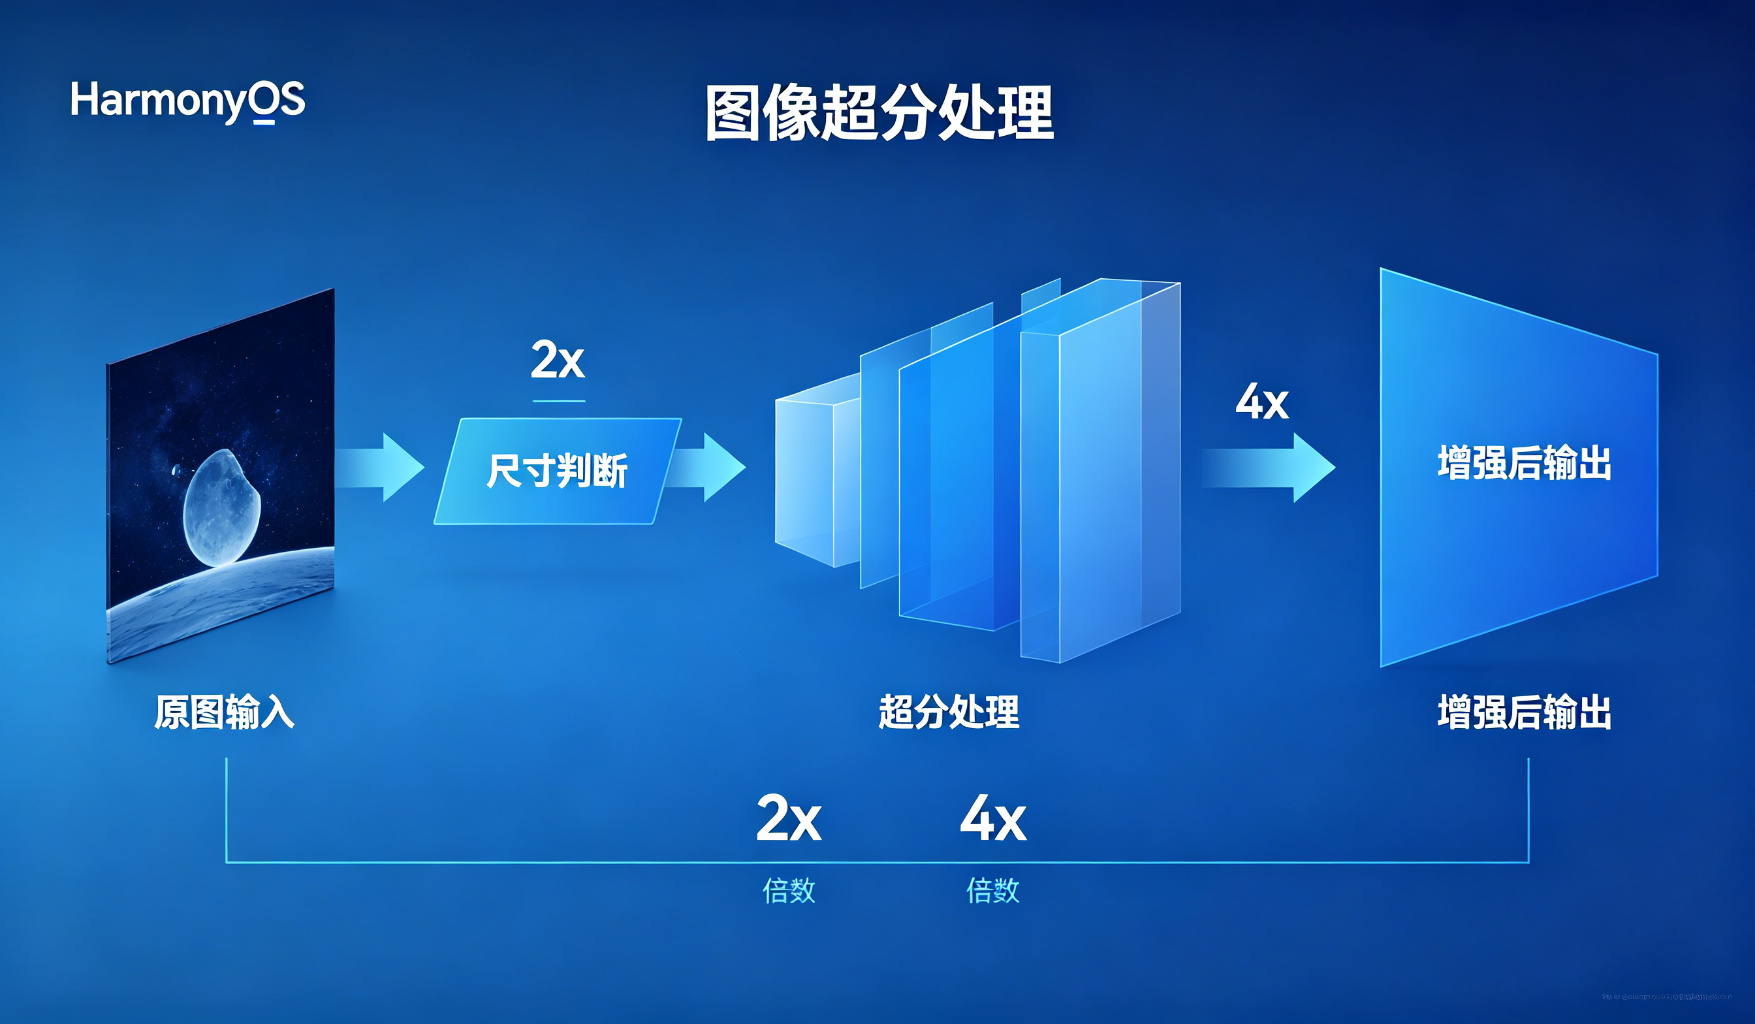
图像超分的接入思路和 OCR 类似:创建超分实例 → 传入 PixelMap → 异步处理 → 拿到增强后的图。
但有几个关键点要注意:
1. 先判断要不要超分:不是所有图都需要超分。已经很高清的图再做超分,纯属浪费性能。我们加了个判断:图片长边小于 1000px 才做超分,已经够清晰的直接跳过。
2. 控制输出尺寸:超分 4 倍之后图片会很大,4000×3000 的原图超分 4 倍就变成 16000×12000 了,内存直接爆。一般我们只超分 2 倍,够 OCR 识别用就行。
3. 异步处理:超分是 CPU/GPU 密集型操作,必须在子线程做,UI 上要显示 loading。
三、关键代码怎么写
下面是封装的超分工具类,文件位置在 entry/src/main/ets/utils/ImageSuperResolution.ets:
import { image } from '@kit.CoreImageKit';
import { imageSuperResolution } from '@kit.CoreImageKit';

export class ImageEnhanceUtil {
  private static superResolution: imageSuperResolution.ImageSuperResolution | null = null;

  // 判断是否需要超分
  private static needEnhance(pixelMap: image.PixelMap): boolean {
    const size = pixelMap.getImageInfoSync();
    const maxSide = Math.max(size.width, size.height);
    // 长边小于 1000px 才做超分
    return maxSide < 1000;
  }

  // 图片超分增强
  static async enhanceImage(
    pixelMap: image.PixelMap
  ): Promise<image.PixelMap> {
    // 不需要增强直接返回原图
    if (!this.needEnhance(pixelMap)) {
      return pixelMap;
    }

    try {
      // 创建超分实例(2倍放大)
      if (!this.superResolution) {
        this.superResolution = imageSuperResolution
          .createImageSuperResolution();
      }

      // 执行超分
      const enhancedMap = await this.superResolution.enhance(
        pixelMap,
        2 // 放大倍数:2x 或 4x
      );

      return enhancedMap;
    } catch (e) {
      console.error('Enhance failed: ' + e.message);
      // 超分失败返回原图,不要让流程中断
      return pixelMap;
    }
  }

  // 释放资源
  static release() {
    if (this.superResolution) {
      this.superResolution.release();
      this.superResolution = null;
    }
  }
}
这段代码的核心:needEnhance 先判断要不要做,不做就直接返回原图。enhance 方法异步执行超分,失败了也返回原图,不影响主流程。
在页面里怎么用?和 OCR 串起来,文件位置 pages/EnhancePage.ets:
@Entry
@Component
struct EnhancePage {
  @State originalPath: string = '';
  @State enhancedPath: string = '';
  @State isProcessing: boolean = false;

  async onImageSelected(pixelMap: image.PixelMap) {
    this.isProcessing = true;

    // 1. 先做超分增强
    const enhancedMap = await ImageEnhanceUtil.enhanceImage(pixelMap);

    // 2. 再把增强后的图传给 OCR
    const ocrResult = await OcrUtil.extractTextFromImage(enhancedMap);

    this.isProcessing = false;

    // 3. 显示结果
    console.info('OCR result: ' + ocrResult.text);

    // 释放 PixelMap
    pixelMap.release();
    if (enhancedMap !== pixelMap) {
      enhancedMap.release();
    }
  }
}
这里的处理链是:选图 → 超分增强 → OCR 识别 → 显示结果。每一步都有异常兜底,某一步失败了用原图继续,不让整个流程挂掉。
四、运行过程中怎么处理异常
超分的异常场景比 OCR 多:
1. 超分失败:极少数情况下模型加载失败或者图片格式不支持。catch 住异常,返回原图,OCR 该怎么做还怎么做,不要因为超分失败就中断整个流程。
2. 内存不足:大图超分特别吃内存。我们限制了输入图片的最大尺寸,超过 2000px 的图先压缩再处理,不然 OOM 直接崩。
3. 处理时间太长:超分一张图要 2-3 秒,用户可能以为卡了。UI 上要显示进度条或者 loading,并且在后台线程处理,不阻塞 UI。
4. 效果不明显:有些图超分之后提升不大,但处理时间一样长。我们加了个简单的判断:如果原图已经很清晰(比如文字边缘锐利),就跳过超分步骤。
五、实际开发中容易忽略的问题
1. 释放 PixelMap:超分会生成新的 PixelMap,用完一定要 release()。不然连续处理几张图,内存就涨上去了。
2. 超分倍数不是越高越好:4 倍超分效果确实更好,但处理时间和内存占用都是 2 倍的。一般用 2 倍就够了,OCR 识别率提升明显,性能开销也小。
3. 超分和 OCR 的顺序:先超分再识别,不要反过来。OCR 识别完了再超分没意义。
4. 批量处理要串行:不要同时处理多张图,超分很吃资源,并行处理直接 OOM。一张一张来。
5. 端侧能力有限:超分是在手机本地跑的,不是云端。太复杂的图效果有限。如果用户对效果要求很高,可以引导上传到云端处理,但那是另一个故事了。
超分增强是视觉处理链里很重要的一环。把低清图变清晰,后面的 OCR、人脸检测、分类这些能力准确率都会跟着提升。后面几篇会继续在这个基础上加能力。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献70条内容

所有评论(0)