茶器艺科智造HarmonyOS应用实战-19-indexOf寻找tab等号,notab为什么也能命中:按查询参数边界解析深链
茶器艺科智造HarmonyOS应用实战-19-indexOf寻找tab等号,notab为什么也能命中:按查询参数边界解析深链
外部入口传来 chaqi://entry?notab=2,页面却可能把它当成 tab=2;传来 chaqi://entry?tab=2#archive,当前数值层又可能悄悄接受前面的 2。这不是页面切换逻辑出了问题,而是 URI 还没有按“查询参数”拆开,就先用 indexOf('tab=') 在整串文本里找了子串。路径、参数名的一部分、fragment 都可能被误当成查询值来源。
指定工程的 libraryhar/src/main/ets/routes/ChaqiRouteIntent.ets 已经负责深链解析,并对值调用 decodeURIComponent。但它没有先定位 ? 与 #,也没有把 & 分隔后的 token 拆成精确的键和值。本文只解决这层词法边界:什么才算一个名为 tab 的查询参数、编码失败怎样表达、fragment 在哪里截断、重复键采用什么规则。URI 与 Want.parameters 的覆盖先后已属于系列第 02 篇,本篇不重新讨论;数字是否全串合法则交给第 20 篇。
本文会完成四件事:
- 用源码锚点还原
indexOf方案的当前行为,而不是根据现象猜测。 - 给查询区、token、键、值和 fragment 写出可执行的边界规则。
- 设计一个不依赖 UIAbility 的纯 ArkTS 解析器,并保留“缺失、空值、编码损坏”的差异。
- 给出覆盖精确键、编码、fragment、重复键和恶意长输入的验证矩阵。
一、源码锚点表明当前函数搜索的是整条 URI
当前实现位于 libraryhar/src/main/ets/routes/ChaqiRouteIntent.ets:78。核心代码从完整 URI 中直接寻找 `${key}=`,找到后只以随后第一个 & 作为结束位置:
function queryParamFromUri(uri: string, key: string): string {
  if (uri.length === 0) {
    return '';
  }
  const needle = `${key}=`;
  let from = uri.indexOf(needle);
  if (from < 0) {
    return '';
  }
  from += needle.length;
  const amp = uri.indexOf('&', from);
  const end = amp >= 0 ? amp : uri.length;
  const raw = uri.substring(from, end);
  try {
    return decodeURIComponent(raw);
  } catch (_e) {
    return raw;
  }
}
这段代码做到了两件有用的事:空 URI 很快返回,正常值也会进行百分号解码。问题在于它没有回答“命中的 tab= 是否处于查询 token 的开头”。indexOf 只知道字符位置,不知道当前位置前面是 ?、&、字母、斜杠还是 #。因此函数名虽然是 queryParamFromUri,实际搜索域却是整条 URI。
下游 queryRouteParam 把空字符串同时当成“URI 中没有该键”和“URI 中明确写了空值”。这个差异会影响兜底来源,但那属于组合协议;本篇先让 URI 侧返回带状态的结果,避免上层继续靠字符串长度猜含义。
二、notab=2 命中的原因可以逐字符复现
对 chaqi://entry?notab=2 调用 queryParamFromUri(uri, 'tab') 时,needle 是 tab=。它正好出现在 notab= 的后四个字符中,所以 indexOf 返回非负位置。函数随后把游标移动到等号后,截出 2 并返回。整个过程没有任何一步读取参数名 notab。
下面这组输入可以直接暴露搜索域过宽:
chaqi://entry?tab=2                 -> 当前返回 "2",符合预期
chaqi://entry?notab=2               -> 当前返回 "2",误命中参数名后缀
chaqi://entry?mytab=1&tab=3         -> 当前返回 "1",抢在真正 tab 前命中
chaqi://entry/path/tab=2?x=1        -> 当前返回 "2?x=1",把路径当查询区
chaqi://entry#panel?tab=2            -> 当前返回 "2",把 fragment 当查询区
chaqi://entry?tab=2#archive          -> 当前返回 "2#archive",没有在 # 截断
真正需要满足的条件不是“某处出现 tab=”,而是:先找到 ? 后、# 前的查询区;再按 & 拆 token;token 的键解码后必须与 tab 全等。只要把这三个动作按顺序执行,notab、路径和 fragment 就没有机会混进来。
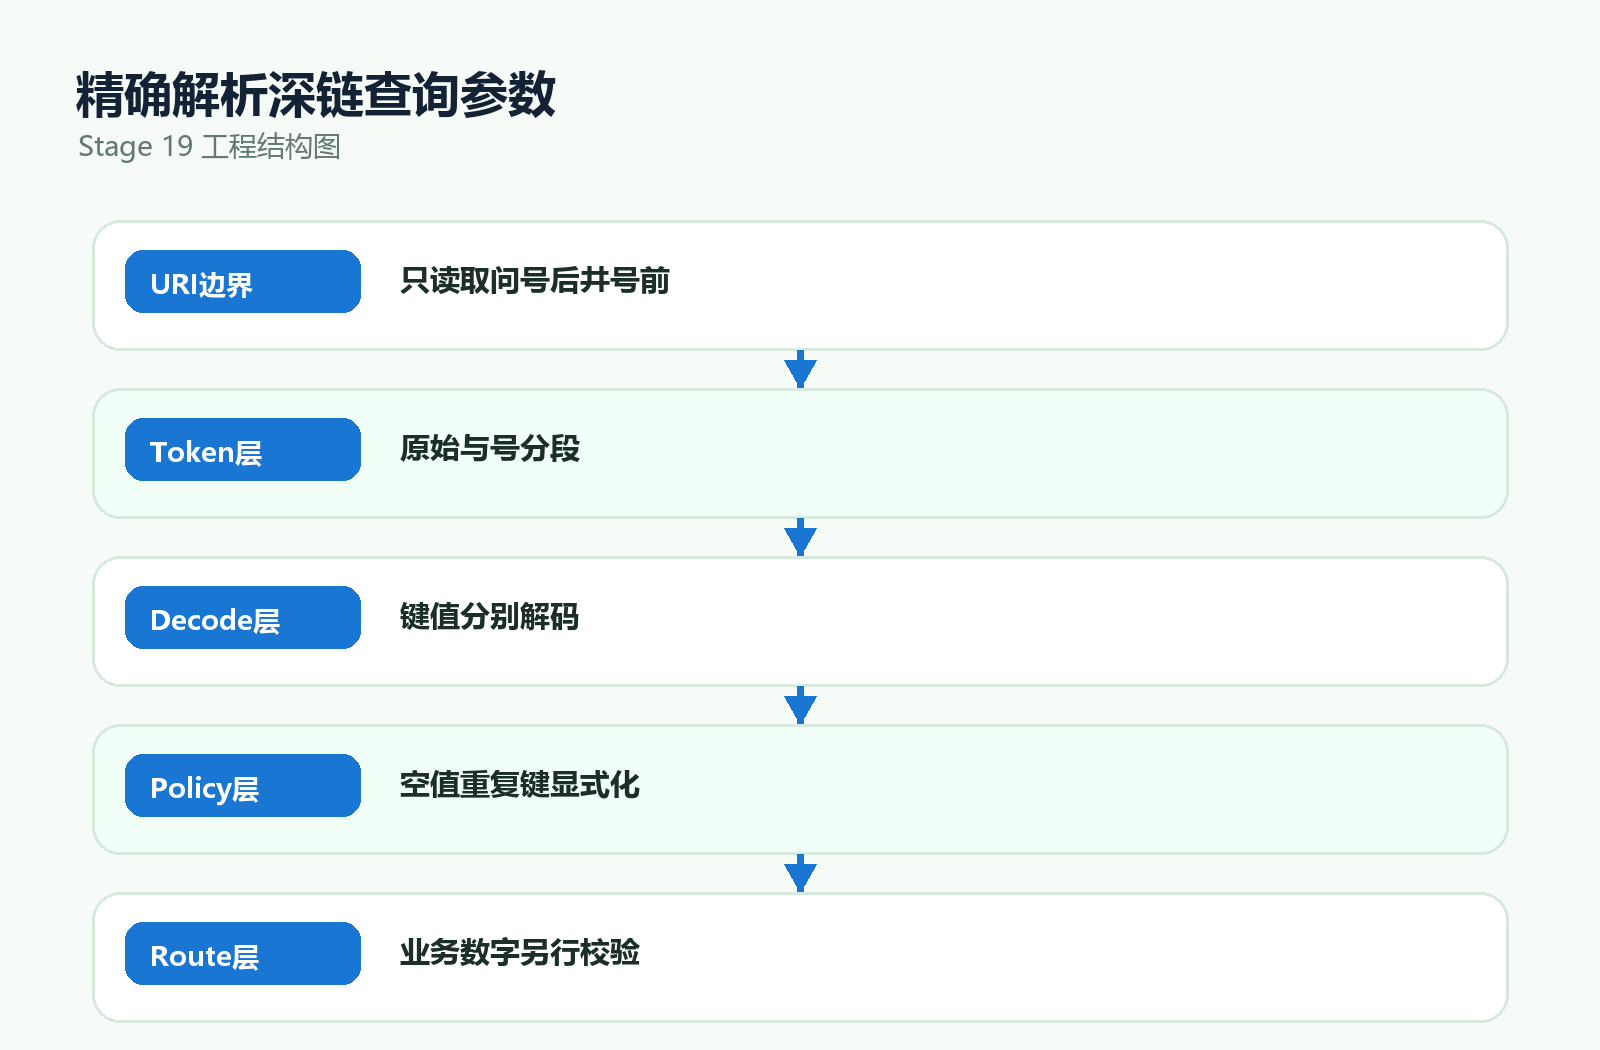
图中把 URI 切分、token 化、键值分离、解码和策略判定分成独立阶段。每一阶段都能返回明确结果,排查时也能知道错误发生在哪一层。
三、先定义查询语法,再选择实现手段
茶器深链不需要实现所有浏览器 URL 规则,但必须明确自己的最小语法。建议把协议写成下面六条:
| 规则 | 本文约定 | 示例 |
|---|---|---|
| 查询开始 | 第一个 ? 之后 | /path?tab=1 |
| 查询结束 | # 之前或 URI 末尾 | ?tab=1#slice 中值为 1 |
| token 分隔 | 原始查询串中的 & | tab=1&generate=1 |
| 键值分隔 | token 中第一个 = | memo=a=b 的值为 a=b |
| 键比较 | 百分号解码后精确、区分大小写 | tab 命中,Tab 不命中 |
| 重复键 | 首个有效 token 胜出,同时报告重复 | tab=1&tab=2 取 1 并留问题码 |
这里有两个刻意的决定。第一,查询区切分必须在解码之前完成;如果先把 %26 解码成 &,值内部的编码字符会被误当成 token 分隔符。第二,# 的截断也必须在值解码前完成,因为 fragment 不属于查询值。
可以用一个窄类型承载结果,避免让 '' 同时承担三种语义:
export type QueryTokenState =
  | 'ABSENT'
  | 'VALUE'
  | 'EMPTY'
  | 'MALFORMED';

export interface QueryTokenResult {
  state: QueryTokenState;
  value: string;
  tokenIndex: number;
  duplicateCount: number;
  issueCode: string;
}
ABSENT 表示查询区没有这个键;EMPTY 表示调用方明确写了 tab=;MALFORMED 表示键或值无法按约定解码;VALUE 才携带可交给下一层的字符串。tokenIndex 与 issueCode 适合测试和脱敏日志,不能把完整外部 URI 当作诊断字段长期记录。
四、纯解析器要先框定查询区,再逐个比较键
以下是建议实现,尚未写入指定项目。它不导入 Want,输入和输出都是普通值,因此本地单元测试可以直接覆盖。为适应 ArkTS 的静态类型约束,返回对象均对应显式接口,没有使用无类型对象作为跨层契约。
function absentQuery(): QueryTokenResult {
  return {
    state: 'ABSENT', value: '', tokenIndex: -1,
    duplicateCount: 0, issueCode: ''
  };
}

function malformedQuery(index: number, code: string): QueryTokenResult {
  return {
    state: 'MALFORMED', value: '', tokenIndex: index,
    duplicateCount: 0, issueCode: code
  };
}

function querySlice(uri: string): string {
  const question = uri.indexOf('?');
  if (question < 0) {
    return '';
  }
  const fragment = uri.indexOf('#', question + 1);
  const end = fragment >= 0 ? fragment : uri.length;
  return uri.substring(question + 1, end);
}
querySlice 只负责结构边界,不尝试理解数字或业务键。它从 ? 后开始,并只接受该位置之后的 # 作为结束符。这样即使路径里含有 tab=2,只要查询区没有 tab token,就会得到 ABSENT。
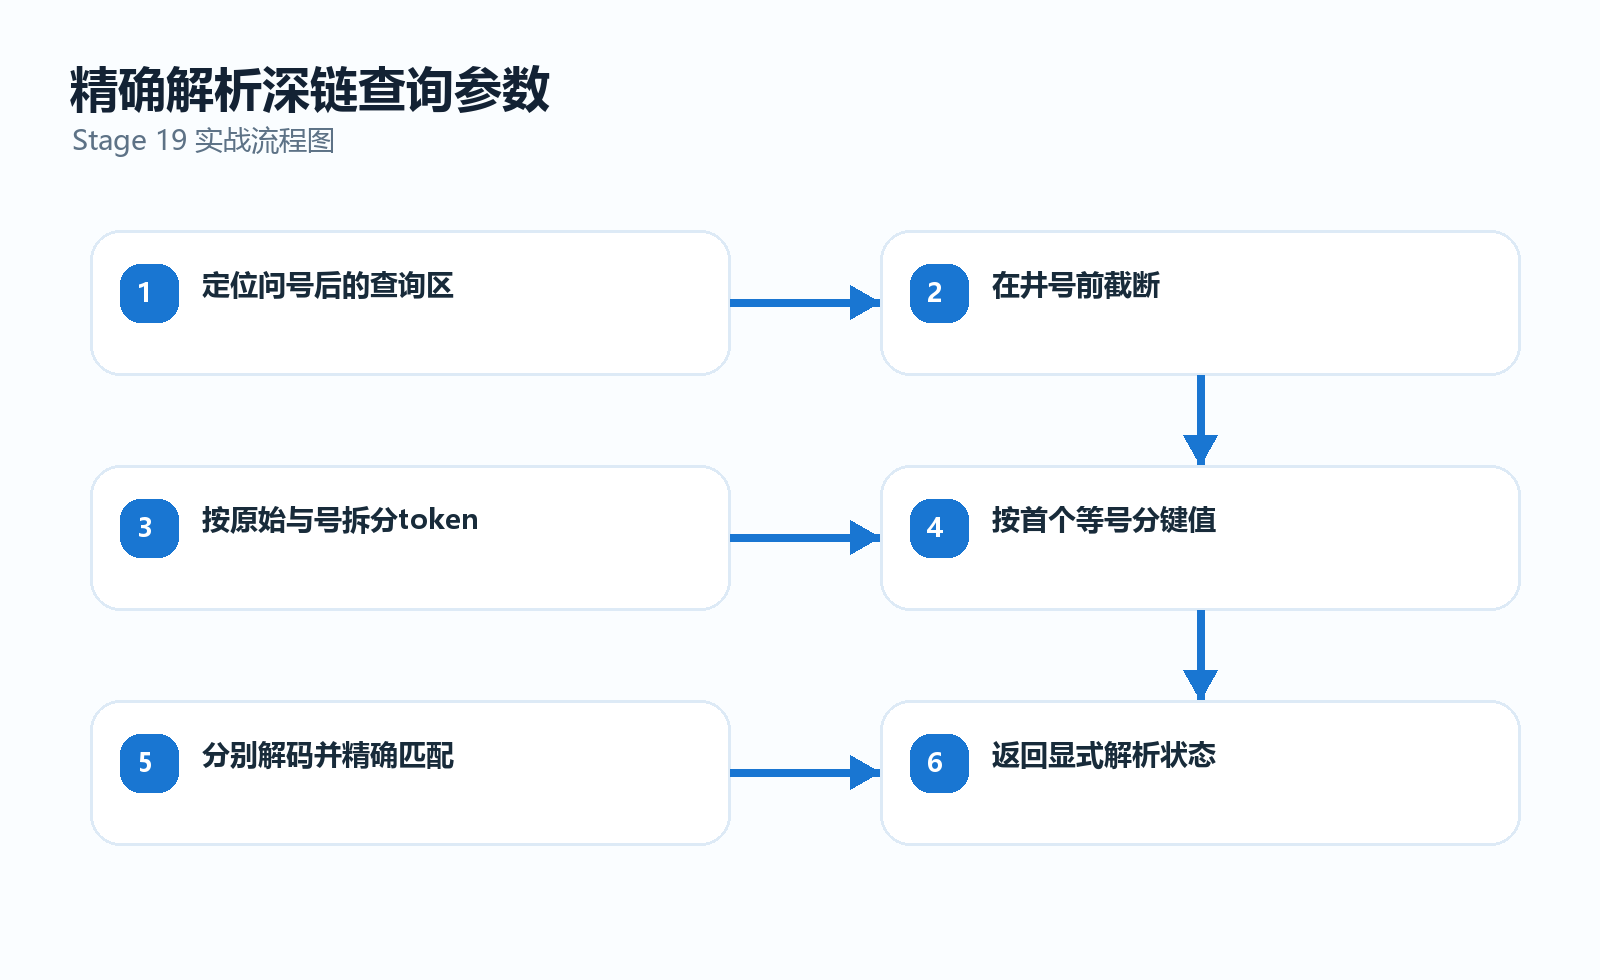
结构图把纯 URI 解析与业务路由分开:前四层只产出可解释的文本结果,Route 层才决定某个键的领域含义。这样修改 tab 的合法范围时,不会反过来影响 fragment 与编码规则。
接着对原始查询串按 & 分段,并只用 token 中第一个等号切键值:
interface DecodedPart {
  ok: boolean;
  value: string;
}

function decodePart(raw: string): DecodedPart {
  try {
    return { ok: true, value: decodeURIComponent(raw) };
  } catch (_e) {
    return { ok: false, value: '' };
  }
}

export function queryTokenFromUri(uri: string, expectedKey: string): QueryTokenResult {
  const query = querySlice(uri);
  if (query.length === 0) {
    return absentQuery();
  }

  const tokens = query.split('&');
  let first: QueryTokenResult = absentQuery();
  let matches = 0;
  for (let i = 0; i < tokens.length; i++) {
    const token = tokens[i];
    const equal = token.indexOf('=');
    const rawKey = equal >= 0 ? token.substring(0, equal) : token;
    const key = decodePart(rawKey);
    if (!key.ok) {
      continue;
    }
    if (key.value !== expectedKey) {
      continue;
    }
    matches++;
    if (matches > 1) {
      continue;
    }
    if (equal < 0) {
      first = malformedQuery(i, 'QUERY_VALUE_SEPARATOR_MISSING');
      continue;
    }
    const value = decodePart(token.substring(equal + 1));
    if (!value.ok) {
      first = malformedQuery(i, 'QUERY_VALUE_ENCODING_INVALID');
    } else {
      first = {
        state: value.value.length === 0 ? 'EMPTY' : 'VALUE',
        value: value.value,
        tokenIndex: i,
        duplicateCount: 0,
        issueCode: ''
      };
    }
  }
  first.duplicateCount = Math.max(0, matches - 1);
  return first;
}
这段代码的边界很窄:只负责找到精确键并安全解码,不判断 tab 是否在 0–3,也不把 generate=yes 转成布尔值。分层后,查询词法错误和业务值错误能分别测试;将来扩展 preset、heightMm 时也不必复制一套 indexOf。
五、编码处理的关键是“先分隔、后解码”
当前代码对值调用 decodeURIComponent,但不解码键。若协议允许调用方把键写成 %74ab=2,旧实现不会命中;建议解析器会把 %74ab 解码成 tab 后精确匹配。是否允许编码键必须写进协议,不能由偶然实现决定。
值中的编码分隔符更能说明顺序:
chaqi://entry?memo=a%26b&tab=%32#archive

原始查询区:memo=a%26b&tab=%32
原始 token 1:memo=a%26b
原始 token 2:tab=%32
解码后 memo:a&b
解码后 tab:2
fragment:archive,不进入任何查询值
如果先解码整段查询,a%26b 会变成 a&b,随后 split 就错误地产生额外 token。正确顺序是先依据原始 & 拆分,再分别解码键和值。
百分号编码损坏也不能“catch 后返回原串”。例如 tab=%32%ZZ 解码失败,若原串继续流入宽松数字函数,前缀仍可能被接受。词法层应该返回 MALFORMED/QUERY_VALUE_ENCODING_INVALID,数字层根本不再解析它。这里的拒绝是协议事实,不依赖页面最终怎样提示用户。
六、fragment、空值和重复键需要各自的契约
# 后的 fragment 通常用于客户端定位或显示状态,不应成为查询值的一部分。当前函数只寻找 &,因此 ?tab=2#archive 会返回 2#archive;随后 parseInt 又会接受前缀 2,两层宽松行为叠加后,错误在界面上完全不可见。
空值与缺失也不能都返回 '':
const missing = queryTokenFromUri('chaqi://entry?generate=1', 'tab');
// missing.state === 'ABSENT'

const empty = queryTokenFromUri('chaqi://entry?tab=&generate=1', 'tab');
// empty.state === 'EMPTY'

const bare = queryTokenFromUri('chaqi://entry?tab&generate=1', 'tab');
// bare.state === 'MALFORMED'
这三种输入是否最终采用其他来源,由上层协议决定;URI 解析器的职责是如实保留差异。
重复键则需要公开策略。本文建议“首个精确键胜出,同时 duplicateCount > 0”。选择第一个值是为了保持与旧实现对正常重复键的基本方向一致,同时让调用方能够拒绝含冲突值的外部请求。若安全要求更高,可以在组合层把任何重复键直接判成无效;不要在不同业务字段上悄悄采用不同规则。
七、与 Want 的连接只传状态,不再靠空字符串猜测
ChaqiRouteIntent.ets:127 的当前 queryRouteParam 以 fromUri.length > 0 判断 URI 是否提供了参数。这会把明确空值当成未提供。修正查询解析后,上层应按状态做一次很薄的适配。下面只是接口连接方式,不重新定义系列第 02 篇讨论的来源时序:
interface RouteTextInput {
  provided: boolean;
  valid: boolean;
  value: string;
  issueCode: string;
}

function routeTextFromUri(uri: string, key: string): RouteTextInput {
  const result = queryTokenFromUri(uri, key);
  if (result.state === 'ABSENT') {
    return { provided: false, valid: true, value: '', issueCode: '' };
  }
  if (result.state !== 'VALUE') {
    return {
      provided: true,
      valid: false,
      value: '',
      issueCode: result.issueCode.length > 0 ? result.issueCode : 'QUERY_VALUE_EMPTY'
    };
  }
  return { provided: true, valid: true, value: result.value, issueCode: '' };
}
调用层只看到“有没有提供、是否有效、值是什么”,不需要知道 token 位于第几个字符。这样解析器可留在 HAR 的纯函数文件,Ability 适配层只负责把 Want.uri 与 Want.parameters 转成协议输入。华为的 Want 文件处理示例也将 uri 与 parameters 列为不同字段;业务协议仍需自行定义各自的校验方式。
八、单元用例要覆盖相邻字符,而不只测四个合法 tab
只写 tab=0 到 tab=3 会让旧函数全部通过。查询边界测试应围绕“前一个字符和后一个字符是什么”设计。建议先在纯解析器层建立下面这组表,再由业务数字层验证范围:
it('matches exact key only', 0, () => {
  expect(queryTokenFromUri('chaqi://entry?tab=2', 'tab').value)
    .assertEqual('2');
  expect(queryTokenFromUri('chaqi://entry?notab=2', 'tab').state)
    .assertEqual('ABSENT');
  expect(queryTokenFromUri('chaqi://entry?mytab=1&tab=3', 'tab').value)
    .assertEqual('3');
});

it('cuts fragment before decoding', 0, () => {
  expect(queryTokenFromUri('chaqi://entry?tab=%32#archive', 'tab').value)
    .assertEqual('2');
  expect(queryTokenFromUri('chaqi://entry#panel?tab=2', 'tab').state)
    .assertEqual('ABSENT');
});

it('keeps empty malformed and duplicate visible', 0, () => {
  expect(queryTokenFromUri('chaqi://entry?tab=', 'tab').state)
    .assertEqual('EMPTY');
  expect(queryTokenFromUri('chaqi://entry?tab', 'tab').state)
    .assertEqual('MALFORMED');
  expect(queryTokenFromUri('chaqi://entry?tab=1&tab=2', 'tab').duplicateCount)
    .assertEqual(1);
});
指定工程当前 libraryhar/src/test/LocalUnit.test.ets 只有通用字符串包含示例,尚未覆盖路由解析。由于 queryParamFromUri 等函数都是 private 文件函数,现有测试也无法直接导入;第 22 篇会专门处理纯解析器的可测试导出边界。
九、验证矩阵要区分词法结果与页面结果
| 场景 | 纯解析器预期 | 数字层预期 | 页面/集成观察 |
|---|---|---|---|
?tab=2 | VALUE('2') | 由第 20 篇判为合法 2 | 请求指定 Tab |
?notab=2 | ABSENT | 不执行 | 不应因该键切 Tab |
?mytab=1&tab=3 | VALUE('3') | 合法 3 | 只采用精确 tab |
?tab=%32 | VALUE('2') | 合法 2 | 与明文 2 一致 |
?tab=2#archive | VALUE('2') | 合法 2 | fragment 不污染值 |
#panel?tab=2 | ABSENT | 不执行 | fragment 中伪查询无效 |
?tab=%32%ZZ | MALFORMED | 不执行 | 记录脱敏问题码 |
?tab= | EMPTY | 按协议拒绝 | 不与缺失混为一谈 |
?tab=1&tab=2 | 首值 1,重复数 1 | 可由组合层拒绝 | 行为需与协议一致 |
| 超长键值 | 长度门禁前后可追踪 | 不执行或拒绝 | 不阻塞主线程 |
前三列可以由纯函数测试验证,最后一列需要在完整应用入口观察。若没有执行 HAP、URI 拉起或真机步骤,就只能报告静态设计与用例预期,不能声称页面已经修复。
十、故障排查从“命中位置”转向“解析阶段”
| 现象 | 优先排查 | 常见根因 | 修正方向 |
|---|---|---|---|
notab 仍能切页 | 是否仍调用旧 indexOf 函数 | 新解析器未接入所有键 | 搜索旧调用并统一入口 |
%26 把值拆成两段 | split 与 decode 顺序 | 先解码整段查询 | 先按原始 & 分段 |
#archive 出现在值里 | 查询结束位置 | 只找 &,没有找 # | ? 后先截 fragment |
tab= 被其他来源覆盖 | 结果是否只返回 string | EMPTY 与 ABSENT 合并 | 返回显式状态 |
| 重复键结果不稳定 | 是否公开了重复策略 | 不同调用点各自查找 | 一个纯解析器统一策略 |
| 编码错误仍进入数字层 | catch 后是否返回 raw | 损坏值被继续容错 | 以 MALFORMED 阻断 |
日志建议记录 issueCode、键名白名单、tokenIndex、duplicateCount 和 URI 长度,不记录完整 URI。深链可能携带用户或业务信息,排错便利不能成为无界日志的理由。
源码锚点给出的当前事实是:queryParamFromUri 在完整 URI 上搜索 ${key}=,只以 & 截断,并在解码异常时返回原串;queryRouteParam 再用字符串是否为空判断 URI 侧是否命中。本文给出的 token 化解析器、结果类型、重复键规则和用例都是建议实现,尚未修改 D:\ProgramData\huawei\lesson\chaqi-app-gitee-master。本次文章整理也没有运行 hvigorw assembleHap --no-daemon、本地单测、模拟器、真机 URI 拉起或 CSDN 上传发布。能确认的是源码位置、当前字符级行为和静态可执行方案;运行效果仍需按验证矩阵补证据。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 1
 0
- 0


 已为社区贡献283条内容

所有评论(0)