HarmonyOS 7 本地数据与持久化实战 02:表结构升级、事务与并发更新怎么处理
第一版数据库跑得挺稳,收藏、草稿、历史记录都正常。到了第二版,产品说要给收藏加一个"同步状态"字段,还要加一张"草稿快照"表。问题这才真正来了。
开发环境好办,删了数据库文件重新跑一遍就行。但用户手机里的旧数据不能跟着一起删——用户收藏了几百条东西,你一升级全没了,第二天就等着收差评吧。
说白了,这里要解决的就是"在不丢数据的前提下完成表结构变更"这个问题。它涉及版本升级检测、字段迁移、事务保护、批量写入、并发修改,每一个环节处理不好都可能导致用户数据丢失或损坏。
一、版本升级最忌讳的就是删库重建
先说说我踩过的坑。
第一次做数据库升级的时候,图省事,在 onCreate 里加了 DROP TABLE IF EXISTS favorite 然后 CREATE TABLE。开发环境测了没问题,就发出去了。结果用户一升级,收藏全没了。客服反馈过来的时候我才意识到:开发环境删库重建没问题,但用户环境绝对不能这么干。
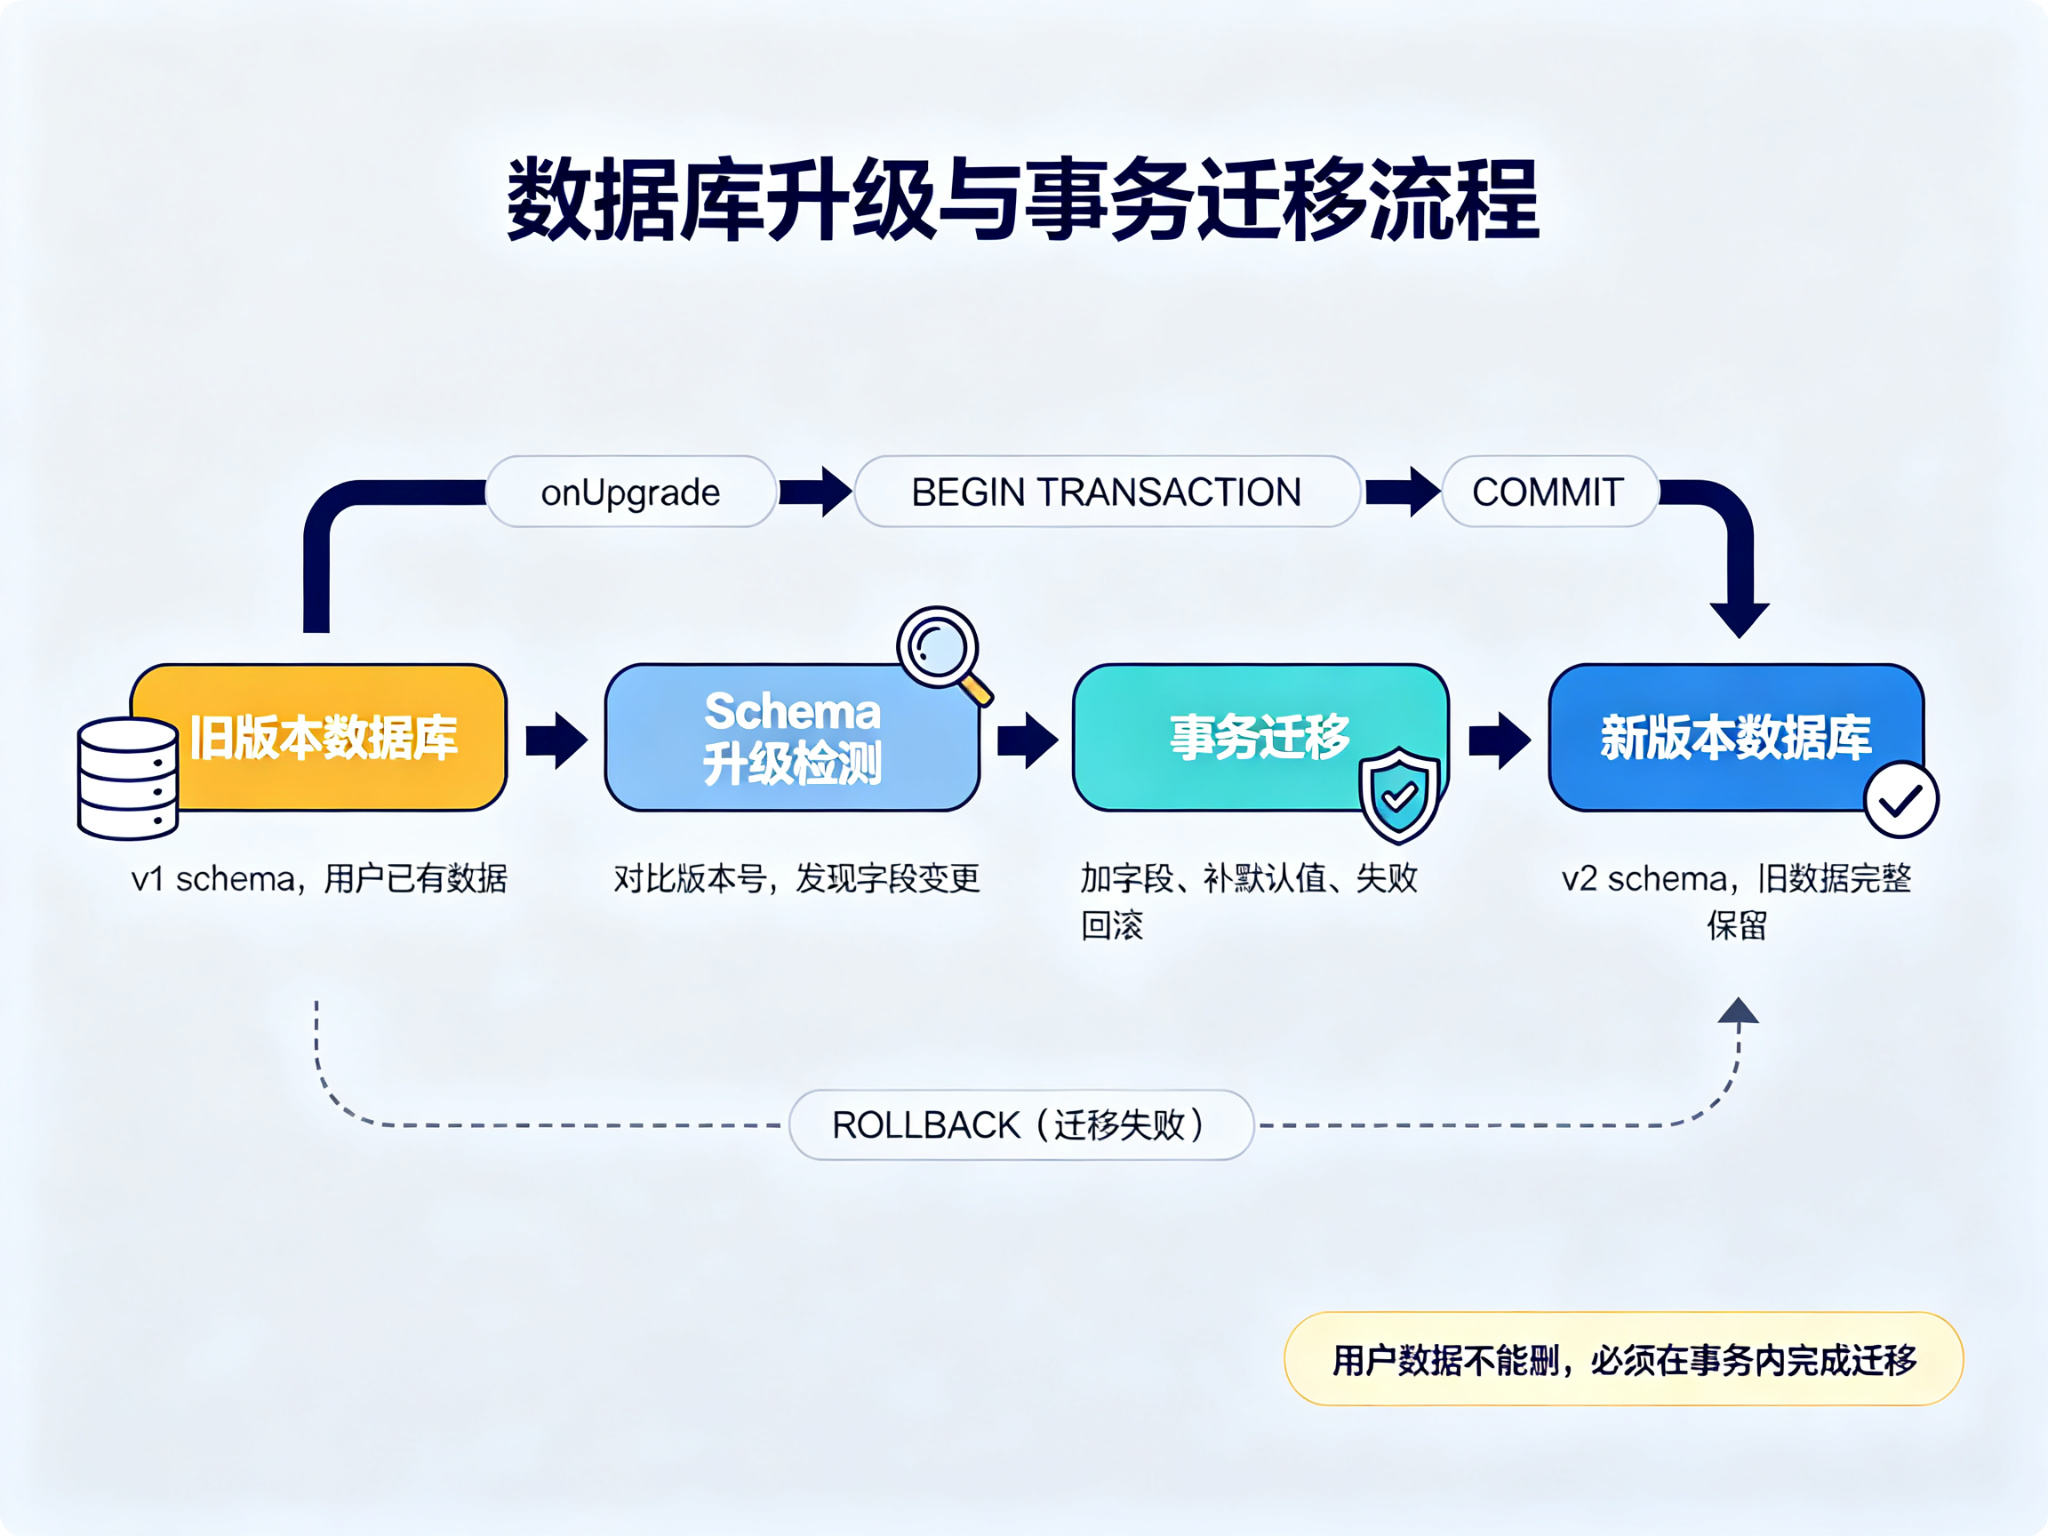
正确的做法是用 RelationalStore 的版本号机制。创建数据库时指定一个 version 号,当新版本的 version 大于旧版本时,系统会回调 onUpgrade,在这个回调里做迁移逻辑。
我的做法是:给 StoreConfig 加上 version 字段,每次数据库结构变更时递增 version。然后实现一个 RdbOpenCallback,在 onUpgrade 里根据 oldVersion 和 newVersion 做对应的迁移。
这里有个关键的设计决定:迁移逻辑要按版本号逐步执行,而不是直接从旧版跳到新版。比如用户可能从 v1 直接升级到 v3,这时候要先执行 v1→v2 的迁移,再执行 v2→v3 的迁移。如果只写了 v2→v3 的逻辑,v1 的用户就会漏掉 v1→v2 的变更。
二、字段迁移要在事务里做
onUpgrade 回调里最常见的操作就是加字段。比如给 favorite 表加一个 sync_status 字段,SQL 很简单:ALTER TABLE favorite ADD COLUMN sync_status INTEGER DEFAULT 0。
但加字段只是第一步。如果新字段有业务含义,比如 sync_status 表示"是否已同步到云端",那旧数据里这个字段应该设成什么值?如果设成 0(未同步),那旧数据会被重新同步一遍,可能产生重复。如果设成 1(已同步),那旧数据可能实际上没同步过,会漏掉。
我的做法是:加字段时先设一个安全的默认值,然后在同一个事务里做数据回填。比如 sync_status 先 DEFAULT 0,然后执行 UPDATE favorite SET sync_status = 1 WHERE id > 0(假设旧数据都视为已同步)。这两条 SQL 必须在同一个事务里执行,否则如果加字段成功但回填失败,数据就会处于不一致的状态。
下面这段代码放在 DatabaseHelper.ets 里,实现了 onUpgrade 的版本迁移逻辑。它在应用启动时由 RelationalStore 回调,不需要手动调用。
import { relationalStore } from '@kit.ArkData';

class DatabaseOpenCallback implements relationalStore.RdbOpenCallback {
  async onCreate(store: relationalStore.RdbStore): Promise<void> {
    await store.executeSql(
      'CREATE TABLE IF NOT EXISTS favorite (id INTEGER PRIMARY KEY AUTOINCREMENT, title TEXT, url TEXT, created_at INTEGER)'
    );
  }

  async onUpgrade(store: relationalStore.RdbStore, currentVersion: number, targetVersion: number): Promise<void> {
    if (currentVersion < 2) {
      await this.migrateV1ToV2(store);
    }
    if (currentVersion < 3) {
      await this.migrateV2ToV3(store);
    }
  }

  private async migrateV1ToV2(store: relationalStore.RdbStore): Promise<void> {
    await store.executeSql('BEGIN TRANSACTION');
    try {
      await store.executeSql('ALTER TABLE favorite ADD COLUMN sync_status INTEGER DEFAULT 0');
      await store.executeSql('ALTER TABLE favorite ADD COLUMN updated_at INTEGER DEFAULT 0');
      await store.executeSql('UPDATE favorite SET sync_status = 1, updated_at = created_at');
      await store.executeSql('CREATE INDEX IF NOT EXISTS idx_favorite_updated ON favorite(updated_at)');
      await store.executeSql('COMMIT');
    } catch (e) {
      await store.executeSql('ROLLBACK');
      throw e;
    }
  }

  private async migrateV2ToV3(store: relationalStore.RdbStore): Promise<void> {
    await store.executeSql('BEGIN TRANSACTION');
    try {
      await store.executeSql(
        'CREATE TABLE IF NOT EXISTS draft_snapshot (id INTEGER PRIMARY KEY AUTOINCREMENT, draft_id INTEGER, content TEXT, saved_at INTEGER)'
      );
      await store.executeSql('COMMIT');
    } catch (e) {
      await store.executeSql('ROLLBACK');
      throw e;
    }
  }
}
这段代码要解决的问题:onUpgrade 按版本号逐步迁移,确保从任意旧版本升级都不会漏掉变更;每个迁移步骤都在事务里执行,失败时回滚,保证数据一致性;migrateV1ToV2 里加字段后立即回填默认值,避免新字段为空导致业务逻辑异常。
实际运行时要注意:onUpgrade 是在数据库打开时同步执行的,如果迁移数据量很大(比如几万条数据的回填),可能会阻塞数据库打开,导致应用启动变慢。建议在迁移前评估数据量,如果回填操作很耗时,可以考虑只加字段不回填,在业务逻辑里处理空值,或者在后台异步做数据迁移。另外,ROLLBACK 后要把异常继续抛出,让上层知道迁移失败了,不要静默吞掉。
三、批量写入和并发修改怎么不打架
除了升级迁移,日常使用中也有需要事务的场景。最常见的就是批量写入。
比如用户从云端同步下来 100 条收藏记录,需要逐条插入数据库。如果不用事务,每条 insert 都是一个独立的事务,100 条就是 100 次事务提交,速度很慢。而且如果插到第 50 条时失败了,前 49 条已经提交了,数据处于部分同步的状态。
用事务包裹批量写入的好处是:要么全部成功,要么全部失败,不会出现部分写入的情况。而且事务内的写入速度比逐条提交快很多,因为减少了磁盘刷盘的次数。
下面这段代码放在 FavoriteRepository.ets 里,实现了批量插入。它在同步场景下调用,一次接收一个数组,全部插入成功后才提交。
async batchInsert(items: Array<Record<string, Object>>): Promise<number> {
  if (!this.store) throw new Error('database not initialized');
  if (items.length === 0) return 0;

  await this.store.executeSql('BEGIN TRANSACTION');
  try {
    let count = 0;
    for (const item of items) {
      const valuesBucket = new relationalStore.ValuesBucket(item);
      await this.store.insert('favorite', valuesBucket);
      count++;
    }
    await this.store.executeSql('COMMIT');
    return count;
  } catch (e) {
    await this.store.executeSql('ROLLBACK');
    throw e;
  }
}
这段代码要解决的问题:批量插入在一个事务里执行,保证原子性;逐条插入但只在最后提交一次,提升性能;失败时回滚,不会留下部分数据。
实际运行时要注意:批量插入的数量不要太大,建议每次最多 500 条。如果数据量超过 500 条,可以分批执行,每批一个事务。因为事务太大的话,回滚时需要撤销的操作很多,可能会很慢,而且长时间持有写锁会阻塞其他数据库操作。
并发修改是另一个需要注意的问题。SQLite 支持多连接并发读,但写操作是串行的——一个写事务执行时,其他写操作会等待。如果应用里有多个地方同时写数据库(比如页面在保存草稿,后台同步在更新收藏),可能会出现等待超时。
我的建议是:所有数据库写操作都通过 Repository 执行,Repository 内部可以维护一个串行队列,确保写操作按顺序执行,避免并发冲突。这个我目前还没有完全实现,需要验证在高并发写入场景下是否会出现锁等待超时的问题。
四、提交、回滚和异常恢复
事务的核心就是 COMMIT 和 ROLLBACK。COMMIT 把事务内的所有修改永久写入数据库,ROLLBACK 撤销事务内的所有修改,回到事务开始前的状态。
但有一个容易踩的坑:如果在事务执行过程中应用崩溃了(比如被系统杀掉),数据库会怎么样?答案是 SQLite 有 WAL(Write-Ahead Logging)机制,崩溃后下次打开数据库时会自动回滚未提交的事务,不会损坏数据。但前提是数据库文件没有被外部破坏。
异常恢复方面,我的做法是:每个事务都用 try-catch 包裹,catch 里执行 ROLLBACK,然后把异常重新抛出。上层收到异常后,可以根据情况决定是重试还是提示用户。
有一点需要特别注意:ROLLBACK 本身也可能失败(比如数据库连接已经断开)。如果 ROLLBACK 失败,不要继续执行其他数据库操作,应该关闭数据库连接,重新打开一个新的连接。因为此时数据库的状态可能已经不一致了。
五、升级后的验证和数据一致性检查
迁移完成以后,不能直接就认为成功了,要做验证。
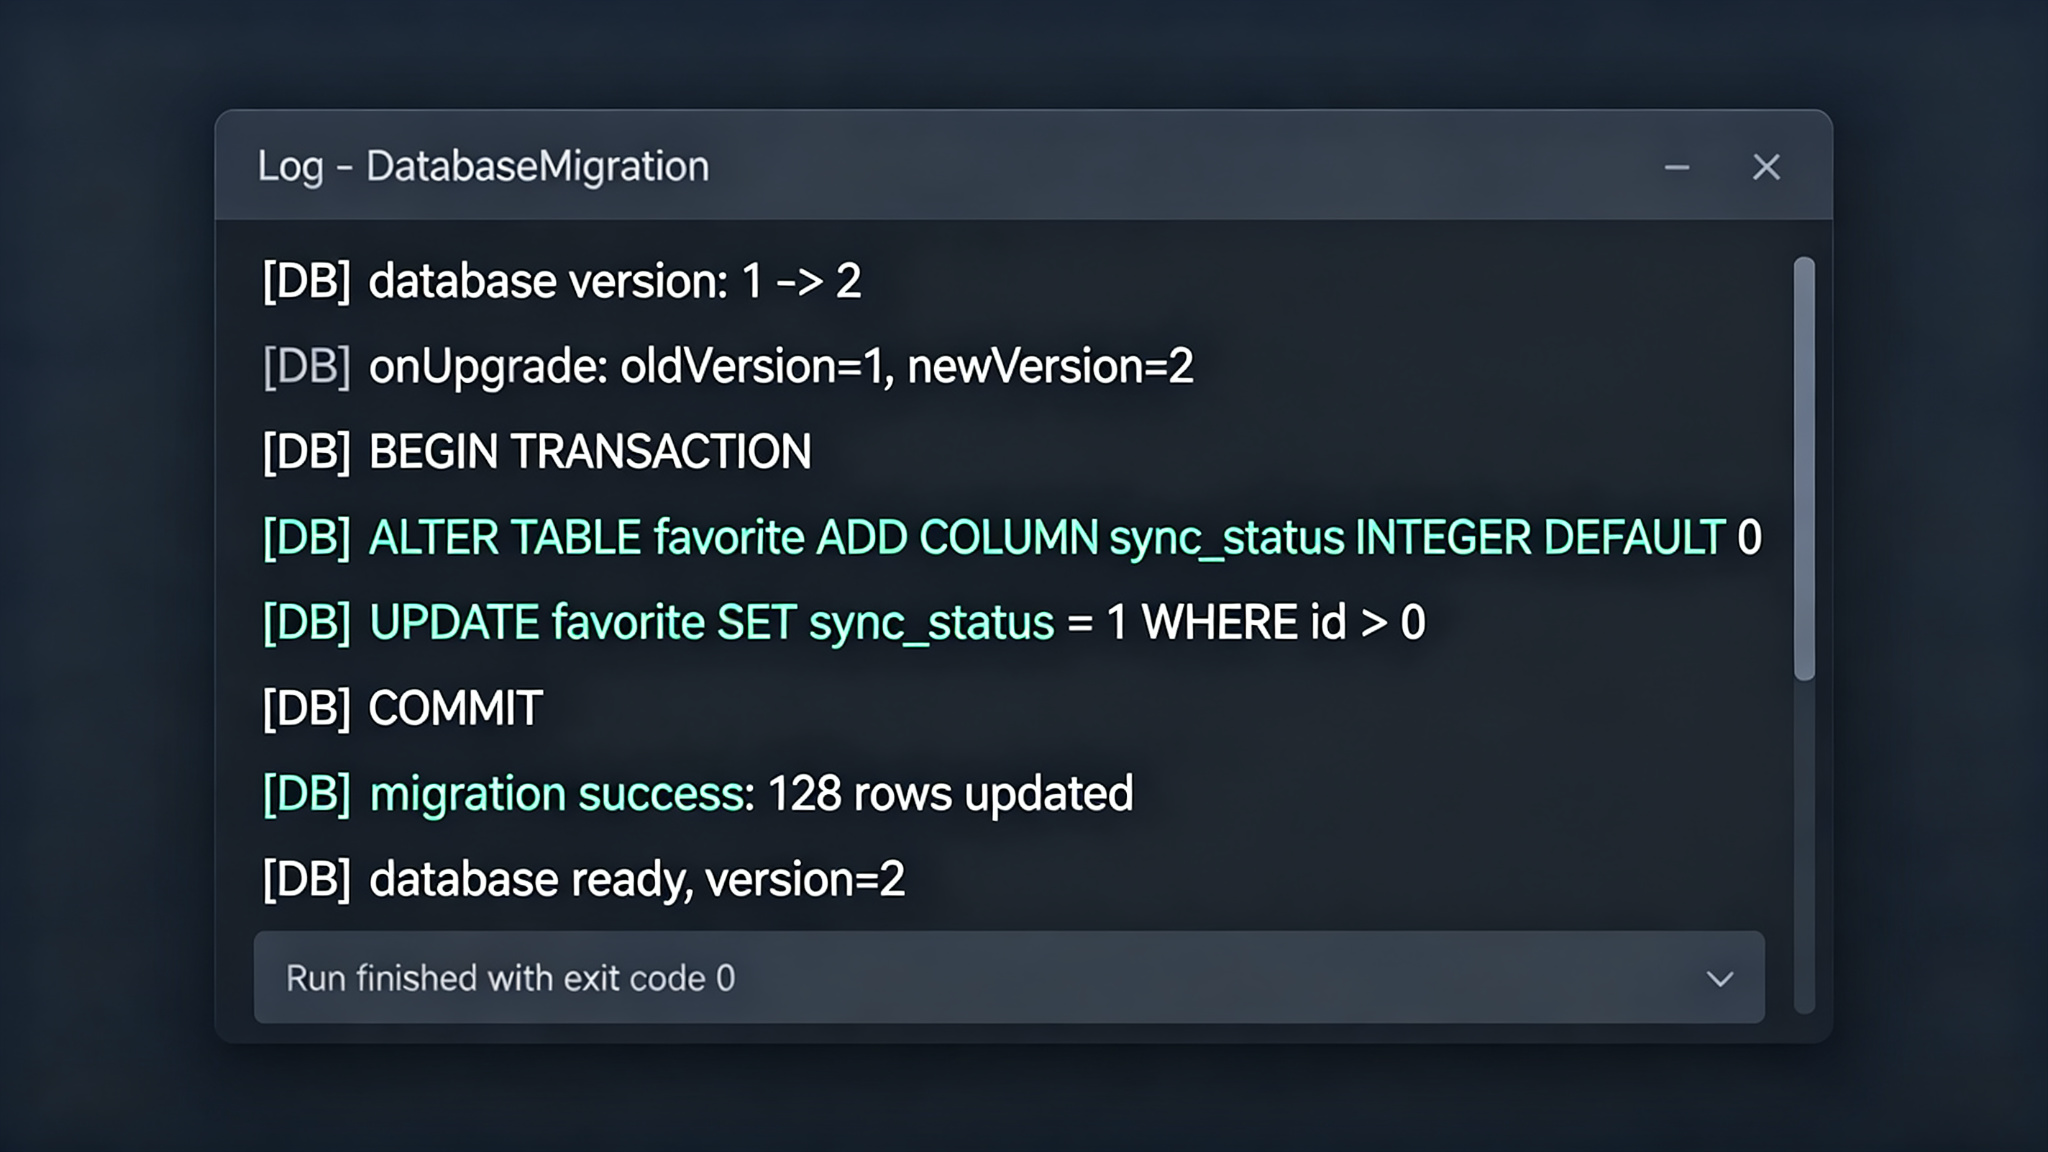
我做的验证包括:检查数据库版本号是否已经更新到目标版本;检查新字段是否存在(可以用 PRAGMA table_info(favorite) 查询表结构);抽查几条旧数据,确认新字段的值是否符合预期;检查索引是否创建成功。
这些验证建议在开发环境和测试环境都跑一遍。生产环境因为不能直接访问数据库文件,可以在应用内加一个调试入口,在测试包中输出数据库状态信息。
数据一致性检查方面,重点关注:迁移后的数据行数是否和迁移前一致(不应该因为迁移而丢失数据);新字段的默认值是否正确;旧数据的回填是否完整。
六、边界情况和需要验证的点
最后说几个还需要验证的边界情况。
跨多个版本的升级。目前我测试了 v1→v2 和 v2→v3 的升级,但 v1→v3 的直接升级还需要验证。虽然代码里是按版本号逐步执行的,但实际运行时是否有问题还需要测试。
大表的 ALTER TABLE 性能。SQLite 的 ALTER TABLE ADD COLUMN 操作本身很快,因为它只是修改表结构,不修改现有数据。但如果后续要做全表 UPDATE 回填,数据量大的话会很慢。需要验证在几万条数据的表上做回填的耗时,如果太慢需要考虑异步迁移。
事务嵌套。目前代码里的事务都是单层的,没有嵌套事务。如果 Repository 的某个方法内部已经开了事务,外部又开了一个事务包裹它,就会出现嵌套事务。SQLite 不支持真正的嵌套事务,需要用 SAVEPOINT。这个目前还没遇到,但后续代码复杂了以后可能会碰到,需要提前设计好事务的边界。
数据库损坏的恢复。虽然 SQLite 很稳定,但极端情况下(比如存储芯片损坏、写入时断电)数据库文件可能会损坏。建议定期备份数据库文件,或者在检测到数据库损坏时,用 .dump 命令导出数据后重建。这个我目前还没有实现,需要验证损坏检测和恢复的方案。
数据库升级这件事,看起来就是加个字段、改个表,但真正在用户环境里跑起来,每一步都不能马虎。事务保护、版本逐步迁移、异常回滚、升级后验证,这些步骤一个都不能少。把这些基础工作做扎实,后续版本迭代才能放心地改表结构。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 4
 0
- 0


 已为社区贡献6条内容

所有评论(0)