HarmonyOS 7 本地数据与持久化实战 01:用 RelationalStore 搭好应用的数据底座
项目早期,配置项都丢在 Preferences 里,读写就一行代码,省事。但做到草稿、收藏、历史记录这些功能以后,问题就来了:数据量一大,Preferences 每次都要全量读写,页面里到处散落着存取逻辑,改一个字段要翻好几个文件。
我一开始也想凑合,给 Preferences 多存几个 key 不就行了。直到收藏列表要做分页查询、按时间排序、按类型筛选,才意识到这不是 Preferences 该干的活。它适合存几个键值对,不适合存结构化的业务数据。
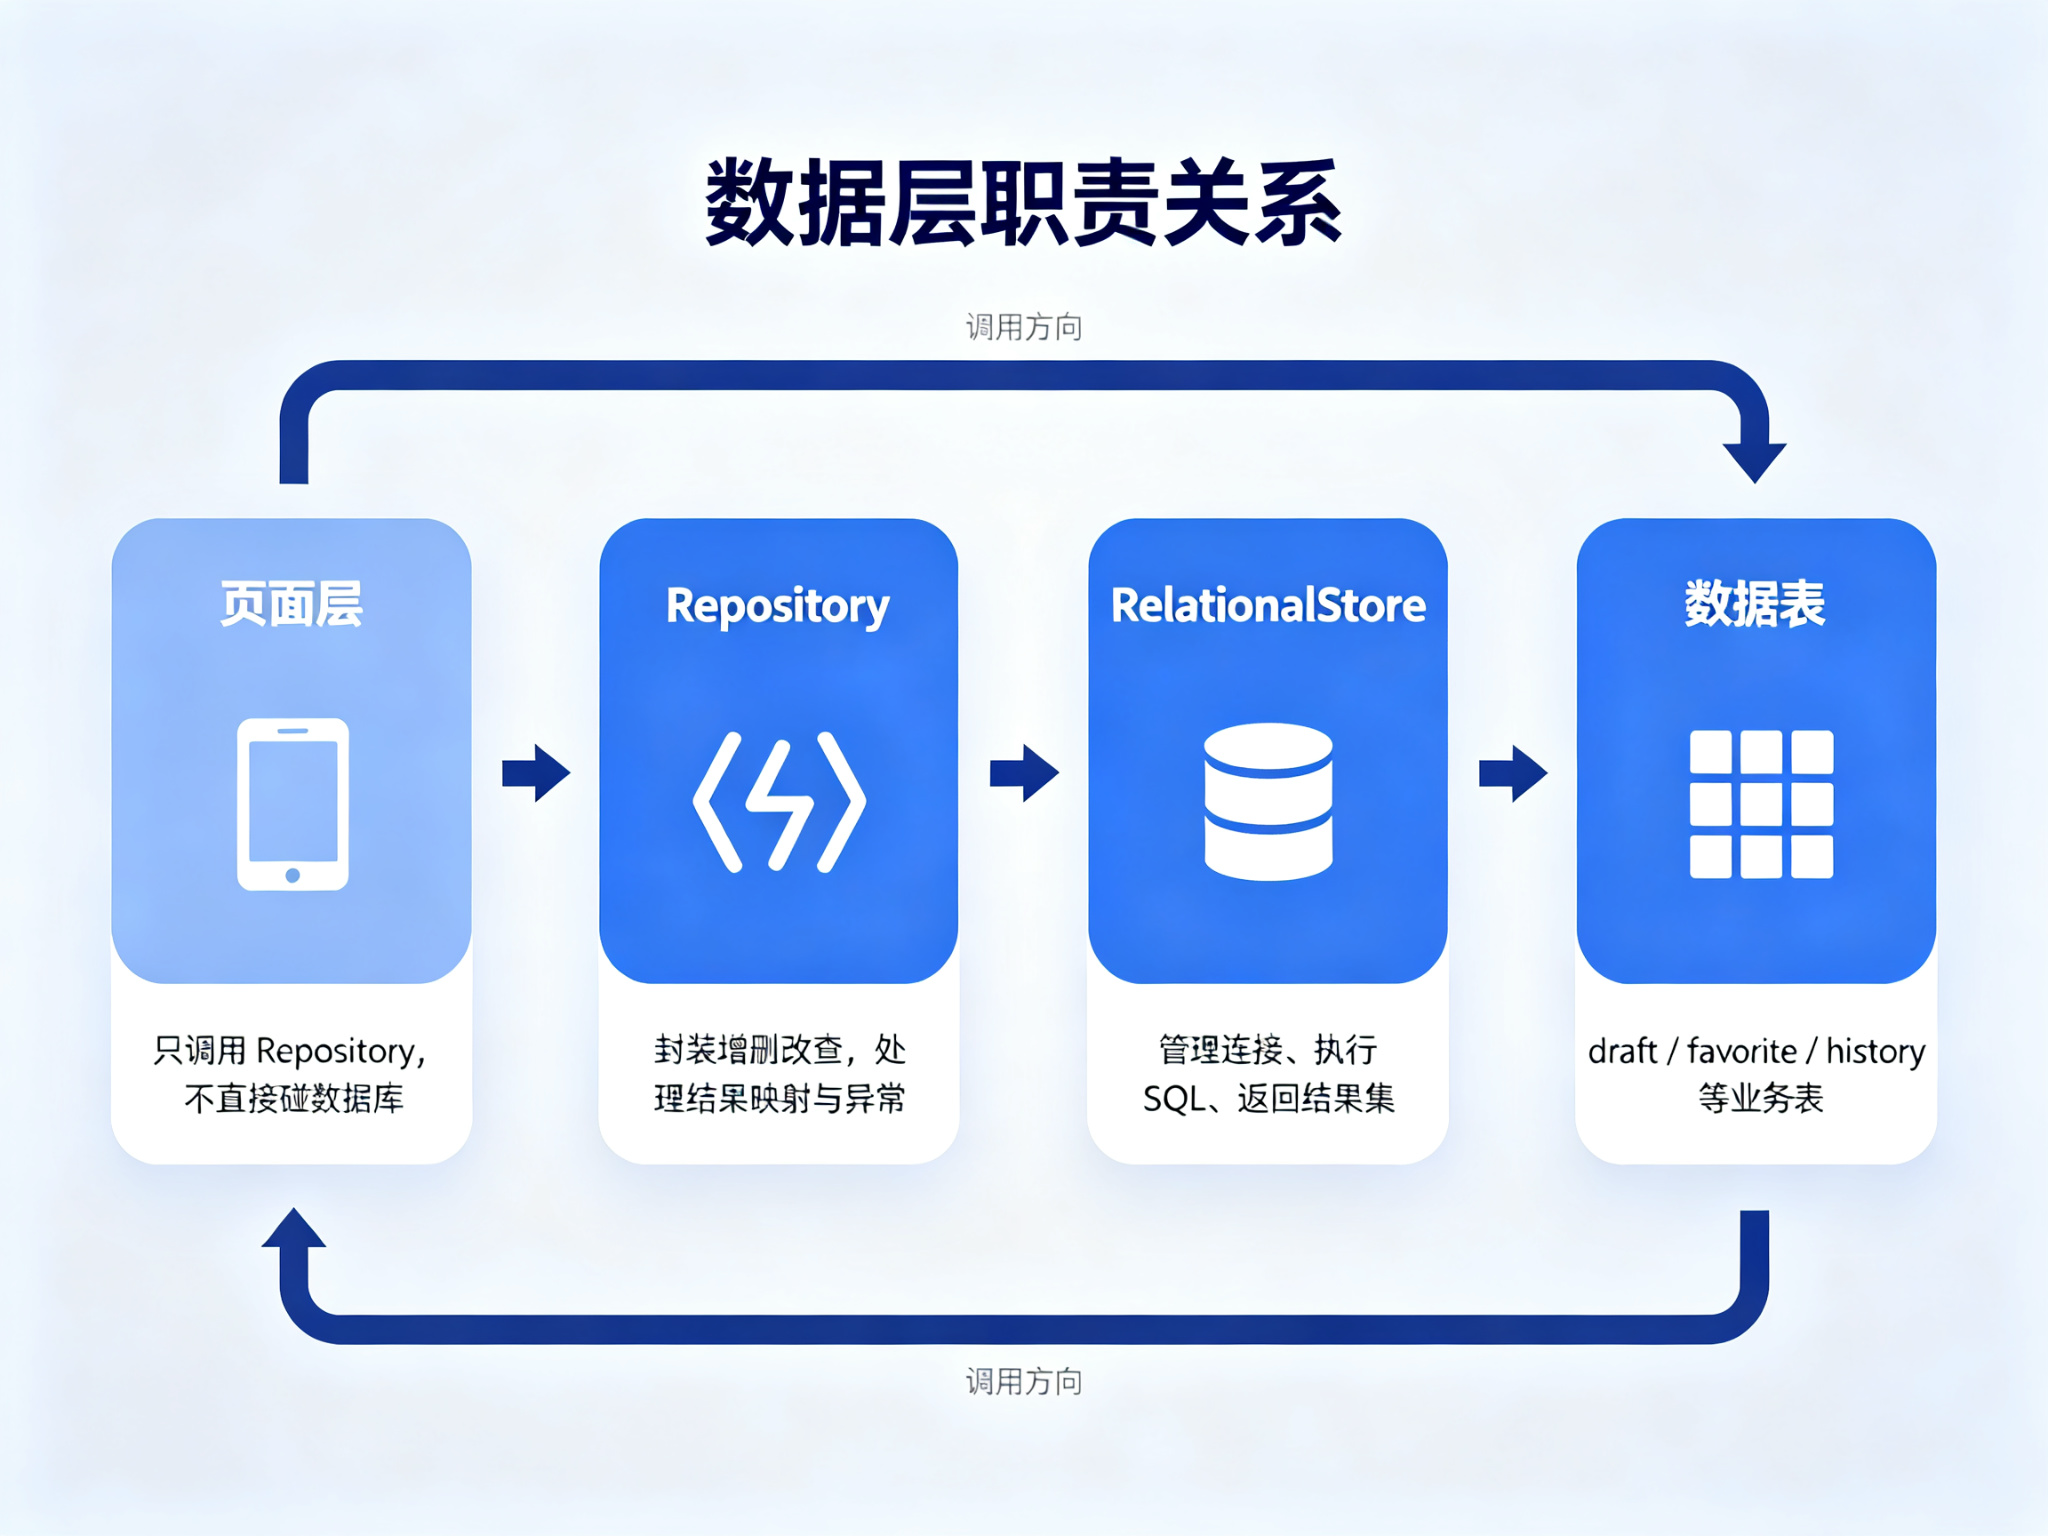
说白了,这里要解决的就是数据层的职责划分问题。页面不该直接碰数据库,数据库操作不该散落在各个页面里,得有一个统一的地方管这件事。
一、数据一多,Preferences 就扛不住了
先说说我为什么决定换成 RelationalStore。
Preferences 的问题不是不能用,而是用错了场景。它的设计目标是存少量配置数据,比如用户偏好、开关状态、上次登录时间。这些数据有个特点:量小、结构简单、读取频率低。
但收藏列表不一样。一条收藏记录可能包含 id、标题、链接、封面、分类、创建时间、同步状态七八个字段。用户可能收藏几百条,页面要按时间倒序排列、按分类筛选、搜索关键词。用 Preferences 存的话,要么把整个列表序列化成一个大字符串存一个 key,每次读取都要反序列化全量数据;要么每条记录存一个 key,查询的时候要遍历所有 key。两种方式都很难维护。
RelationalStore 是 HarmonyOS 提供的关系型数据库,本质上就是一个嵌入式 SQLite。它支持表结构、SQL 查询、事务、索引,正好适合存这种结构化的业务数据。
我的判断标准很简单:如果数据需要按条件查询、排序、筛选,或者单表数据量可能超过几百条,就用 RelationalStore。如果只是几个配置项,继续用 Preferences 就行。
二、先把表结构想清楚再写代码
决定用 RelationalStore 以后,第一件事不是写代码,而是设计表结构。这个步骤很容易被跳过,但表结构一旦定下来,后面改起来很麻烦——尤其是用户手机里已经有数据以后。
我以收藏表为例,设计了这些字段:id(主键,自增)、title(标题)、url(链接)、cover(封面图地址)、category(分类)、created_at(创建时间)、updated_at(更新时间)、sync_status(同步状态,0=未同步,1=已同步)。
这里有几个设计决定值得说一下。
id 用自增整数而不是字符串 UUID,因为本地数据库不需要全局唯一,自增 id 更省空间、查询更快。但如果后续要做多端同步,可能需要换成 UUID,这个我在代码里留了扩展空间。
created_at 和 updated_at 都存毫秒级时间戳,用 INTEGER 类型而不是 TEXT。SQLite 没有原生的日期类型,存整数时间戳排序和比较都方便,展示的时候再格式化。
sync_status 这个字段是为后续多端同步预留的。虽然当前版本还没做同步,但先把字段加上,后面加同步功能时就不用改表结构了——这一点在第二篇讲数据库升级的时候会详细说,提前加字段比后期迁移省事得多。
索引方面,我给 created_at 加了索引,因为收藏列表默认按创建时间倒序排列,这个查询频率最高。category 也加了索引,因为按分类筛选是常用操作。
三、Repository 才是页面该打交道的对象
表结构定好以后,接下来就是封装数据访问层。我没有在页面里直接执行 SQL,而是建了一个 FavoriteRepository,把所有数据库操作都封装在里面。
这么做的原因很实际:如果页面里到处都是 database.executeSql(),以后要改表结构、加缓存、加日志,就得改好几个地方。有了 Repository,页面只调用 favoriteRepository.queryAll() 这样的方法,内部实现怎么变都不影响页面。
下面这段代码放在 FavoriteRepository.ets 里,封装了收藏表的增删改查。它在应用启动时初始化数据库连接,页面通过依赖注入获取实例。
import { relationalStore } from '@kit.ArkData';

const STORE_CONFIG: relationalStore.StoreConfig = {
  name: 'app_data.db',
  securityLevel: relationalStore.SecurityLevel.S1
};

export class FavoriteRepository {
  private store: relationalStore.RdbStore | null = null;

  async init(context: Context): Promise<void> {
    if (this.store) return;
    this.store = await relationalStore.getRdbStore(context, STORE_CONFIG);
    await this.store.executeSql(
      'CREATE TABLE IF NOT EXISTS favorite (id INTEGER PRIMARY KEY AUTOINCREMENT, title TEXT, url TEXT, cover TEXT, category TEXT, created_at INTEGER, updated_at INTEGER, sync_status INTEGER DEFAULT 0)'
    );
    await this.store.executeSql('CREATE INDEX IF NOT EXISTS idx_favorite_created ON favorite(created_at)');
  }

  async insert(item: Record<string, Object>): Promise<number> {
    if (!this.store) throw new Error('database not initialized');
    const valuesBucket = new relationalStore.ValuesBucket(item);
    return await this.store.insert('favorite', valuesBucket);
  }

  async queryAll(category?: string): Promise<Array<Record<string, Object>>> {
    if (!this.store) throw new Error('database not initialized');
    let sql = 'SELECT * FROM favorite';
    let args: Array<ValueType> = [];
    if (category) {
      sql += ' WHERE category = ?';
      args.push(category);
    }
    sql += ' ORDER BY created_at DESC';
    const resultSet = await this.store.querySql(sql, args);
    return this.mapResultSet(resultSet);
  }

  async delete(id: number): Promise<number> {
    if (!this.store) throw new Error('database not initialized');
    return await this.store.delete('favorite', 'id = ?', [id]);
  }

  private mapResultSet(resultSet: relationalStore.ResultSet): Array<Record<string, Object>> {
    const result: Array<Record<string, Object>> = [];
    while (resultSet.goToNextRow()) {
      const row: Record<string, Object> = {};
      for (let i = 0; i < resultSet.columnCount; i++) {
        row[resultSet.getColumnName(i)] = resultSet.getValue(i);
      }
      result.push(row);
    }
    resultSet.close();
    return result;
  }
}
这段代码要解决的问题:init() 里创建表和索引,保证首次运行时表存在;insert/queryAll/delete 封装了常用操作,页面不需要写 SQL;mapResultSet 把查询结果集转换成对象数组,页面拿到的就是可以直接用的数据。
实际运行时要注意:init() 必须在应用启动时调用一次,而且要等它完成后才能执行其他操作。我在 EntryAbility 的 onCreate 里做了初始化,用一个全局的单例管理 Repository 实例。另外,queryAll 返回的结果集一定要 close(),否则会泄漏资源——我把 close 放在 mapResultSet 里,确保每次查询都会关闭。
四、异常处理别只写个空 catch
数据库操作最容易出问题的地方不是 SQL 写错,而是异常处理不到位。
我见过太多代码这样写:try { await repository.insert(item) } catch (e) {}。异常被吞掉了,用户看到的是收藏没加上,但不知道为什么。日志里也没有任何记录,排查的时候一头雾水。
我的做法是:每个数据库操作都要有明确的异常处理。插入失败要提示用户"保存失败,请重试",同时打日志记录具体错误。查询失败要返回空列表而不是抛出异常,避免页面崩溃——但要打日志记录。删除失败要提示用户,不要静默失败。
还有一个容易忽略的点:数据库未初始化的情况。如果用户在应用启动后立刻操作,init() 可能还没完成,这时候调用 insert 会报 "database not initialized"。我在 Repository 里加了状态检查,如果未初始化就抛出明确的错误,而不是让它报一个看不懂的空指针。
五、接入位置和调用顺序
Repository 的初始化时机很重要。太早了 Context 还没准备好,太晚了页面已经开始查询数据。
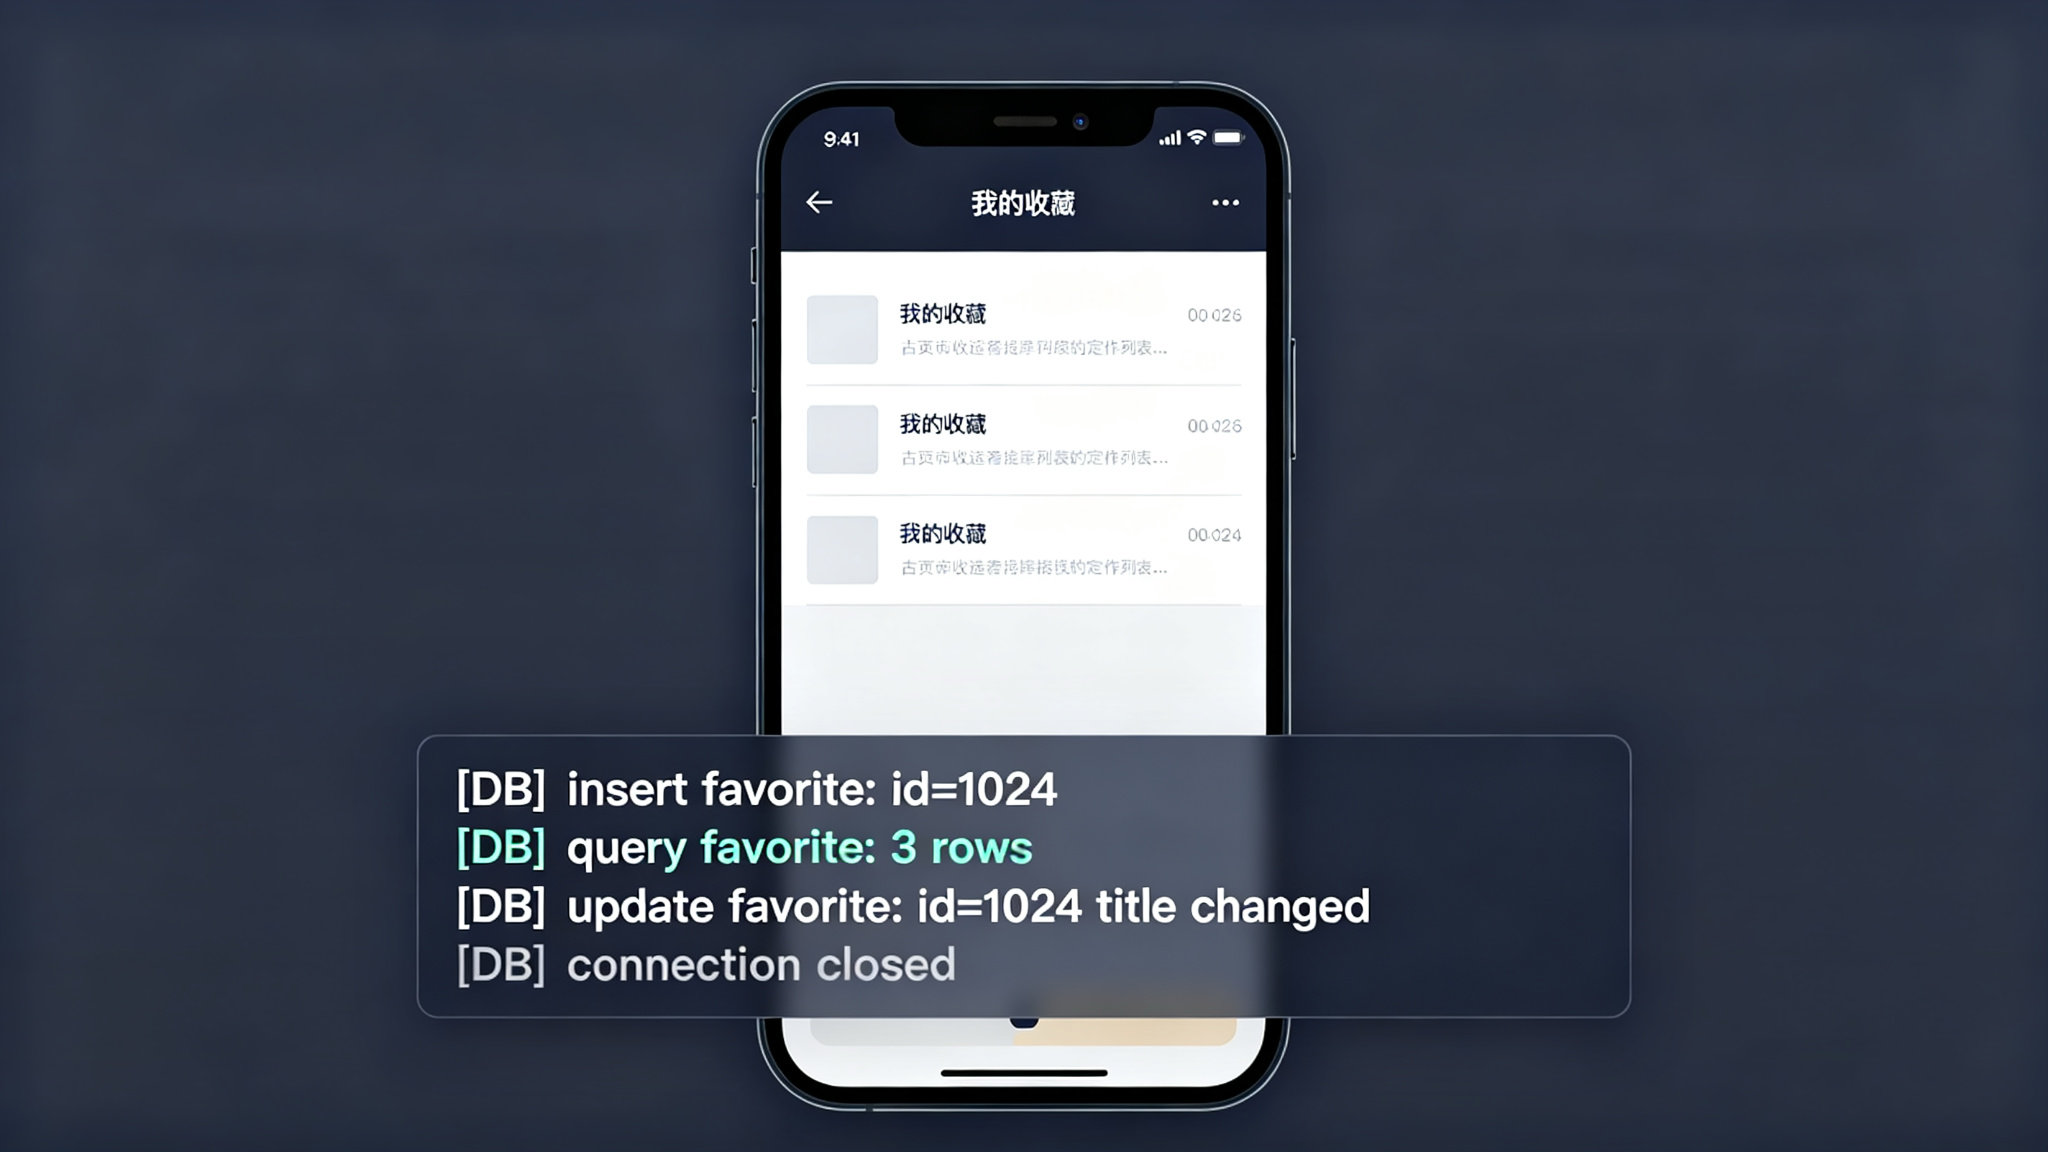
我的做法是在 EntryAbility 的 onCreate 里初始化数据库,用一个 AppStorage 变量标记初始化状态。页面在 aboutToAppear 里检查初始化状态,如果还没完成就显示加载中,完成后再查询数据。
调用顺序上,页面只和 Repository 打交道,不直接操作 RelationalStore。Repository 内部管理数据库连接、执行 SQL、映射结果。这样分层以后,页面的代码很干净,数据层的改动也不会影响页面。
六、边界情况和需要验证的点
最后说几个还需要验证的边界情况。
大量数据下的查询性能。我目前只测试了几百条数据的情况,查询速度没问题。但如果用户收藏了几千条,不带分页的全量查询可能会有性能问题。建议后续加上分页查询,每次只查当前页需要的数据。
数据库连接的生命周期。目前 Repository 是单例,数据库连接在应用整个生命周期内保持打开。这种方式在大多数情况下没问题,但如果应用长时间在后台,系统可能会回收资源。需要验证长时间后台后数据库连接是否仍然有效,如果失效需要加重连逻辑。
并发访问。目前所有数据库操作都在主线程调用,RelationalStore 的 API 是异步的,理论上不会阻塞 UI。但如果同时有多个页面执行写操作,会不会有冲突?SQLite 本身支持并发读,但写操作需要锁。建议验证并发写入的情况,如果有问题需要在 Repository 层加串行队列。
数据导出和备份。目前数据库文件存在应用沙箱里,用户换手机后数据就没了。后续如果要做数据迁移或云同步,需要考虑导出数据库文件或者逐条同步的方案。
把数据底座搭好以后,后面加新的业务表就有章可循了。但这只是第一步——数据库版本升级、事务、并发这些更复杂的问题,会在下一篇里详细讲。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)