把 Rust 核心库接入 HarmonyOS:从编译产物到 ArkTS 调用的一次完整复盘
项目里有一套 Rust 写的核心算法库,跑了很多年,稳定而且性能不错。迁到 HarmonyOS 的时候,一开始想直接用 ArkTS 重写,算了算工作量,几个核心模块重写一遍加上测试,至少两个月。后来决定把 Rust 库直接编译成动态库,通过 Native 接口层让 ArkTS 调,省了一大半工作量。
但真正做起来才发现,"编译成 so 文件"只是第一步。Rust 那边的数据结构怎么传给 ArkTS?字符串编码不一样怎么办?Rust 里的错误怎么传给 ArkTS?页面层直接调 Rust 函数还是中间包一层?这些问题比编译本身要花时间。
这篇就把从决定保留 Rust 到 ArkTS 成功调用的整个过程复盘一遍。
一、先决定哪些逻辑值得继续留在 Rust
不是所有代码都该留在 Rust。业务页面、UI 状态管理、网络请求这些,本来就该用 ArkTS 写,硬套 Rust 反而绕路。真正适合留在 Rust 的是:计算密集型算法、已经很稳定不怎么改的核心逻辑、用 Rust 写过测试且验证过的业务规则。
我先把项目里的 Rust 模块过了一遍,挑出来两个值得保留的:一个是数据压缩算法,一个是本地缓存的编解码逻辑。这两块计算量大、算法稳定、用 ArkTS 重写容易出 bug,留在 Rust 里通过接口暴露出去,收益最大。
剩下的业务编排、页面跳转、数据展示这些,直接用 ArkTS 重写,不经过 Rust 层。
二、Rust 编译成功以后,产物怎么进入 HarmonyOS 工程
Rust 交叉编译到 HarmonyOS 的 arm64 架构,生成 librustcore.so 文件。这个 so 文件要放到 HarmonyOS 工程的 entry/src/main/cpp/libs/arm64-v8a/ 目录下,然后在 CMakeLists.txt 里声明为 IMPORTED 库。
整个流程是:Rust 项目用 cargo build --target aarch64-linux-ohos --release 编译,把生成的 .so 文件拷贝到 HarmonyOS 工程的 libs 目录,CMake 链接进来,然后 Native 层写 C++ 桥接代码调用 Rust 导出的函数。
这个阶段最容易出的问题是:Rust 编译时的 target 和 HarmonyOS 设备架构对不上。设备是 arm64,你编了个 x86 的 so,链接的时候不报错,运行的时候直接崩。所以编译完先确认 so 的架构,用 file 命令看一眼。
三、接口层为什么不要直接暴露复杂 Rust 数据结构
Rust 里有 struct、enum、vec、String 这些类型,ArkTS 里根本不认。如果你直接把一个 Rust struct 的指针传给 ArkTS,那边读不到字段,内存也管理不了。
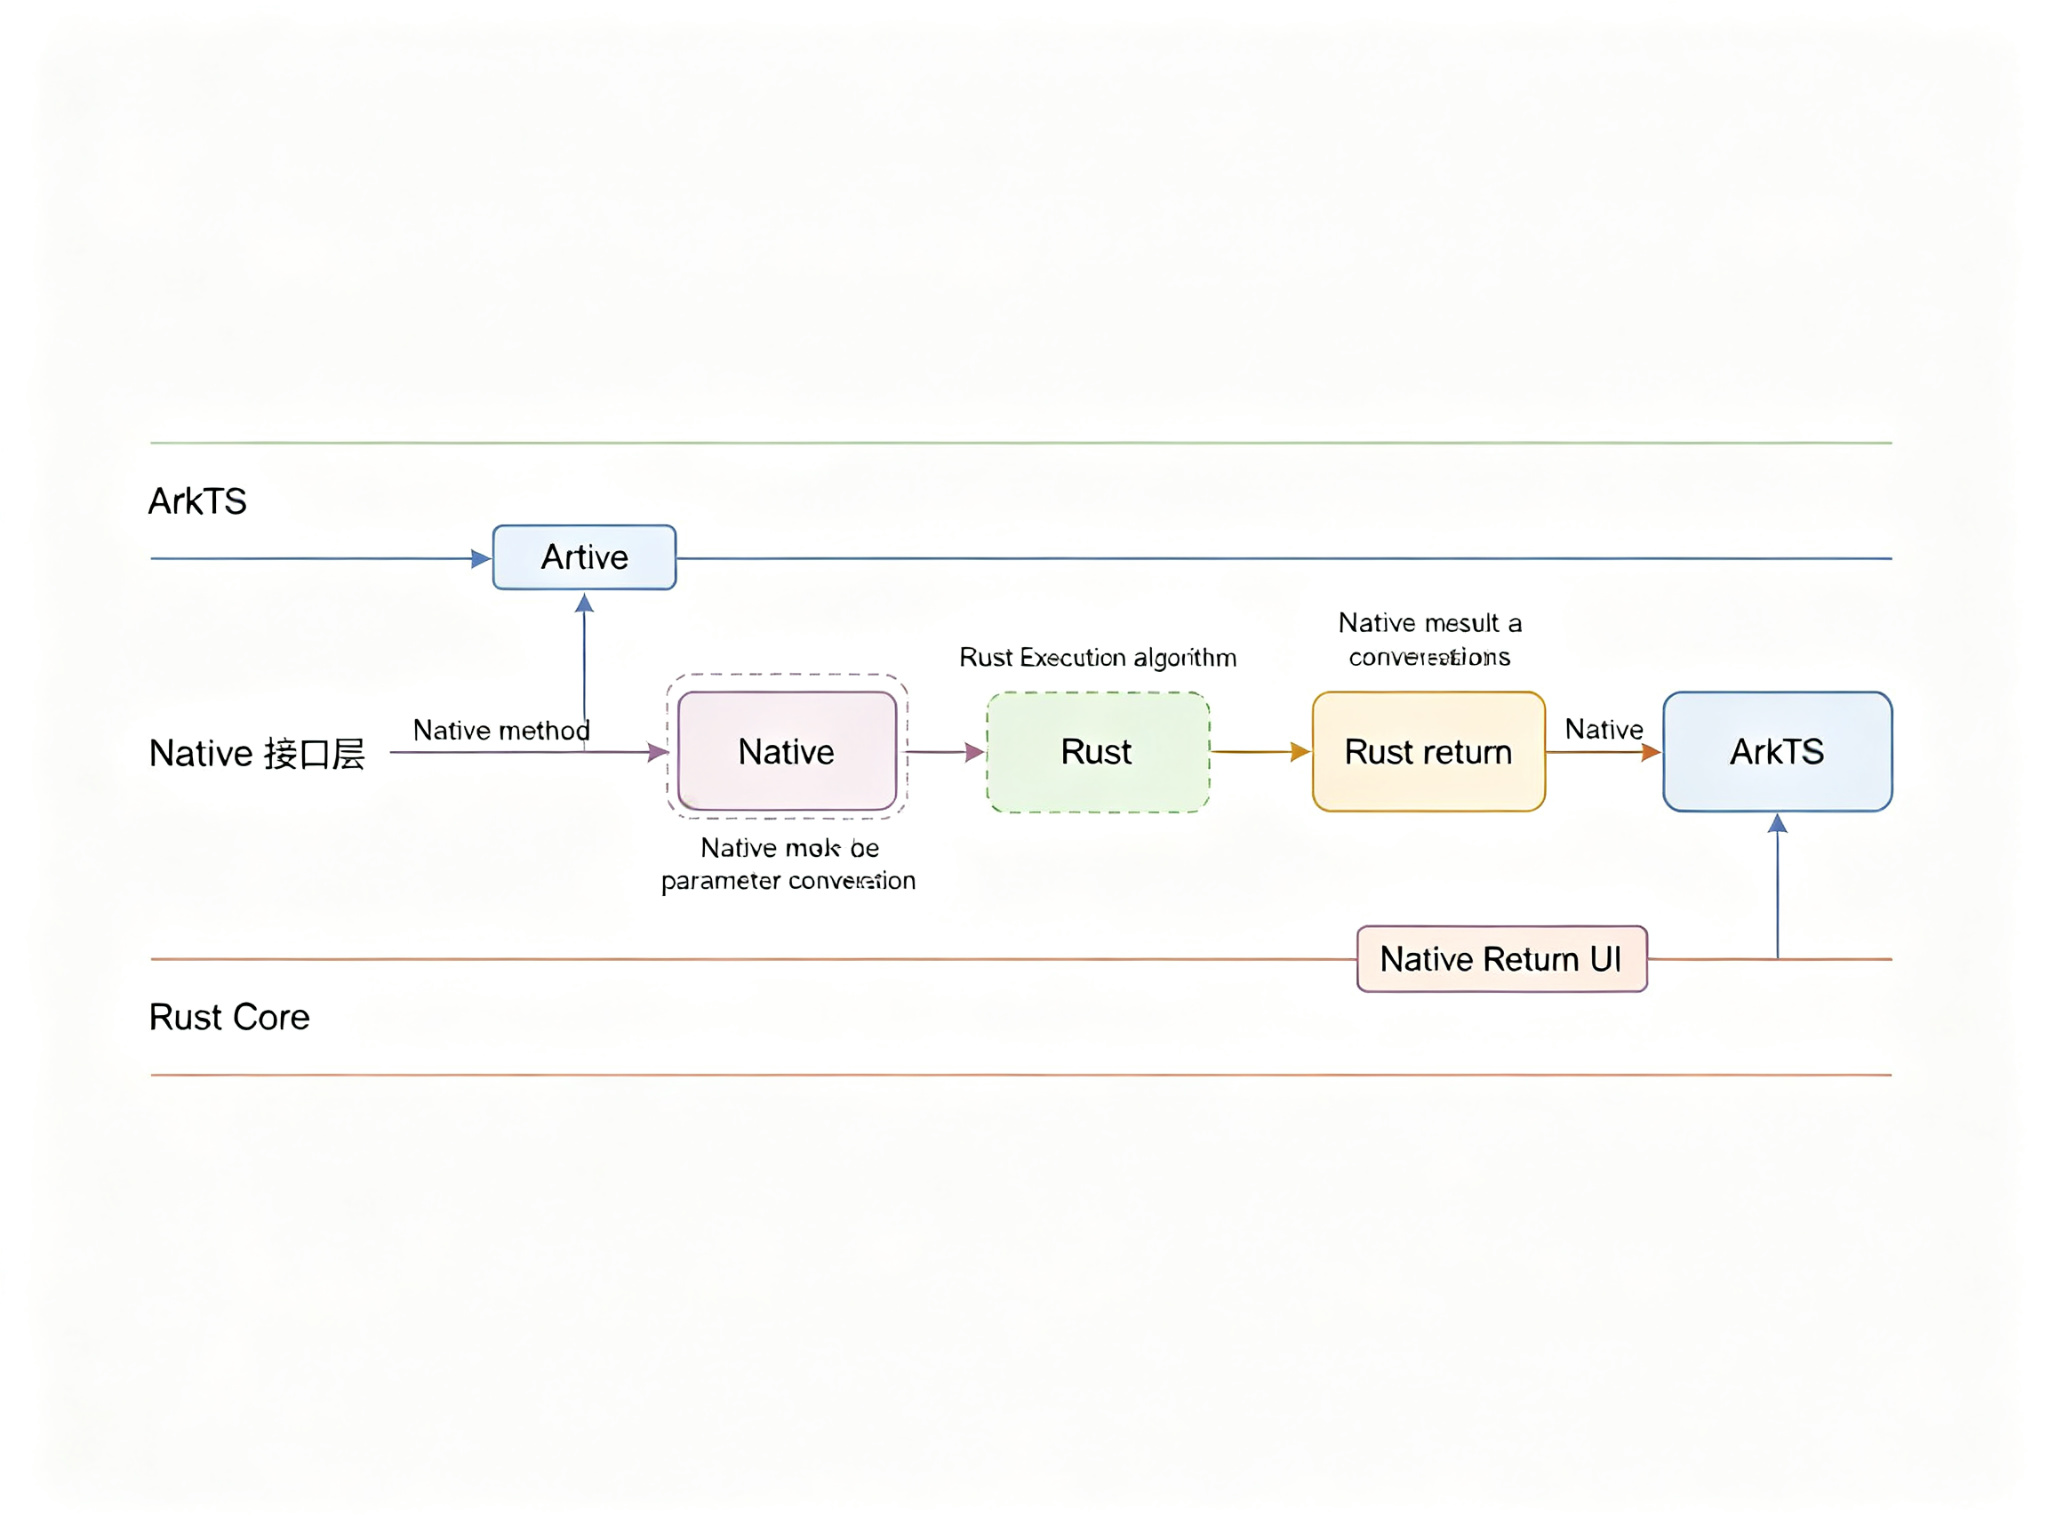
正确做法是在 Native 接口层做一层转换:Rust 那边输出简单的数据——数字、字符串、定长数组;Native 层把这些转成 ArkTS 能识别的类型;ArkTS 这边拿到的就是普通的 number、string、对象,完全感觉不到底层是 Rust。
三层职责划分:
| 层级 | 负责什么 |
|---|---|
| ArkTS | 页面、状态、业务编排、UI 更新 |
| Native 接口层 | 参数转换、接口封装、错误码转异常 |
| Rust | 算法、核心业务处理、纯计算 |
ArkTS 永远不直接碰 Rust 的数据结构,所有跨层数据都经过 Native 接口层中转。
四、ArkTS、Native 接口层、Rust 三层怎么划分职责
画一下调用关系就清楚了:ArkTS 页面想调一个算法,先调 Native 接口层暴露的 TypeScript 方法;Native 层把 ArkTS 的参数转成 C++ 类型,再调用 Rust 导出的 C ABI 函数;Rust 执行完返回结果,Native 层把结果再转成 ArkTS 对象。
这个分层的好处是:Rust 那边改了内部实现,只要对外接口不变,ArkTS 完全不用动;ArkTS 页面换了,Rust 算法还是那个算法。两边通过 Native 接口层解耦。
五、字符串、数字、数组、对象等数据类型怎么转换
类型转换是跨语言最容易踩坑的地方。Rust 的 String 是 UTF-8 带长度的字节串,ArkTS 的 string 也是 UTF-16,两边直接传指针会乱码。正确做法是 Rust 把结果转成 C 字符串(以 \0 结尾的 char*),Native 层再用 NAPI 转成 ArkTS 字符串。
数字类型相对简单:i32、f64 这些原生类型两边能对上,直接传就行。复杂对象不要直接传指针,Native 层把 Rust 返回的字段逐个读出来,组装成 ArkTS 对象。
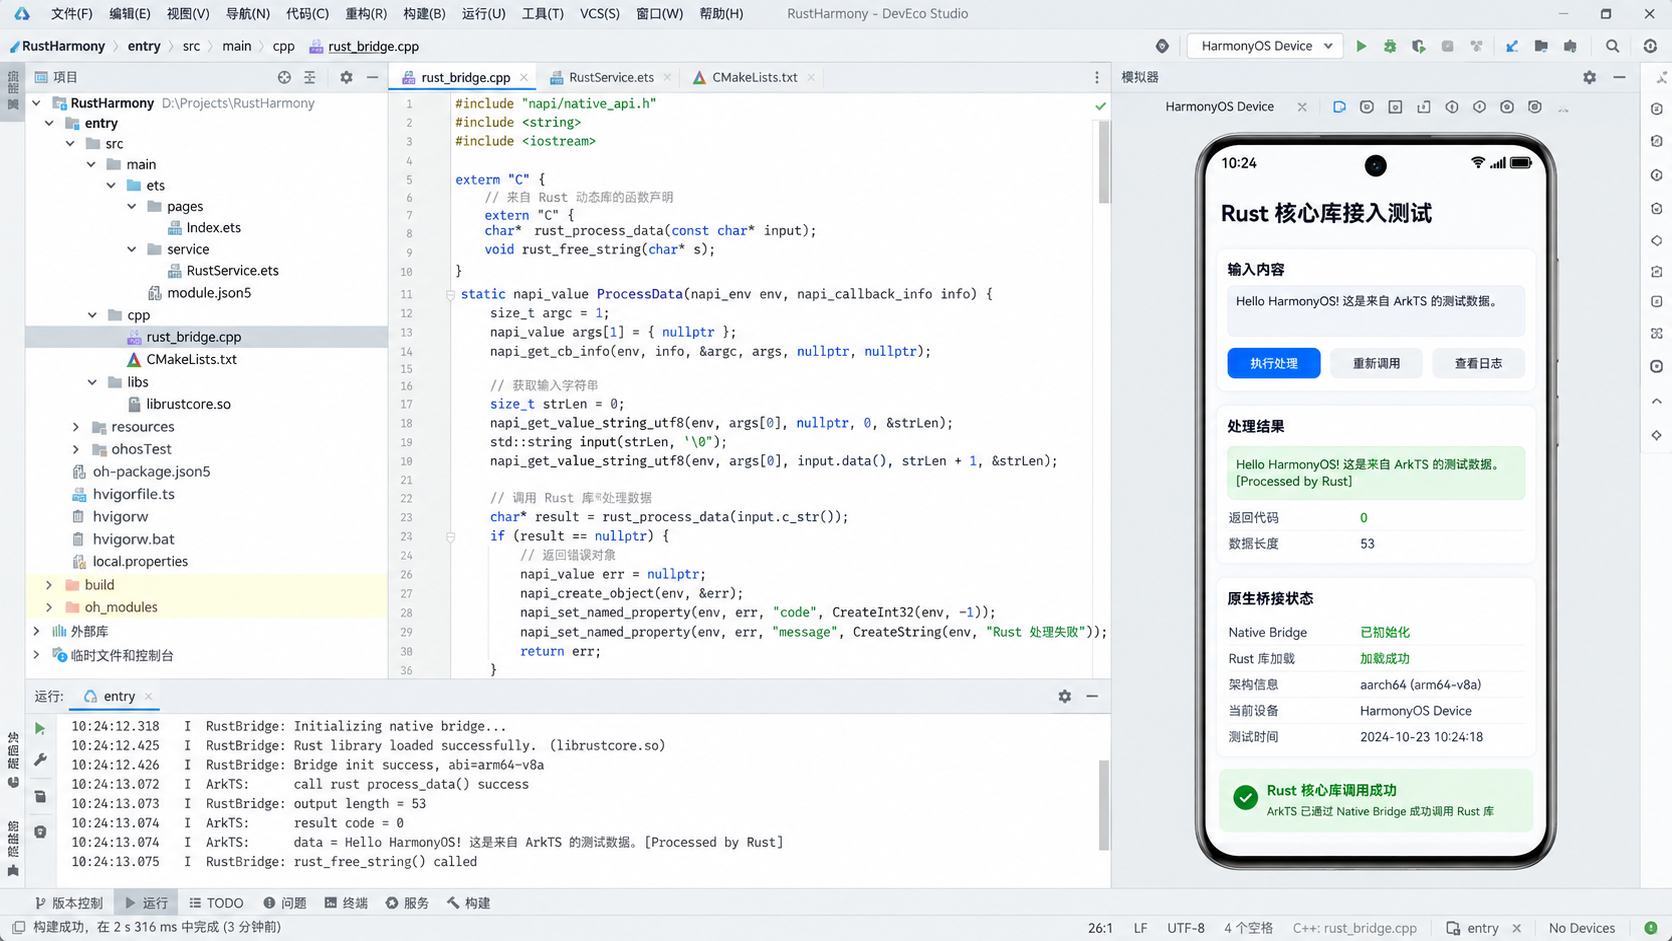
下面这段代码放在 rust_bridge.cpp 里,是 Native 层暴露给 ArkTS 的接口。它接收 ArkTS 传进来的输入字符串,调用 Rust 的处理函数,把结果封装成 ArkTS 对象返回。这段代码解决的问题:ArkTS 不需要知道 Rust 的数据结构,只调一个 JS 方法就能拿到处理结果。
#include <napi/native_api.h>
#include <string>

extern "C" {
    int rust_process_data(const char* input, char** output, int* out_len);
    void rust_free_string(char* s);
}

static napi_value ProcessData(napi_env env, napi_callback_info info) {
    size_t argc = 1;
    napi_value argv[1];
    napi_get_cb_info(env, info, &argc, argv, nullptr, nullptr);

    size_t str_len = 0;
    napi_get_value_string_utf8(env, argv[0], nullptr, 0, &str_len);
    std::string input(str_len, '\0');
    napi_get_value_string_utf8(env, argv[0], &input[0], str_len + 1, nullptr);

    char* output = nullptr;
    int out_len = 0;
    int err = rust_process_data(input.c_str(), &output, &out_len);

    napi_value result;
    napi_create_object(env, &result);

    napi_value code;
    napi_create_int32(env, err, &code);
    napi_set_named_property(env, result, "code", code);

    if (err == 0 && output) {
        napi_value val;
        napi_create_string_utf8(env, output, out_len, &val);
        napi_set_named_property(env, result, "data", val);
        rust_free_string(output);
    }

    return result;
}
这段代码要解决的问题:ArkTS 调 processData(input: string),Native 层把 string 转成 C 字符串传给 Rust,Rust 处理完返回输出字符串和错误码,Native 层把这两个字段组装成 { code: number, data: string } 对象返回给 ArkTS。Rust 分配的内存由 rust_free_string 释放,避免泄漏。
实际使用时要注意:napi_get_value_string_utf8 要调两次,第一次拿长度,第二次读内容,不能漏了长度那步。output 字符串是 Rust 那边 malloc 或者 String::into_raw 出来的,用完必须调 rust_free_string 释放,不然内存一直涨。错误码的约定要和 Rust 那边对齐,比如 0 是成功,负数是各种错误。
六、Rust 错误和异常怎么传递给 ArkTS
Rust 用 Result<T, E> 处理错误,ArkTS 用 try/catch。两边的错误模型不一样,不能直接抛过去。
我的做法是:Rust 函数不 panic,错误统一通过返回值传出来——返回一个错误码,0 表示成功,非 0 表示具体错误类型。Native 层根据错误码决定:成功就返回数据,失败就抛一个带错误码的 Error。ArkTS 那边用 try/catch 接住,根据错误码做对应处理。
不要让 Rust 的 panic 直接冒到 Native 层。跨语言边界处发生 panic 是未定义行为,可能直接闪退。Rust 那边对外暴露的 C ABI 函数,内部要 catch_unwind,确保任何错误都被转成错误码返回。
七、Native 层怎么封装接口,避免页面直接依赖底层实现
ArkTS 页面不直接 import native 模块,中间包了一层 RustService.ets。页面只调 RustService 暴露的业务方法,RustService 内部调 native 接口,做参数校验、默认值处理、错误兜底。
这样做的好处是:native 接口变了,只改 RustService 一个文件,页面代码不用动;以后要把 Rust 换成 ArkTS 实现,也是只改 RustService,页面完全无感知。
八、调试、升级、版本兼容怎么处理
调试的时候最麻烦的是:ArkTS 这边打了日志,Rust 那边出了问题,中间 Native 层把错误吞了。所以 Native 层的错误处理不能只转错误码,还要把 Rust 那边的错误信息也带出来,打日志用。
升级 Rust 库的时候,重新编译 so 文件放到 libs 目录就行,接口不变的话 ArkTS 代码不用动。但要注意不同架构的 so 文件都要更新,arm64 和 x86 模拟器的产物要分别编译。
版本兼容方面,对外暴露的 C ABI 接口要保持稳定——函数签名不随便改,新增字段加在后面,不要改已有的。这样旧版本的 so 即使被新版本调用,也不会因为找不到函数符号而崩。
把 Rust 核心库接进 HarmonyOS,最花时间的不是编译,而是三层之间的接口设计和类型转换。架构想清楚了,后面的维护成本其实很低。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)