HarmonyOS CMake 三方 C++ 库交叉编译与 ABI 管理
能编译不等于能运行,Native 移植的坑全在编译之后。
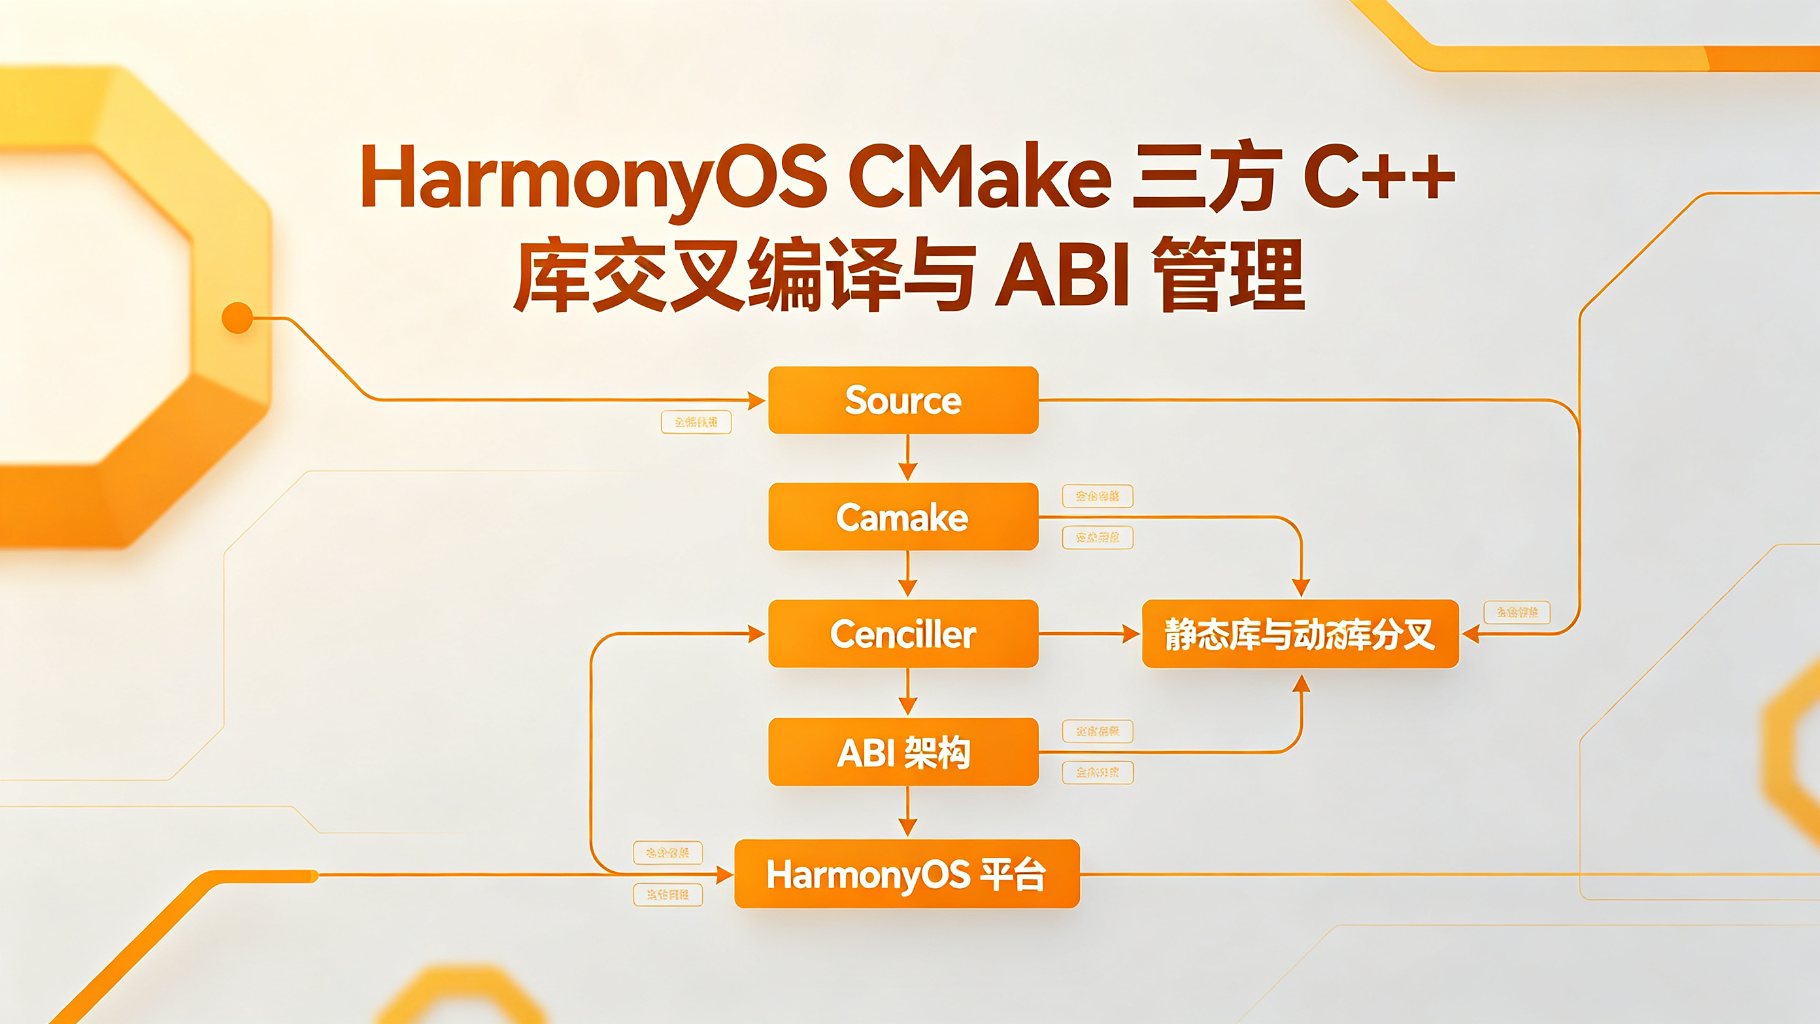
团队有个用了好几年的 C++ 库,原来跑在 Linux 和 Android 上,现在要接到 HarmonyOS 项目里。最开始想的很简单:把 .so 文件拷过来,CMake 链接一下就行了。结果一上来就是头文件找不到,解决完头文件又报 undefined symbol,好不容易链接过了,运行时又崩了。Debug 模式好好的,Release 模式直接闪退。这篇就把源码到运行的整条链拆开讲。
一、CMake 到底负责哪一层
先把整个流程理清楚。.cpp 文件经过编译器变成 .o 对象文件,然后链接器把这些对象文件链接成静态库 .a 或者动态库 .so。
| 阶段 | 做什么 | 出问题的典型现象 |
|---|---|---|
| Source | 写代码 | 语法错误 |
| Include | 找头文件 | header not found |
| Compile | 编译成 .o | 类型不存在 |
| Link | 链接成库 | undefined symbol |
| Package | 打包进 HAP | 运行时找不到 .so |
| Runtime | 加载运行 | 符号版本不匹配 |
很多人以为编译成功就完事了,其实编译只是第一步。从源码到能在设备上跑起来,中间还有 Include、Compile、Link、Package、Runtime 好几层,每一层都可能出问题。
二、头文件找到了,为什么还是 undefined symbol
最容易踩的坑就是这个。代码里写了 #include "algorithm.h",CMake 也配置了头文件路径,编译也通过了,结果链接的时候报 undefined symbol。
原因很简单:头文件里只有函数声明,比如 int algorithm_decode(const uint8_t* data, size_t len);,编译器知道这个函数存在,但链接的时候需要找到对应的实现。如果实现文件没加进来,或者链接顺序不对,就会报 undefined symbol。
代码放在 entry/src/main/cpp/CMakeLists.txt,核心配置如下:
这段代码解决什么问题: 正确把三方库源码编译并链接进 Native 模块。
文件: entry/src/main/cpp/CMakeLists.txt
用途: Native 模块构建配置
接入位置: 模块根目录
# 声明三方库
add_library(
    algorithm          # 库名
    SHARED             # SHARED = 动态库, STATIC = 静态库
    src/decode.cpp     # 源文件
    src/encode.cpp
)

# 配置头文件路径
target_include_directories(
    algorithm
    PUBLIC             # PUBLIC = 自己和依赖它的都能找到头文件
    ${CMAKE_CURRENT_SOURCE_DIR}/include
)

# 链接到主模块
target_link_libraries(
    entry              # 主模块
    PUBLIC
    algorithm          # 依赖三方库
    libace_napi.z.so   # NAPI 运行库
)
这里有三个关键点。第一,add_library 里要把所有 .cpp 文件都列出来,漏一个就会报 undefined symbol。第二,target_include_directories 用 PUBLIC 还是 PRIVATE 要搞清楚,PUBLIC 是依赖它的模块也能找到头文件,PRIVATE 只有自己能用。第三,target_link_libraries 的顺序有讲究,依赖的库要放在被依赖库的后面。
三、静态库 .a 和动态库 .so 怎么选
选静态库还是动态库,不是拍脑袋决定的,要看具体场景。
| 对比项 | .a 静态库 | .so 动态库 |
|---|---|---|
| 链接方式 | 构建期直接合入 | 运行时动态加载 |
| 最终文件大小 | 较大 | 较小 |
| 多模块共享 | 会造成重复 | 可以共享 |
| 调试难度 | 相对直接 | 还要考虑加载和符号 |
| 库升级 | 要重新编译 | 替换 .so 就行 |
我们的选择是:核心算法库用静态库,直接编进主 .so 里,减少运行时加载的复杂度;通用工具库用动态库,多个模块可以共享。这个不是标准答案,要看团队的实际情况。
四、ABI 为什么是 Native 移植绕不开的问题
这是最容易被忽略的坑。很多人以为有个 .so 文件就能用了,其实不是。同一份 C++ 源码,用不同架构的工具链编译出来,生成的 .so 是完全不一样的。arm64 的 .so 跑在 arm32 的设备上,直接就加载失败。
| 架构 | 工具链 | 适用设备 |
|---|---|---|
| arm64-v8a | aarch64-linux-ohos | 主流手机和平板 |
| armeabi-v7a | arm-linux-ohos | 老款设备 |
| x86_64 | x86_64-linux-ohos | 模拟器调试 |
HarmonyOS 项目里通常会在 build-profile.json5 里配置支持的 ABI,只打包你需要的架构,不要全打,不然安装包会大很多。
五、多个 Native 库之间的依赖怎么处理
更复杂的情况是多个库之间还有依赖。比如主模块 libentry.so 依赖 libalgorithm.so,libalgorithm.so 又依赖 libcodec.so。
即使 libentry.so 直接链接正确了,如果 libcodec.so 没有打进最终的 HAP 包,运行时还是会报错。这个问题 Debug 环境下经常发现不了,因为 Debug 模式下系统可能自动加载了依赖库,Release 模式下就找不到了。
所以打包的时候要检查:直接依赖和间接依赖的 .so 都要打进去,不能只打直接依赖的。同名不同版本的 .so 也不能混在一个包里,不然加载的时候会出各种奇怪的问题。
六、为什么 Debug 能跑,Release 可能崩
这个问题最头疼。Debug 模式下好好的,Release 模式一跑就崩。
原因通常不是 Release 优化导致的,而是优化把原本隐藏的问题暴露出来了。比如未初始化的变量,Debug 模式下内存刚好是 0,看起来正常;Release 模式下内存不是 0,就出问题了。还有越界访问、悬空指针、生命周期错误,这些在 Debug 下可能不明显,Release 下就崩了。
所以 Release 崩溃的时候,不要先怀疑优化,先去查代码里有没有未定义行为。可以用 ASAN 工具跑一遍,很多问题一下就出来了。
七、业务层为什么不要直接依赖第三方 C++ API
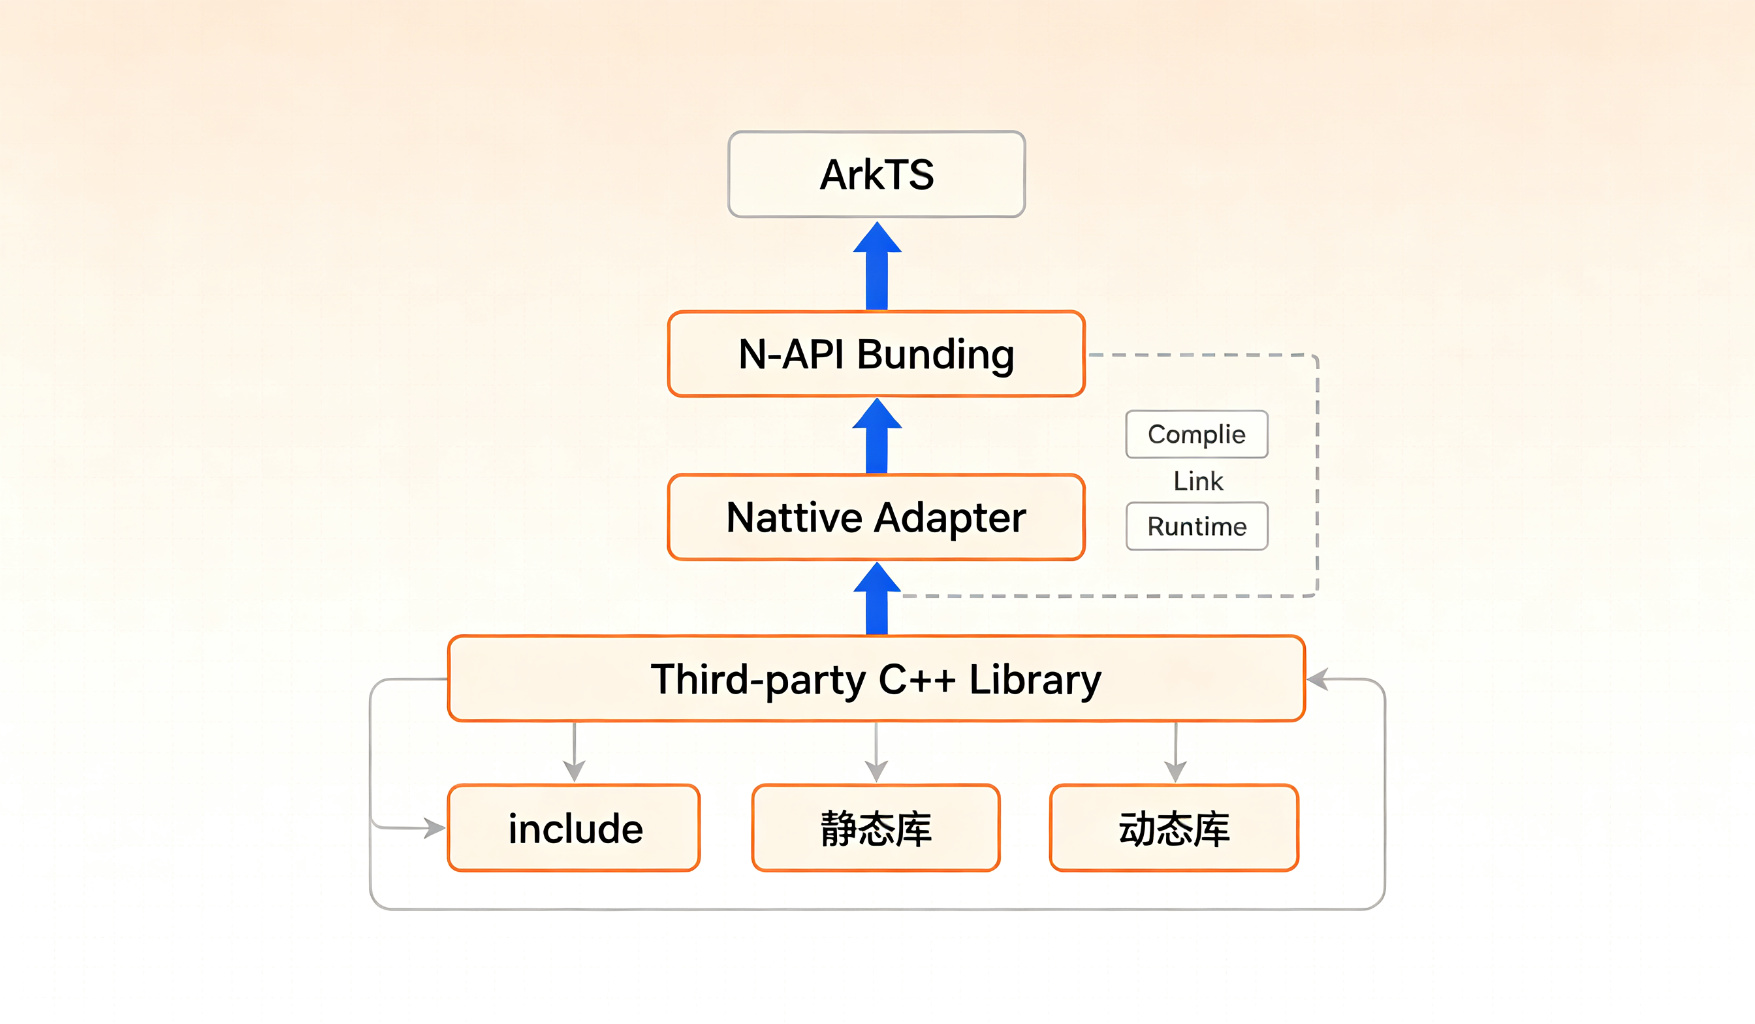
最后是架构层面的建议。业务层(ArkTS)不要直接调用第三方 C++ 库的 API,中间要加一层 Native Adapter。
ArkTS
  ↓
N-API Binding
  ↓
Native Adapter(参数转换、错误码转换、生命周期管理)
  ↓
Third-party C++ Library
为什么要加这一层?因为第三方库可能会升级,可能会换,可能会改 API。如果业务层直接依赖,那每次升级都要改业务代码。有了 Adapter 层,升级的时候只需要改 Adapter 里的实现,业务层完全不用动。
Adapter 层还负责错误码转换、内存管理、API 版本兼容这些杂事。把这些都收口在 Adapter 里,业务层就干净多了。
这套做下来最大的体会是:Native 移植不是把文件拷过来链接一下就完事了。从源码、头文件、编译、链接、ABI、打包到运行,每一层都有自己的坑。把每一层都想清楚,比闷头编译报错再去查要高效得多。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)