HarmonyOS TCP Socket 长连接与粘包拆包机制
一次 Socket 回调,不等于一条完整业务消息。
做 IM 消息推送的时候,最开始我是按“一条消息一次回调”来写的:客户端把收到的数据直接转成字符串,然后当成一条完整的消息去处理。联调时服务端一次只发一条,跑得挺顺。等真机连上之后,问题就来了——服务端连续推两条消息,客户端有时候收到一条,有时候收到两条粘在一起的,有时候一条消息被拆成两次回调。后来才搞明白,TCP 根本没有“消息”这个概念,这个认知不纠正,后面所有逻辑都是错的。
一、TCP 为什么没有“消息”的概念
TCP 是面向字节流的协议。应用层调用 Socket 的 send 写进去的是一段字节,对端 recv 读出来的也是一段字节,这两者之间没有一一对应的关系。
发送端连续发送三个业务包 A、B、C,经过网络传输之后,接收端一次 read 拿到的可能是 A,可能是 A 加半个 B,也可能是 A 加 B 加 C。数据不会丢,也不会乱,但边界完全由系统调度和网络状态决定。发送端的两次 write,接收端可能一次就读完了;发送端的一次 write,接收端也可能分成三次才读完。
所以 TCP 负责把字节可靠地送过去,至于这些字节属于哪几条业务消息,是应用协议自己需要解决的事。这个认知想不通,后面写多少代码都白搭。
二、粘包和半包到底是怎么来的
先明确一点:粘包、半包不是 TCP 出错,TCP 把字节原封不动地传过去了,是业务层错误地假设了消息边界。
半包:一条业务消息的数据还没收全,接收端就开始处理了。比如业务包 100 字节,这次 read 只读到 60 字节,剩下的 40 字节还在网络缓冲里。如果直接把 60 字节当成完整消息,解析必然出错。
粘包:多条消息的数据混在一次 read 里。发送端连续发了两条消息,接收端一次 read 把两条消息的字节全读出来了,如果直接把整个 buffer 当成一条消息,就会把两条消息拼在一起解析。
还有一种情况更隐蔽:一次 read 里既有上一条消息的剩余部分,又有这一条消息的完整数据,还有下一条消息的开头。如果只是简单地把收到的字节转成字符串再拼接,最后得到的内容就会是乱的,而且这种问题在测试环境很难复现,只有真实网络下才会冒出来。
三、业务协议为什么必须定义消息边界
既然 TCP 不保证边界,业务层就要自己定义。常见方案有四种:固定长度、特殊分隔符、Length Field、TLV。
固定长度最简单,每条消息定长,接收端按固定字节数切分就行。但业务消息长度不固定,定长了浪费带宽,定短了装不下。
特殊分隔符方案是约定一个不会出现在内容里的字符序列作为结束标记,比如 JSON 用换行符。实现简单,但内容里一旦出现这个字符就得转义,处理起来很麻烦。
我们最终用的是 Length Field,也叫长度前缀。协议头固定 6 个字节:
| 字段 | 长度 | 说明 |
|---|---|---|
| Magic | 2 字节 | 固定魔数,用于识别协议合法性 |
| Length | 4 字节 | Payload 的字节长度,不含 Header |
接收端先读 Header,校验 Magic,再读 Length,知道 Payload 有多长,就能准确切出完整消息。这里的 Length 只表示 Payload 长度,不含 Header 本身,这个约定必须在文档里写清楚,两端实现不能有歧义。字节序也要统一,服务端和客户端都用大端序,解析的时候用 DataView 指定 bigEndian,否则跨端联调会出非常难查的 bug。
四、接收缓冲区如何真正完成拆包
有了协议,接下来就是核心问题:接收缓冲区怎么拆包。
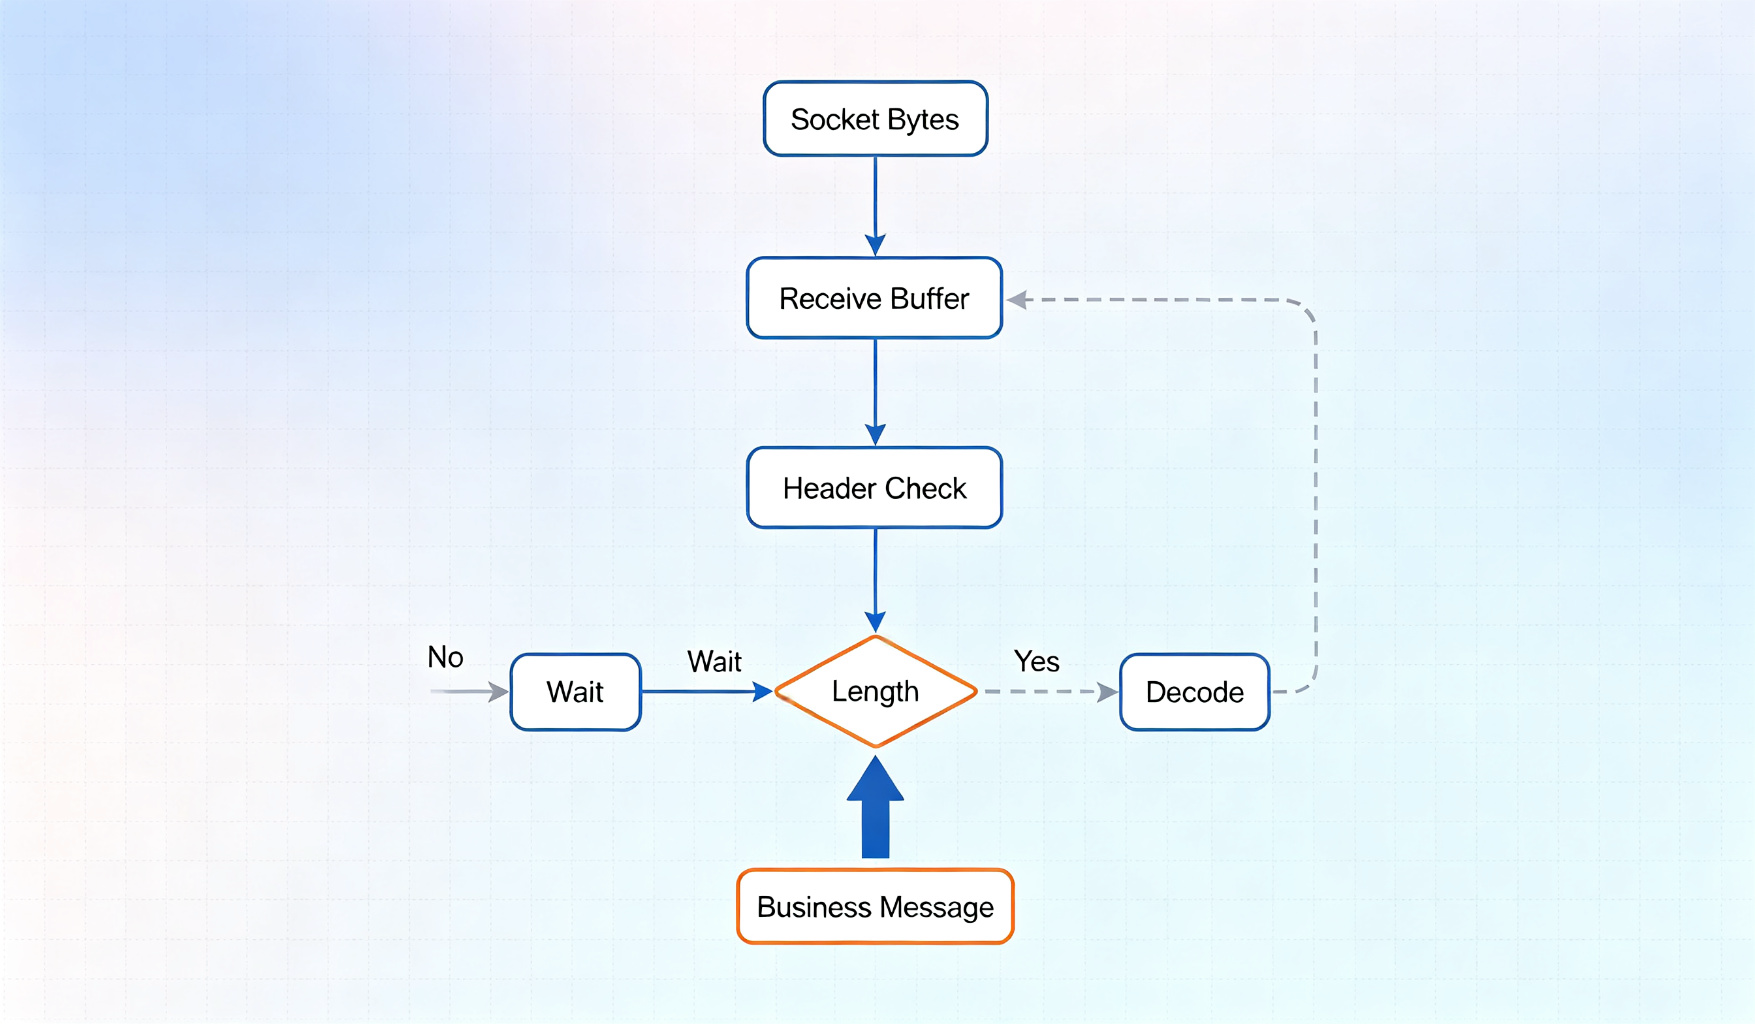
思路不复杂,但要处理的状态很多。收到新数据后,先累积到缓冲区,然后循环检查:Header 是否完整?不完整就继续等下一批数据。Header 完整就读出 Length,再检查 Payload 是否完整?不完整就保留缓冲区继续等。只有整条消息都齐了,才从缓冲区消费对应字节。一次缓冲区里可能有多条完整消息,必须循环解析,不能只解第一条就结束。
代码放在 entry/src/main/ets/network/PacketDecoder.ets,核心逻辑如下:
这段代码解决什么问题: 把接收缓冲区里的字节流,按 Length Field 协议切分成完整业务消息。
文件: entry/src/main/ets/network/PacketDecoder.ets
用途: 消息解码器,负责拆包
接入位置: Socket onMessage 回调里调用
export class PacketDecoder {
  private static readonly MAGIC: number = 0x484D;      // 'HM'
  private static readonly HEADER_SIZE: number = 6;      // 2 + 4
  private static readonly MAX_PACKET_SIZE: number = 1 * 1024 * 1024;

  // 累积缓冲区
  private buffer: Uint8Array = new Uint8Array(0);

  // 追加新收到的字节
  append(data: Uint8Array): void {
    const merged = new Uint8Array(this.buffer.length + data.length);
    merged.set(this.buffer, 0);
    merged.set(data, this.buffer.length);
    this.buffer = merged;
  }

  // 尝试从缓冲区中解析出完整消息
  decode(): Uint8Array[] {
    const messages: Uint8Array[] = [];

    while (this.buffer.length >= PacketDecoder.HEADER_SIZE) {
      const view = new DataView(this.buffer.buffer, this.buffer.byteOffset, this.buffer.length);

      // 校验 Magic
      const magic = view.getUint16(0, false);
      if (magic !== PacketDecoder.MAGIC) {
        // 协议头不合法,清空缓冲区,避免无限积压
        this.buffer = new Uint8Array(0);
        break;
      }

      // 读取 Length,只包含 Payload 长度
      const bodyLength = view.getUint32(2, false);

      // 最大包长度限制,防止异常 Length 导致缓冲区无限增长
      if (bodyLength <= 0 || bodyLength > PacketDecoder.MAX_PACKET_SIZE) {
        this.buffer = new Uint8Array(0);
        break;
      }

      const packetLength = PacketDecoder.HEADER_SIZE + bodyLength;

      // Payload 还没收全,等待下一批数据
      if (this.buffer.length < packetLength) {
        break;
      }

      // 切出完整消息
      const payload = this.buffer.slice(PacketDecoder.HEADER_SIZE, packetLength);
      messages.push(payload);

      // 消费已解析的字节,保留剩余部分继续解析
      this.buffer = this.buffer.slice(packetLength);
    }

    return messages;
  }
}
这段代码有两个关键点。第一,decode 用 while 循环而不是 if,因为一次缓冲区里可能有多条完整消息,只解一条就会积压。第二,每次消费完要重新 slice 缓冲区,把已解析的部分去掉,剩下的继续下一轮循环,这样粘包的数据才能被完整拆开。
五、为什么一定要限制最大包长度
如果不做限制,极端情况下会出大问题。假设对端发来一个异常的 Length,比如 2147483647,接收端如果完全相信它,就会一直等待一个永远不可能到达的数据包,同时缓冲区不断积累新收到的字节,内存持续增长,连接资源也无法释放。这既是异常输入,也可能是恶意攻击的入口。
所以我们把 MAX_PACKET_SIZE 设为 1MB,超过这个值的包直接丢弃并清空缓冲区。Magic 不匹配、Length 非法、Decode 失败,这几类情况都要有明确处理策略:是丢包、清缓冲区,还是断开连接,协议文档里要提前约定好,不能等出问题再临时决定。
六、心跳为什么不能只是简单启动一个 Timer
长连接要做心跳,这个都知道。但心跳如果只是启动一个 setInterval,会埋很多雷。
APP 切到后台、网络切换,Socket 可能已经不可用了,但系统不会立刻报错,Timer 还在傻乎乎地跑。断线重连如果产生多个心跳 Timer,还会出现多份心跳同时发的情况。旧连接的回调在新连接建立之后又回来,状态全乱。
所以心跳必须属于 Connection 的生命周期,连接建立时创建,连接销毁时释放,不能有一个全局的、永不释放的 Timer。心跳超时的处理也要跟着连接走:超时没收到心跳响应,就触发断线重连,而不是在 Timer 回调里直接改全局状态。
七、重连为什么容易越写越乱
重连是最容易写乱的部分。常见问题:断线事件同时触发多次 reconnect;前一次重连还没完成,新的网络事件又触发一次;老 Socket 的 onClose 回调晚到,把新连接的状态改坏。
我们的做法是引入 generation 概念,每个连接分配一个自增序号。当前连接是 #13,那 #12 后续迟到的所有事件全部忽略。重连逻辑统一收口到一个 ReconnectManager,用指数退避控制重连节奏,间隔从 1 秒、2 秒、4 秒逐步增长,最多重试 5 次,超过就提示用户手动处理。用户主动断开和网络异常断开要区分开,主动断开不触发重连。
八、最终整理 ConnectionManager
把以上逻辑收拢之后,工程结构分成五层:
| 模块 | 职责 |
|---|---|
| Business | 只发送和接收业务对象 |
| Encoder | 业务消息 → 字节流 |
| Decoder | 字节流 → 完整业务消息 |
| Heartbeat | 维护连接存活状态 |
| Reconnect | 统一管理重连节奏 |
| Socket | 底层连接和原始字节收发 |
页面层只调用 ConnectionManager 的 send 和 onMessage,不直接管理 Buffer、Timer、重连和 Socket 回调。每个模块职责单一,出问题能快速定位。做完这一版之后,测试环境跑粘包用例、半包用例、断线重连用例,逻辑都稳定了,之前的字符串拼接方案早就删掉了。
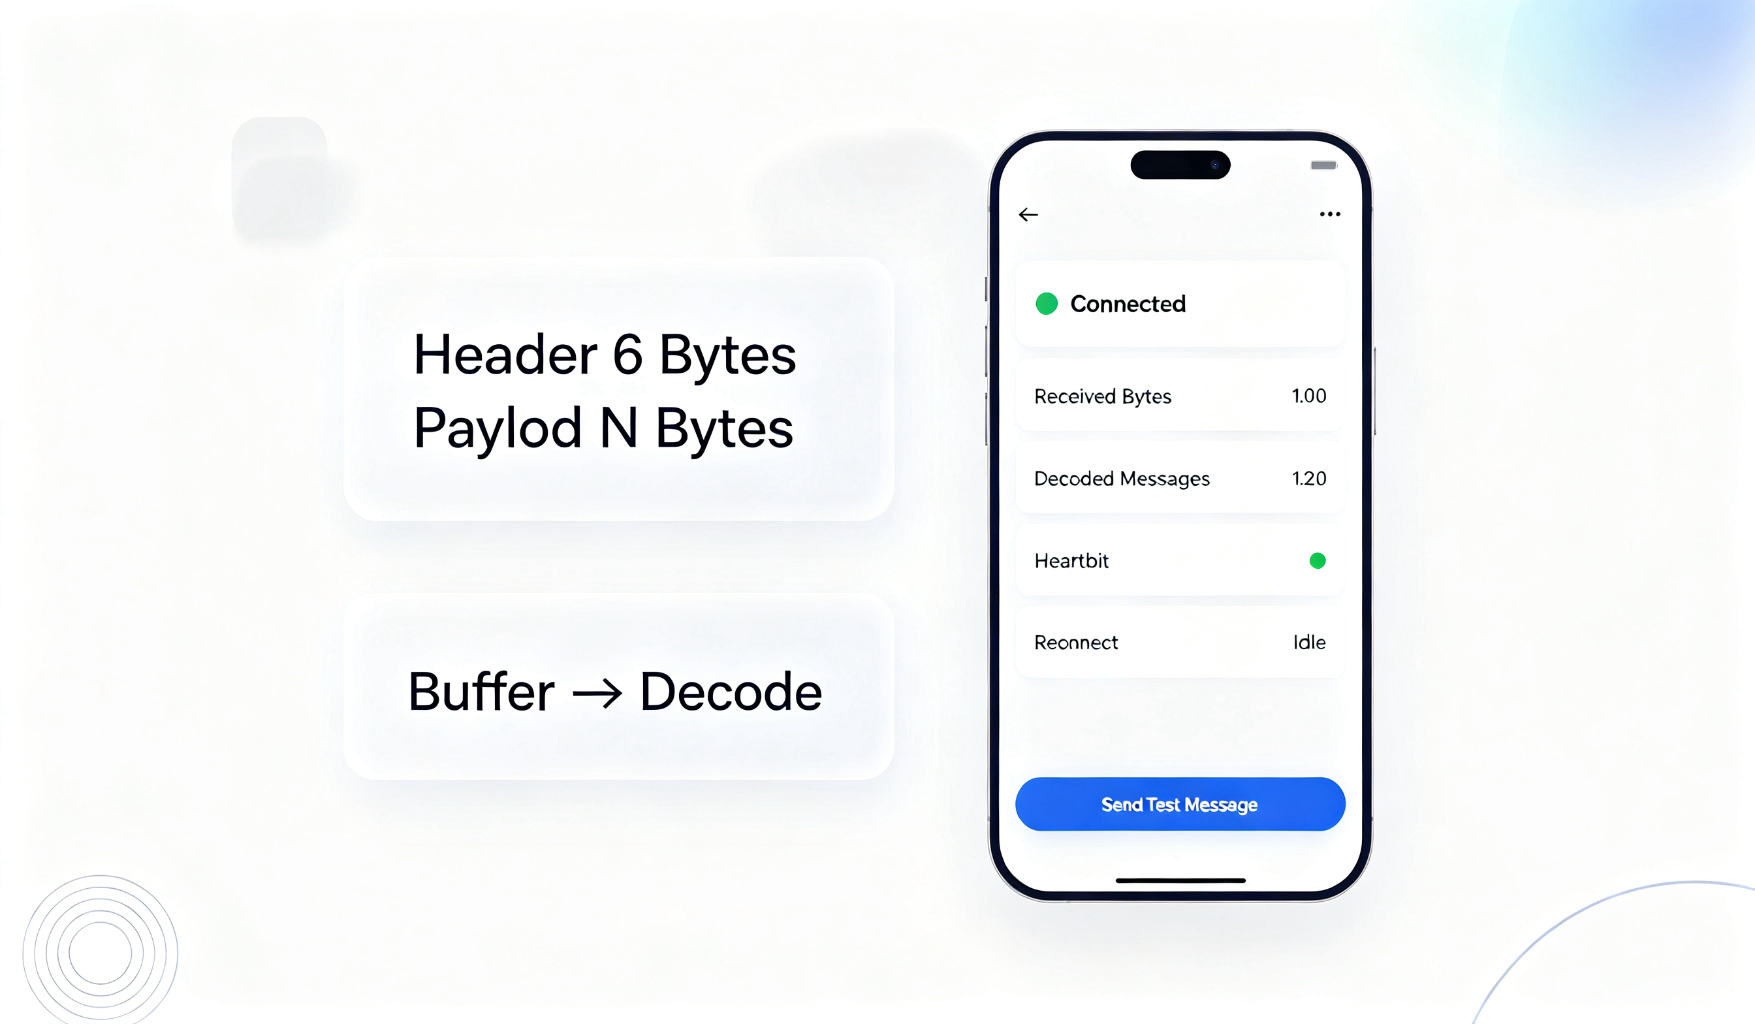
这一套做下来,最大的体会是:Socket 开发难的从来不是 API,而是状态管理。消息边界、缓冲区、心跳、重连,每一个都是一整块状态机,想清楚状态怎么流转,比背 API 参数重要得多。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)