HarmonyOS 7 LazyLayoutAlgorithm 滚动后跳位?可视窗口、尺寸缓存和稳定锚点怎么一起算
HarmonyOS 7 LazyLayoutAlgorithm 滚动后跳位?可视窗口、尺寸缓存和稳定锚点怎么一起算
版本范围:HarmonyOS 7、API 26。本文讨论的是懒布局里的工程问题,不把教学封装冒充系统 API。华为 2026 年 7 月开发者月刊说明,HarmonyOS 7(API 26)Beta2 新增懒加载自定义布局场景指南,可通过
LazyLayoutAlgorithm实现任意布局模式,并只创建、布局父可滚动组件可视区域内的子组件。具体接口签名和 Beta 状态应以当前 API 26 SDK 与官方参考为准。
很多列表的性能问题并不发生在第一次打开,而是发生在“数据回来以后”:图片尺寸回填、字体缩放改变、自由窗口变宽、卡片插入到顶部,页面突然跳一下,甚至出现卡片重叠和空白。
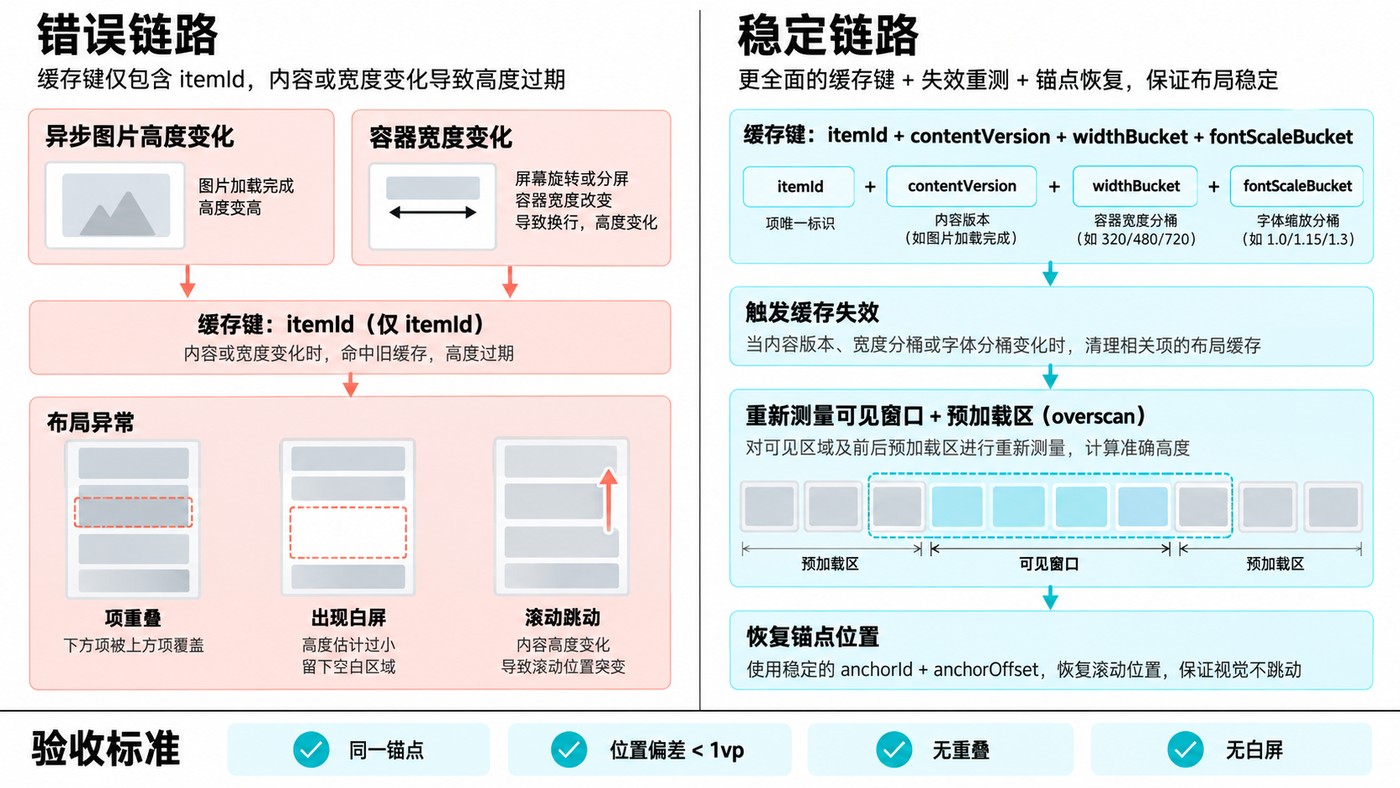
这类问题不能只靠“多加一点预加载”解决。真正要同时处理三件事:
- 只计算可视窗口和适量预加载区,避免把懒布局重新写成全量布局;
- 尺寸缓存要能识别内容、宽度和字体变化,旧结果不能继续命中;
- 重排前先记住稳定锚点,重排后恢复同一个条目在视口里的相对位置。
先说明能力边界
适合使用 LazyLayoutAlgorithm 的场景,是规则列表、固定网格和普通瀑布流已经不能准确表达布局规则,例如:
- 卡片高度不固定,并且可能跨列;
- 运行时需要切换列数或布局策略;
- 数据量大,不能一次创建全部子组件;
- 插入、删除、异步图片回填后仍要保持当前位置稳定。
如果只是固定高度列表,直接使用成熟的 List 或 Grid 更稳。自定义懒布局的价值不是“代码更高级”,而是它能解决内置布局无法表达的约束;代价是测量、缓存、锚点恢复和回退策略都要由开发者负责。
问题一:图片加载完成后,列表为什么会突然跳动
复现步骤
准备一批包含网络图片的卡片。首屏先用 1:1 比例估算高度,图片加载完成后再使用真实宽高比。
- 打开页面并滚动到第 40 项;
- 保持手指不动,等待前面若干图片完成解码;
- 图片真实高度替换估算高度;
- 重新计算后,第 40 项在内容坐标中的
y已改变; - 如果滚动偏移仍是旧值,视口里看到的内容就会跳动。
根因不是图片加载,而是布局系统只记住了“滚动了多少像素”,没有记住“用户正在看哪一个条目,以及它离视口顶部多远”。
正确做法:保存稳定锚点
重排前记录两个值:
anchorId:当前视口中作为基准的稳定业务 ID;anchorOffset:该条目顶部与视口顶部的距离。
重排后重新找到同一个 ID,用新的内容坐标减去原来的相对距离,得到新的滚动位置。
interface LayoutRect {
  id: string
  x: number
  y: number
  width: number
  height: number
}

interface ViewportAnchor {
  id: string
  offsetInViewport: number
}

function captureAnchor(
  rects: LayoutRect[],
  scrollOffset: number
): ViewportAnchor | undefined {
  const firstVisible = rects.find((item: LayoutRect) =>
    item.y + item.height >= scrollOffset
  )
  if (!firstVisible) {
    return undefined
  }
  return {
    id: firstVisible.id,
    offsetInViewport: firstVisible.y - scrollOffset
  }
}

function restoreScrollOffset(
  rects: LayoutRect[],
  anchor: ViewportAnchor | undefined,
  fallback: number
): number {
  if (!anchor) {
    return fallback
  }
  const item = rects.find((value: LayoutRect) => value.id === anchor.id)
  return item ? item.y - anchor.offsetInViewport : fallback
}
这里必须使用业务稳定 ID,不能使用数组下标。顶部插入一条数据后,所有下标都会变化;业务 ID 不变,锚点才有恢复意义。
问题二:横竖屏切换后,为什么会出现重叠和空白
复现步骤
假设两列瀑布流在 720vp 宽度下完成测量,缓存键只有 itemId。
- 将窗口调整到 1080vp,或在平板自由窗口中拖动边界;
- 列宽改变,文本换行数也改变;
- 缓存仍通过
itemId命中 720vp 下的旧高度; - 后续条目继续在错误的
y位置累加; - 结果就是卡片覆盖、空白区或者滚动范围不正确。
只要会影响测量结果的输入没有进入缓存键,缓存就不是优化,而是在复用错误答案。
尺寸缓存至少要包含四类信息
interface LayoutItem {
  id: string
  contentVersion: number
  aspectRatio: number
  textLines: number
}

function widthBucket(width: number): number {
  return Math.round(width / 40) * 40
}

function fontScaleBucket(scale: number): number {
  return Math.round(scale * 20) / 20
}

function createMeasureKey(
  item: LayoutItem,
  containerWidth: number,
  fontScale: number
): string {
  return [
    item.id,
    item.contentVersion,
    widthBucket(containerWidth),
    fontScaleBucket(fontScale)
  ].join(':')
}
id解决“这是哪一个条目”;contentVersion解决标题、图片、标签变化;widthBucket解决窗口和列宽变化;fontScaleBucket解决字体缩放与无障碍设置变化。
分桶的作用是避免窗口每变化 1vp 就创建一份缓存。桶大小不能照抄,应该根据卡片断行敏感度测量后确定。
一个可测试的瀑布流规划器
下面这段代码只负责“输入数据,输出矩形”,不在测量过程中请求网络,也不修改页面状态。这样的纯算法可以脱离 UI 做测试,再由 API 26 的布局适配层把结果交给 LazyLayoutAlgorithm。
class MasonryPlanner {
  plan(
    items: LayoutItem[],
    containerWidth: number,
    columns: number,
    gap: number,
    fontScale: number,
    measured: Map<string, number>
  ): LayoutRect[] {
    const safeColumns = Math.max(1, columns)
    const columnWidth =
      (containerWidth - gap * (safeColumns - 1)) / safeColumns
    const columnHeights: number[] = Array(safeColumns).fill(0)

    return items.map((item: LayoutItem) => {
      const shortest = Math.min(...columnHeights)
      const column = columnHeights.indexOf(shortest)
      const key = createMeasureKey(item, containerWidth, fontScale)
      const safeRatio =
        Number.isFinite(item.aspectRatio) && item.aspectRatio > 0
          ? item.aspectRatio
          : 1

      const estimatedHeight =
        columnWidth / safeRatio + item.textLines * 22 * fontScale
      const height = measured.get(key) ?? estimatedHeight

      const rect: LayoutRect = {
        id: item.id,
        x: column * (columnWidth + gap),
        y: columnHeights[column],
        width: columnWidth,
        height
      }
      columnHeights[column] += height + gap
      return rect
    })
  }
}
这段实现有两个值得保留的细节:
- 非法宽高比回退到 1,避免
NaN继续污染整列坐标; - 测量缓存与规划器分离,规划器本身没有副作用,便于复用和测试。
可视窗口不能简单遍历全部条目
最直观的写法是先计算所有矩形,再用 filter 找可见项。数据量小时可以验证正确性,但数据量大后,每次滚动仍然遍历全部数据,不符合懒布局目标。
第一版可以先定义正确的相交规则:
interface Viewport {
  offset: number
  extent: number
  overscan: number
}

function intersects(rect: LayoutRect, viewport: Viewport): boolean {
  const start = Math.max(0, viewport.offset - viewport.overscan)
  const end = viewport.offset + viewport.extent + viewport.overscan
  return rect.y + rect.height >= start && rect.y <= end
}
再把定位方式从全量遍历逐步替换成:
- 固定高度:直接计算起止索引;
- 不等高单列:使用前缀和二分查找;
- 多列瀑布流:每列维护有序区间,再合并候选项;
- 动态插入:只重算受影响列和后续区间。
overscan 不是越大越好。过小会在快速滚动时来不及准备;过大会重新造成大量无效创建。它应由目标设备上的快速滑动测试决定,而不是写死一个“看起来安全”的大数。
两个案例应该怎样接入
案例 A:异步图片回填
处理顺序:
- 图片未完成时使用可解释的比例估算;
- 图片完成后增加对应条目的
contentVersion; - 重排前捕获当前锚点;
- 只让相关缓存键失效;
- 重新测量可视窗口与预加载区;
- 用稳定 ID 恢复滚动位置。
不建议在布局测量回调里启动图片请求。测量可能被多次调用,网络请求和状态写入会引起重入,甚至形成不断触发布局的循环。
案例 B:自由窗口和字体缩放
处理顺序:
- 容器宽度进入新的
widthBucket时失效旧尺寸; - 字体比例进入新的
fontScaleBucket时失效文本相关尺寸; - 重新计算列数、列宽和卡片高度;
- 保持同一个
anchorId的视口相对位置; - 宽度连续拖动时合并刷新,不要对每个像素变化都全量重排。
如果只改列数不改缓存键,旧高度仍会被复用;如果只清缓存不恢复锚点,页面仍会跳。这两部分必须一起做。
我实际验证了什么
我把规划器和锚点恢复逻辑独立运行,覆盖了四个断言:
- 720vp、三列、12vp 间距时,所有卡片都在容器边界内;
- 容器从 720vp 变为 1080vp、字体比例从 1.0 变为 1.2 后,所有缓存键都发生变化;
- 重排前后同一个锚点在视口中的位置偏差小于 1vp;
- 宽高比为 0 时触发安全回退,不产生负高度或非数值坐标。
本次算法层测试全部通过。这里的结论只证明“缓存键、坐标规划和锚点恢复”逻辑成立,不等同于 API 26 真机性能结论。正式接入后还需要在当前 SDK、目标设备和自由窗口场景中验证首帧、快速滚动、内存和回收行为。
为什么不优先选择其他方案
| 方案 | 优点 | 局限 | 适用场景 |
|---|---|---|---|
| List / Grid | 成熟稳定、维护成本低 | 难表达高度动态和特殊跨列规则 | 规则列表、固定网格 |
| WaterFlow | 瀑布流能力现成 | 特殊锚点与运行时布局规则受组件边界限制 | 常规图片流 |
| 全量自定义布局 | 控制力强 | 数据量大时首帧和内存压力明显 | 数据量小、固定展示 |
| LazyLayoutAlgorithm | 可自定义布局并限制创建范围 | 需要自行管理缓存、锚点和回退 | 大数据量、不规则动态布局 |
工程上最优的选择通常不是“最自由”,而是满足需求后复杂度最低。只有内置组件无法稳定表达规则时,才值得承担自定义懒布局的维护成本。
上线前检查清单
- 数据使用稳定业务 ID,没有用数组下标当 key
- 缓存键包含内容版本、宽度分桶和字体缩放分桶
- 数据插入、删除、图片回填前捕获锚点
- 重排后恢复锚点相对视口的位置
- 测量过程无网络请求、无业务状态写入
- 可视区定位没有在每次滚动时全量扫描
- overscan 在真实设备快速滑动下测过
- 异常比例、空数据和锚点丢失都有回退
- API 26 设备与兼容设备分别验证
- 当前 SDK 接口签名与官方参考一致
参考资料
懒布局真正难的不是“少创建几个组件”,而是数据和环境变化后仍能让用户看到原来的位置。把缓存键、可视窗口和稳定锚点拆开测试,问题就从难以复现的 UI 抖动,变成可以逐项验证的工程逻辑。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 1
 0
- 0


 已为社区贡献636条内容

所有评论(0)