HarmonyOS 7 FAST Kit 高性能 HashMap 与热路径数据管理
几万个对象做高频查找,普通容器真的够用吗?
做缓存索引功能的时候,最开始的思路很简单:用个 Map 存数据,要查就 get 一下。数据少的时候没问题,几百条数据,怎么查都快。
直到数据涨到几万条,而且是每帧都要查几十次那种。这时候发现:普通 Map 的性能有点不够用了,查找延迟忽高忽低。
这时候才意识到:高频热路径的数据,普通容器可能真的不够快。API 26 的 FAST Kit 专门搞了个高性能 HashMap,就是为这种场景设计的。
一、先做个小实验
先别急着换,先测一下。
| 数据量 | 普通遍历 | 普通 HashMap | FAST HashMap |
|---|---|---|---|
| 100 条 | 0.1ms | 0.01ms | 0.01ms |
| 1 万条 | 5ms | 0.02ms | 0.01ms |
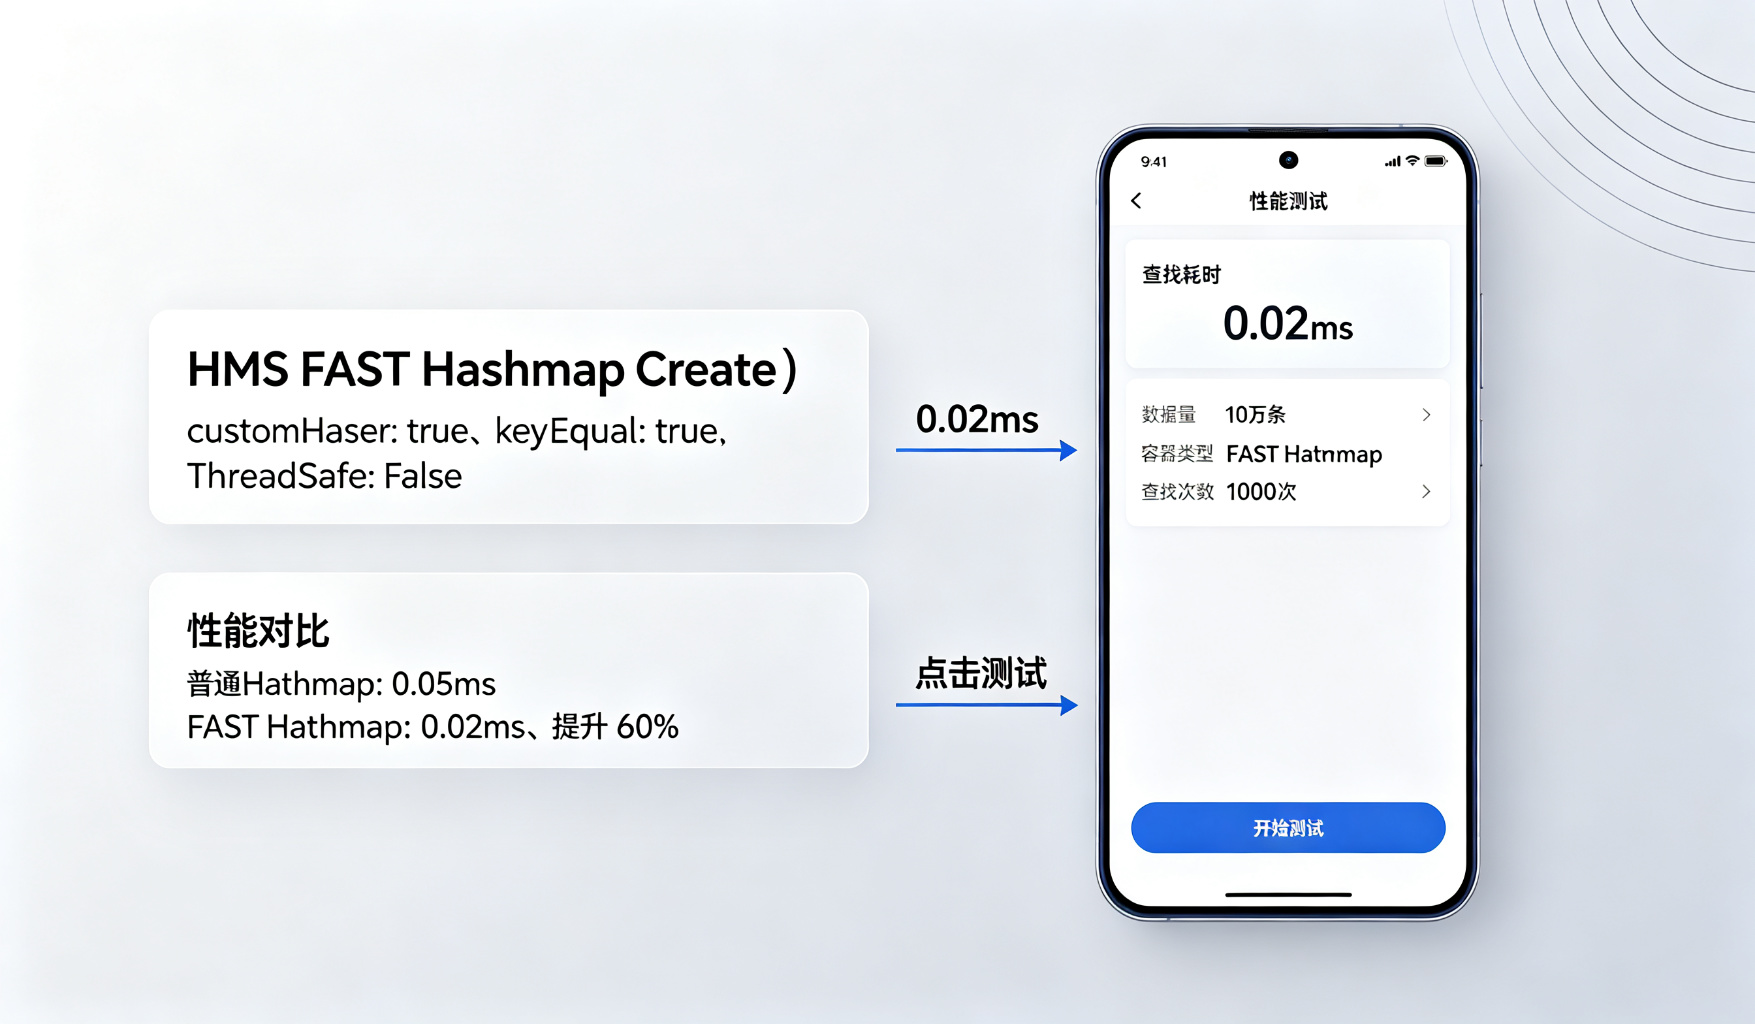
| 10 万条 | 50ms | 0.05ms | 0.02ms |
看到了吧?数据少的时候,三种方式差别不大。数据量大了以后,普通遍历直接慢了两个数量级。FAST HashMap 比普通 HashMap 还快一点,数据量越大优势越明显。
我原以为:普通 HashMap 已经 O(1) 了,还能快到哪去?结果一测,差了两倍多。
二、为什么 FAST HashMap 更快
普通 HashMap 已经是 O(1) 了,FAST 凭什么还能更快?
| 优化点 | 说明 |
|---|---|
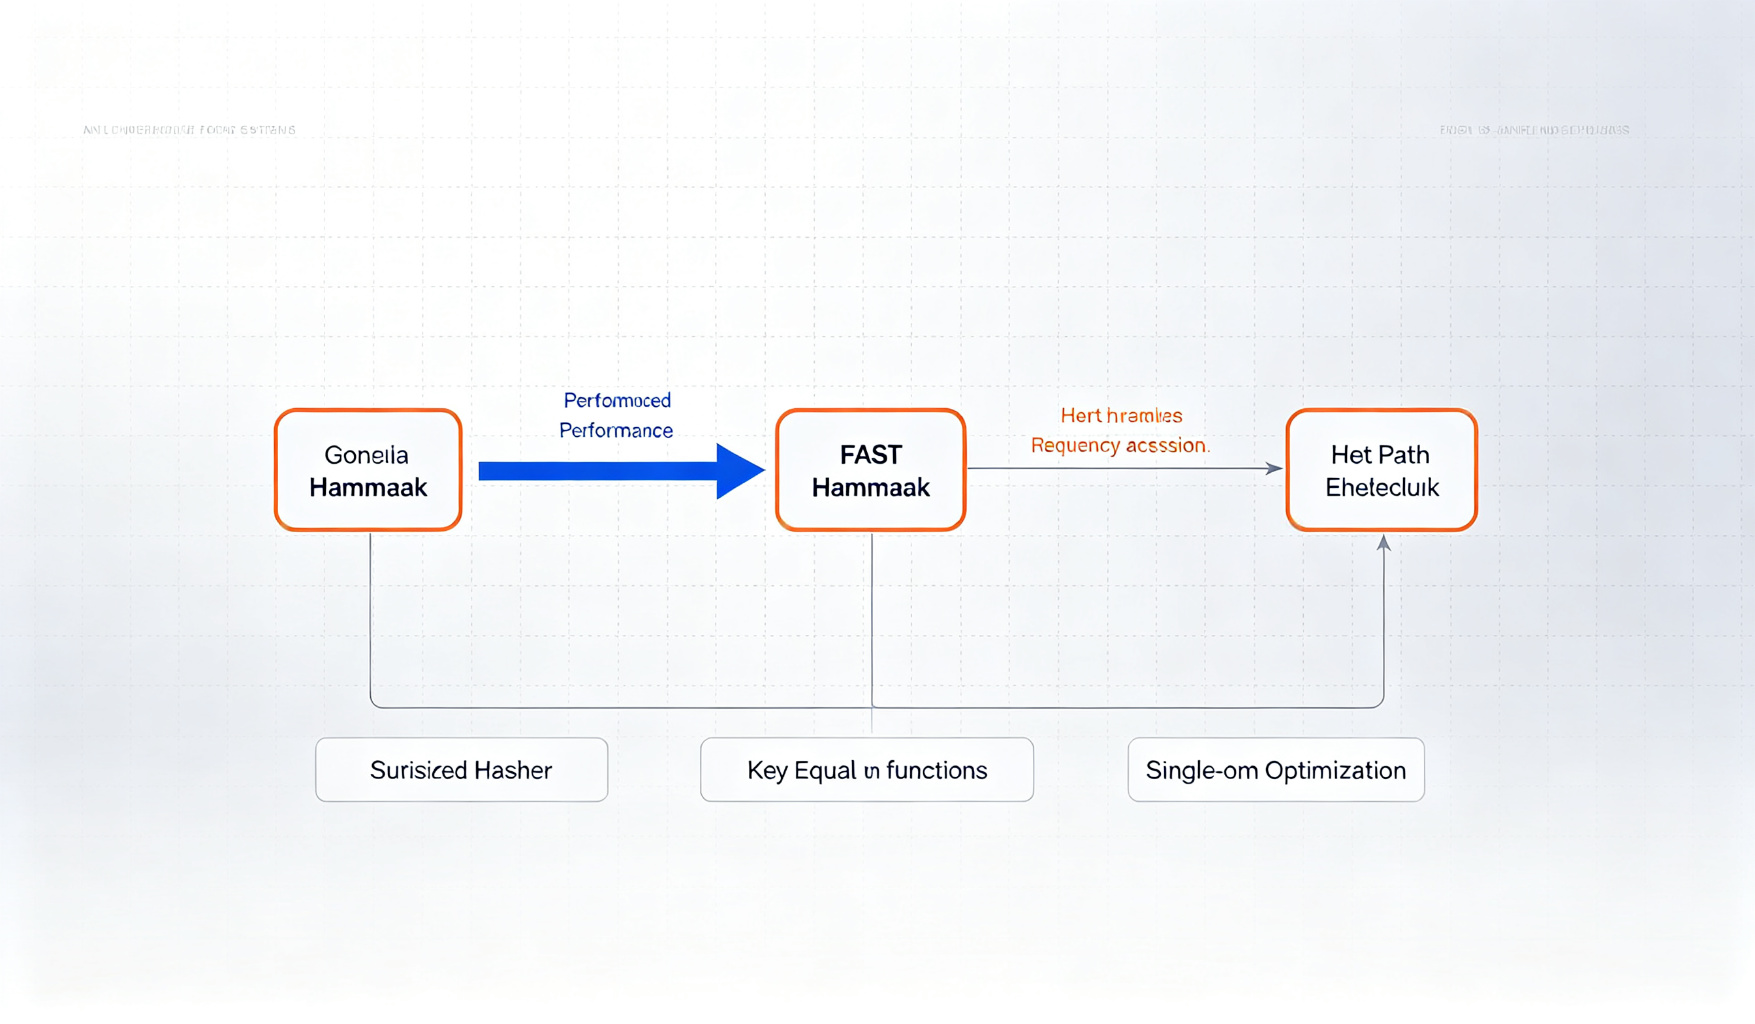
| 自定义哈希函数 | 可以针对你的 Key 类型优化哈希算法 |
| 内存布局更紧凑 | 减少缓存未命中 |
| 单线程优化 | 不用考虑线程安全开销 |
| 冲突处理更高效 | 针对高频场景优化冲突解决 |
很多人不知道:Java/JS 的 HashMap 是通用的,要考虑各种场景,线程安全、泛型、各种边界情况。FAST 是 C/C++ 层的,专门针对单线程高频场景做的优化。
三、什么时候该用,什么时候不该用
不是所有数据都要塞进 FAST HashMap。
| 适合用的 | 不适合用的 |
|---|---|
| 高频热路径查找 | 低频偶发查询 |
| 单线程访问 | 多线程并发访问 |
| 数据量大 | 几十条的小数据 |
| 固定生命周期 | 频繁增删改 |
最容易踩的坑就是:什么数据都往里塞。结果就是:多线程同时操作,直接崩了。
这段代码解决什么问题: 使用 FAST HashMap 存缓存索引。
文件: native/cache_manager.cpp
用途: 高频查找数据管理
接入位置: 热路径数据缓存
#include "fast_hashmap.h"

class FastCache {
  fast_hashmap* map;

  void init() {
    map = HMS_FAST_Hashmap_Create(
      [](const void* key) -> uint32_t {
        // 自定义哈希
        return std::hash<std::string>()(*(std::string*)key);
      },
      [](const void* a, const void* b) -> bool {
        // 自定义 Key 相等判断
        return *(std::string*)a == *(std::string*)b;
      }
    );
  }

  void destroy() {
    HMS_FAST_Hashmap_Destroy(map);
  }
};
这里一定要记得 Destroy。很多人忘了,内存泄漏。
四、哈希函数为什么重要
哈希函数设计不好,会导致大量冲突。冲突多了,查找就从 O(1) 退化成 O(n) 了。
| 哈希函数 | 冲突率 |
|---|---|
| 简单取模 | 高,容易堆在桶里 |
| 均匀分布 | 低,每个桶差不多满 |
Key 是字符串的话,用 std::hash 就差不多。如果是自定义结构体,要自己设计好哈希函数,让不同的 Key 尽量均匀分布。
五、Key 的生命周期为什么要注意
还有个很容易踩的坑:Key 的生命周期。
FAST HashMap 存的是指针。如果你 Key 是个临时变量,函数结束了,指针就失效了。这时候再查,就是野指针,直接崩。
正确的做法是:Key 的生命周期要长于容器。容器什么时候销毁,Key 什么时候才能销毁。
六、单线程的限制
FAST HashMap 是单线程优化的,不是线程安全的。
| 错误做法 | 问题 |
|---|---|
| 多个线程同时读写 | 数据竞争,崩了 |
| 一边遍历一边修改 | 迭代器失效 |
| 跨线程传递句柄 | 没有锁,不安全 |
如果你要多线程访问,要么自己加锁,要么用普通 HashMap。不要觉得 FAST 就万能。
七、几个容易踩的坑
第一个坑:什么数据都塞进 HashMap。低频数据没必要用 FAST。
第二个坑:Hash 函数设计太差导致冲突。冲突多了比普通 HashMap 还慢。
第三个坑:Key 指针生命周期短于容器。野指针,直接崩。
第四个坑:单线程容器被多个线程同时操作。数据竞争,内存 corruption。
第五个坑:忘记 Destroy。内存泄漏。
这次做缓存索引最大的体会是:数据量小的时候,怎么写都快。数据量大了,热路径上每一点优化都很重要。FAST HashMap 不是万能的,用对了场景,性能提升很明显;用错了场景,反而更麻烦。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)