HarmonyOS 7 OCR 识别成功却录错金额:方向检测、字段校验与人工复核链路
HarmonyOS 7 OCR 识别成功却录错金额:方向检测、字段校验与人工复核链路
报销页面拍了一张小票,OCR 正常返回文本,应用也顺利把“¥128.00”填进金额框,但财务提交后才发现识别成了“¥123.00”。接口没有报错,页面也没有崩溃,问题却比一次失败更危险:应用把“识别结果”误当成了“可信业务数据”。
Core Vision Kit 的通用文字识别支持从相机或图库图片中检测文字、位置和内容,并支持方向检测。它并不是 HarmonyOS 7/API 26 才首次出现的接口,因此本文讨论的是 HarmonyOS 7 工程中的可靠处理链路,不把旧能力包装成 7.0 新增特性。
验证与边界:本文先核对华为官方文档与 API 版本,再用可执行的宿主逻辑测试验证状态转换、排序、幂等或资源预算。当前本机 DevEco SDK 为 API 24,且没有 HDC 真机,因此文中的 API 26 接口代码属于依据官方签名整理的接入骨架,不宣称已经完成 API 26 工程编译或真机实测。正式上线前仍需在 API 26 SDK 与目标设备上完成编译、运行、异常分支和资源指标验收。
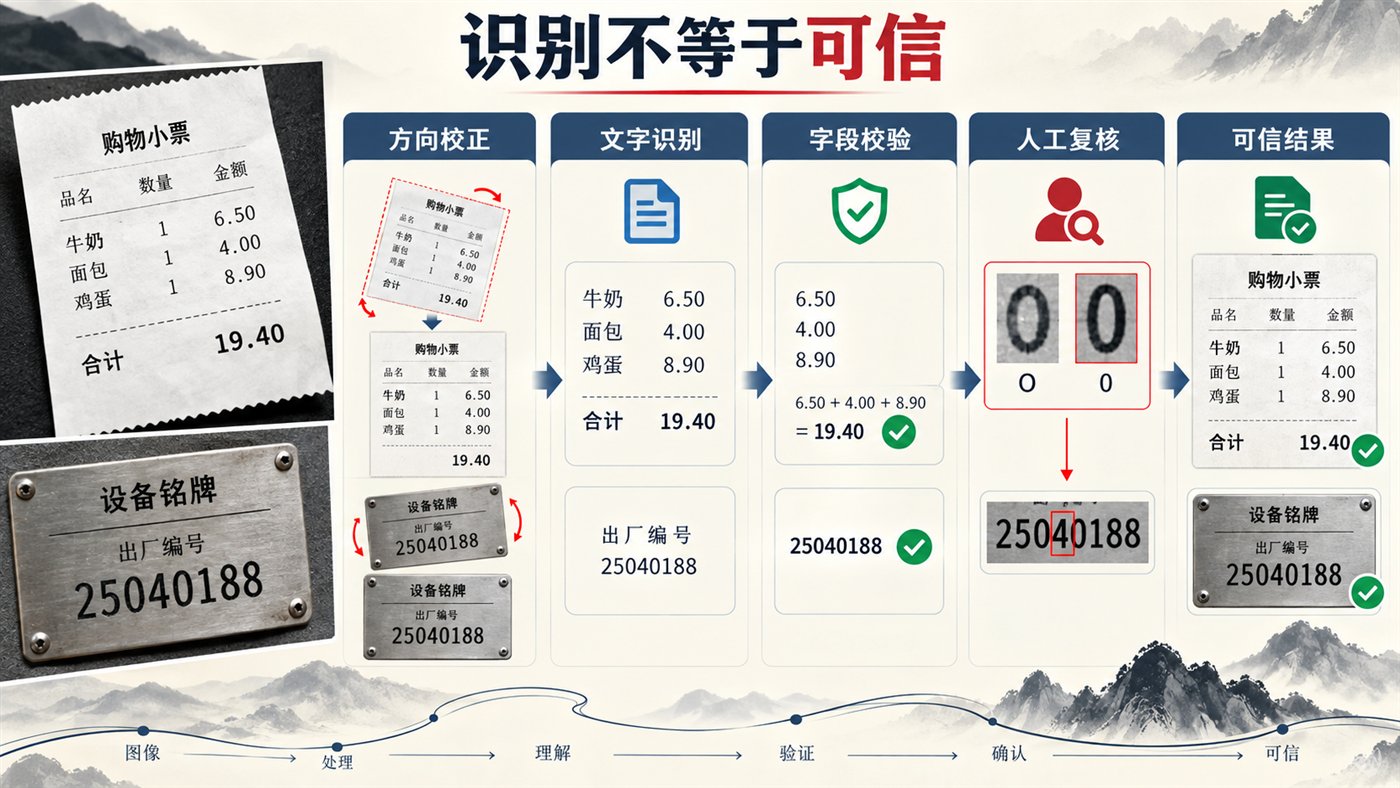
一条可靠链路应该有五层
输入质量检查、方向处理、OCR 识别、业务字段校验、人工复核。任何一层都可能拒绝继续。recognizeText 返回成功只说明识别流程完成,不说明金额、日期、编号已经满足业务规则。
import { textRecognition } from '@kit.CoreVisionKit';

async function prepareOcr(): Promise<void> {
  const ok = await textRecognition.init();
  if (!ok) throw new Error('文字识别服务初始化失败');
}

async function releaseOcr(): Promise<void> {
  await textRecognition.release();
}
具体识别输入应按照官方 VisionInfo 与配置项构造。若图片方向已知,可以评估关闭方向检测以减少额外处理;若来自用户随手拍摄,则不要为了性能默认关闭。
案例一:票据金额必须经过交叉校验
金额字段不能只靠一个正则表达式。至少同时检查币种符号、数值范围、小数位、合计关键词附近的位置,以及用户当前报销单的预期范围。多个候选值时展示原图局部和候选列表,让用户确认,而不是静默选最大值。
interface AmountCandidate { text: string; nearTotal: boolean; lineIndex: number }

function chooseAmount(items: AmountCandidate[]): AmountCandidate | undefined {
  const valid = items.filter(v => /^¥?d+(.d{2})?$/.test(v.text));
  const nearTotal = valid.filter(v => v.nearTotal);
  if (nearTotal.length === 1) return nearTotal[0];
  return undefined; // 歧义时进入人工复核,不擅自猜测
}

console.assert(chooseAmount([
  { text: '128.00', nearTotal: true, lineIndex: 8 },
  { text: '8.00', nearTotal: false, lineIndex: 3 }
])?.text === '128.00');
console.assert(chooseAmount([
  { text: '123.00', nearTotal: true, lineIndex: 8 },
  { text: '128.00', nearTotal: true, lineIndex: 9 }
]) === undefined);
可观察结果是:唯一且符合规则的候选自动填入;出现两个合计候选时,页面进入复核态并禁止直接提交。
案例二:设备铭牌要保留原始文本
设备序列号常同时包含字母 O、数字 0、字母 I 和数字 1。把 OCR 结果立即大写、去空格并覆盖原文,会让后续排查失去证据。正确做法是同时保存原始识别文本、规范化文本和用户确认值。
interface FieldEvidence { raw: string; normalized: string; confirmed?: string }

function normalizeSerial(raw: string): FieldEvidence {
  return {
    raw,
    normalized: raw.toUpperCase().replace(/[s-]/g, '')
  };
}

const evidence = normalizeSerial('ab-O1 20');
console.assert(evidence.raw === 'ab-O1 20');
console.assert(evidence.normalized === 'ABO120');
这个案例的目标不是自动纠正 O/0,而是保留证据并把歧义暴露给用户。只有当设备型号规则可以确定字符集合时,才进行自动替换。
失败信号要直接显示
| 现象 | 应用判断 | 页面动作 |
|---|---|---|
| 图片模糊或文字过小 | 输入质量不足 | 引导重拍,不启动识别 |
| 多个金额候选 | 业务字段有歧义 | 展示局部图并要求确认 |
| 序列号字符冲突 | 规则无法唯一确定 | 保留原文,禁止自动覆盖 |
| 识别服务异常 | 能力不可用 | 保存图片,允许稍后重试 |
为什么不推荐“识别完直接写数据库”
直接入库代码最短,但错误会扩散到搜索、报表和审核。推荐把 OCR 输出放入临时证据对象,经过规则校验和用户确认后再写正式记录。对低风险的搜索关键词可以自动接受,对金额、证件号、序列号等高风险字段必须提高门槛。
可复用的封装边界
不要封装一个“万能 OCR 页面”,而是拆成四层:图片输入与质量检查、OCR 适配器、领域校验器、复核 UI。前两层可跨业务复用,领域校验器必须由票据、设备、证件等各自维护,复核 UI 只负责展示证据和确认结果。
上线清单
- 相机与图库输入都覆盖方向、模糊、反光和裁剪测试。
- 原始文本、规范化文本、确认值分开保存。
- 高风险字段不在 OCR 成功后直接提交。
- 服务初始化与释放和页面生命周期一致。
- 日志不打印完整票据、证件或敏感识别内容。
- 错误样本可以脱敏后进入回归集合。
官方资料
OCR 的价值不是少打几个字,而是在可控风险下减少录入。成功回调只是链路中点,规则校验、证据保留和人工复核才决定数据是否可信。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献685条内容

所有评论(0)