深圳政务大厅上线鸿蒙AI数字人终端
边聊边办:政务自助终端的语音拟人化实践——ASR、智能打断与TTS的场景化优化
在政务服务自助终端的应用中,传统人工引导、导办、帮办需要大量培训,且服务质量受人员情绪和状态影响,不仅人力成本高,服务效率与沟通稳定性也难以保证。语音拟人化技术正在改变这一局面:通过高度仿真的语音交互,AI数字人可以7×24小时稳定工作,承接部分人工客服职能,在降低成本的同时提升服务效率与用户体验。
要真正做到“像人一样交流”,需要突破三大技术关卡:ASR(自动语音识别)精准听懂用户需求,应对方言、口音、背景噪音;会话智能打断,允许用户随时插话,避免机械式“一问一答”;TTS(语音合成)用带情感、有呼吸感的声线,消除“机器人”感。本文逐一拆解这三项技术的场景化优化实践。
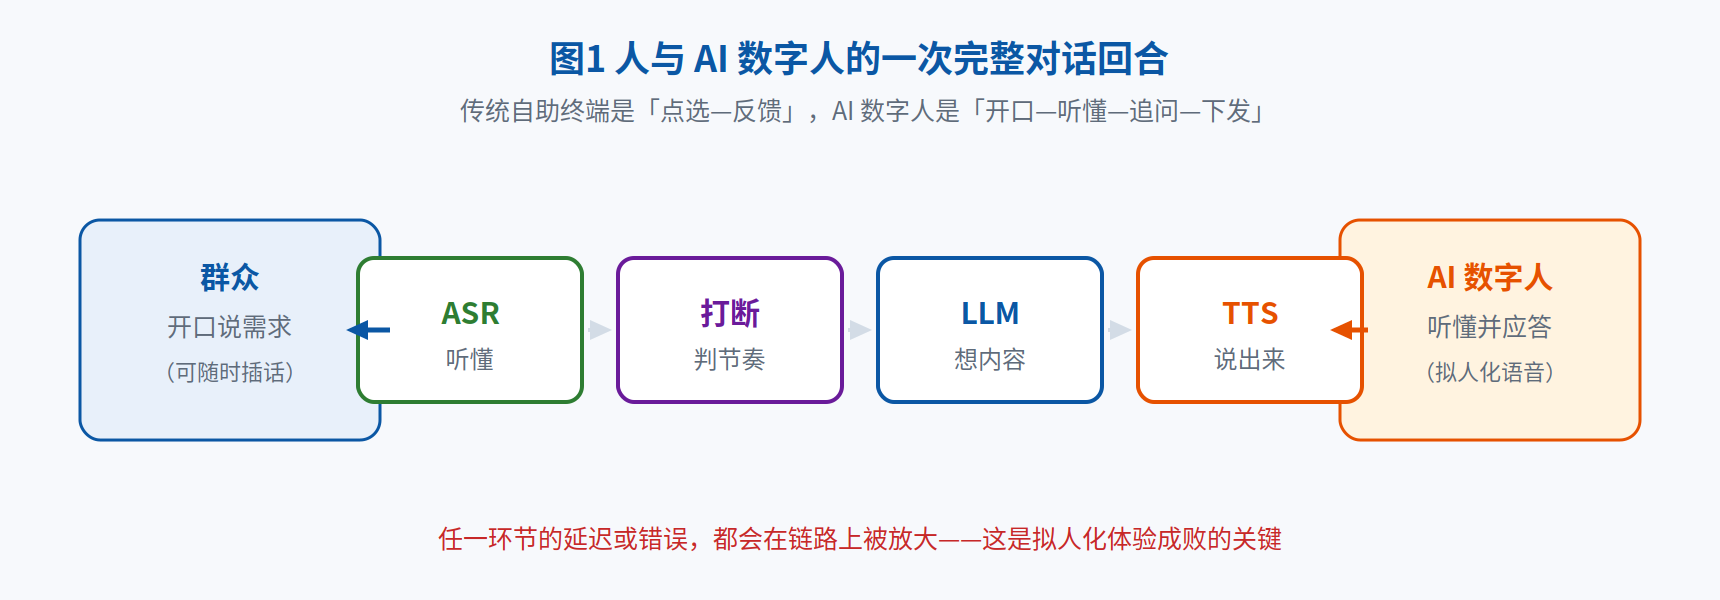
图1 人与AI数字人的一次完整对话回合
一、ASR:拟人交互的“听觉中枢”
拟人化的第一步是让机器准确理解语音。如果ASR识别错误率高,后续交互会出现大量“答非所问”。在自助终端场景中,通用ASR模型面临三个核心挑战:
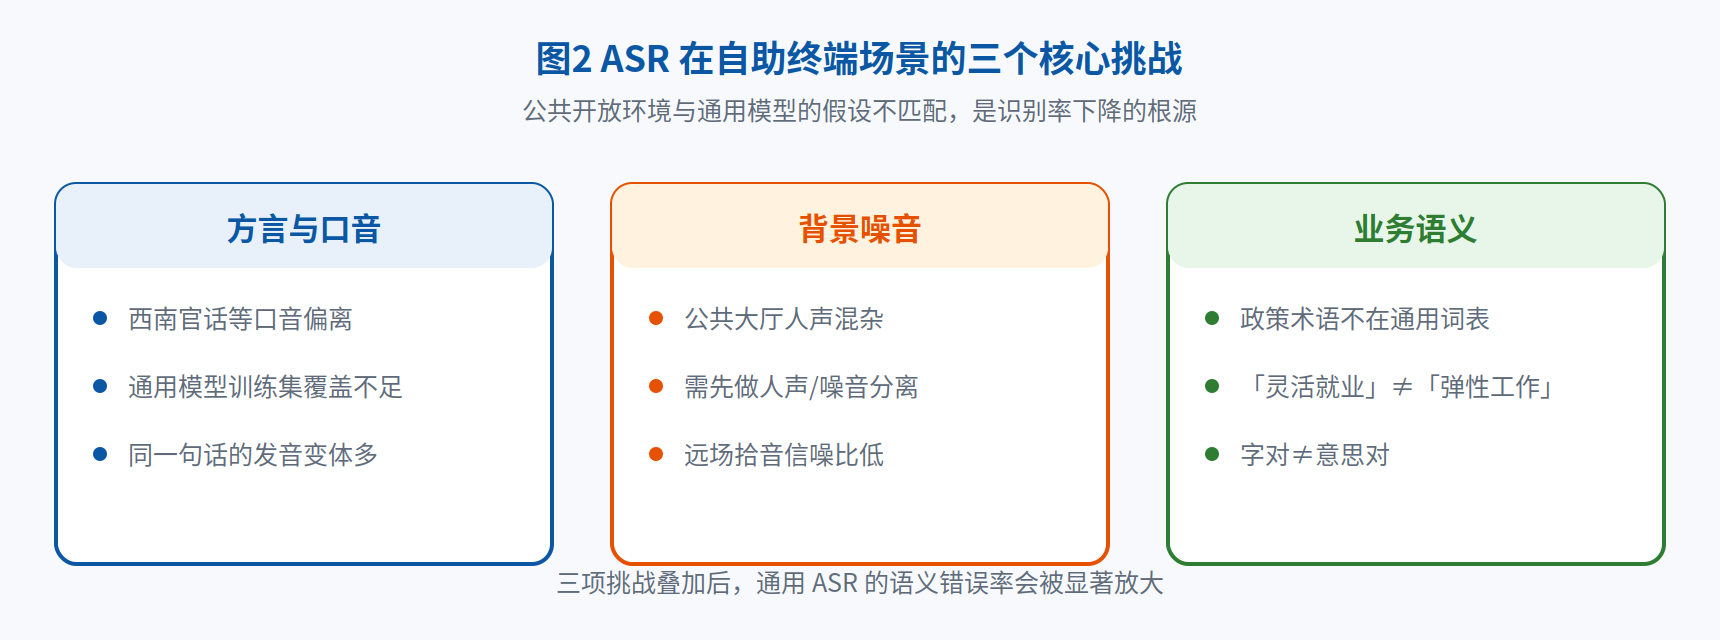
图2 ASR在自助终端场景的三个核心挑战
1.1 评测:用语义错误率替代字错误率
这里有一个关键决策:评测的核心指标不采用行业通用的字错误率(CER),而采用语义错误率。
原因很直接:在政务咨询场景中,用户更关心语义是否正确,而非字面是否完全一致。例如用户说“我想问下灵活就业的补贴”,ASR转成“灵汽就业的补贴”,字错了两个字,但后续语言模型结合上下文大概率仍能正确理解意图——字错误率会惩罚这个样本,但业务上它是可接受的;反过来,字面全对但把“失业金”听成“事业金”的语义错误,才是真正致命的。
1.2 技术方案:从通用ASR到场景化优化
通用ASR模型的训练假设与政务大厅的真实声学环境并不匹配,必须做针对性改造。优化围绕三条线展开:
噪音人声分离——VAD模型升级。将传统方案使用的WebRTC-VAD升级为Silero-VAD。WebRTC-VAD基于能量阈值判断,在人声嘈杂的大厅环境中容易误判;Silero-VAD基于神经网络,对“这是人声还是噪音”的区分能力明显更强,为后续识别提供了更干净的输入。
带口音语音识别——专用声学模型。针对开放环境中的口音语音,训练专用声学模型。口音问题无法靠通用模型“硬扛”,用真实口音数据做针对性训练是当前性价比最高的路径。
业务语义理解——上下文自适应+领域热词。结合对话历史动态调整语言模型输出;同时建立领域热词库,把“灵活就业”“创业担保贷款”这类政策术语注入识别词表。热词库依靠运营持续扩充:定期对线上ASR转译结果进行标注质检,收集、添加业务热词。
1.3 ASR的下一站:从“听懂”到“理解”
当前ASR仍存在长尾问题,后续优化方向包括三项:
个性化声学建模:学习特定区域用户的发音习惯,降低持续交互中的错误率;
情感识别融合:从语音中识别用户情绪(如不耐烦),动态调整交互策略;
方言/口音适配:在通用中文模型基础上,加入方言/口音数据训练。
ASR是拟人化交互的“地基”。在客服场景中,单纯追求字准确率并不够,必须紧密结合业务语义与用户体验——只有让AI真正“听懂人话”,降本增效才有前提。
二、智能打断:让交互不再“机械礼貌”
在真人对话中,打断和插话是最自然的交流行为。但在传统语音交互中,用户一说话AI就闭嘴或继续播报,这种“机械礼貌”是拟人化的最大障碍之一。
2.1 三大抢话场景
根据对真实环境中近3000个会话进行统计,将智能打断问题归纳为三类抢话场景:
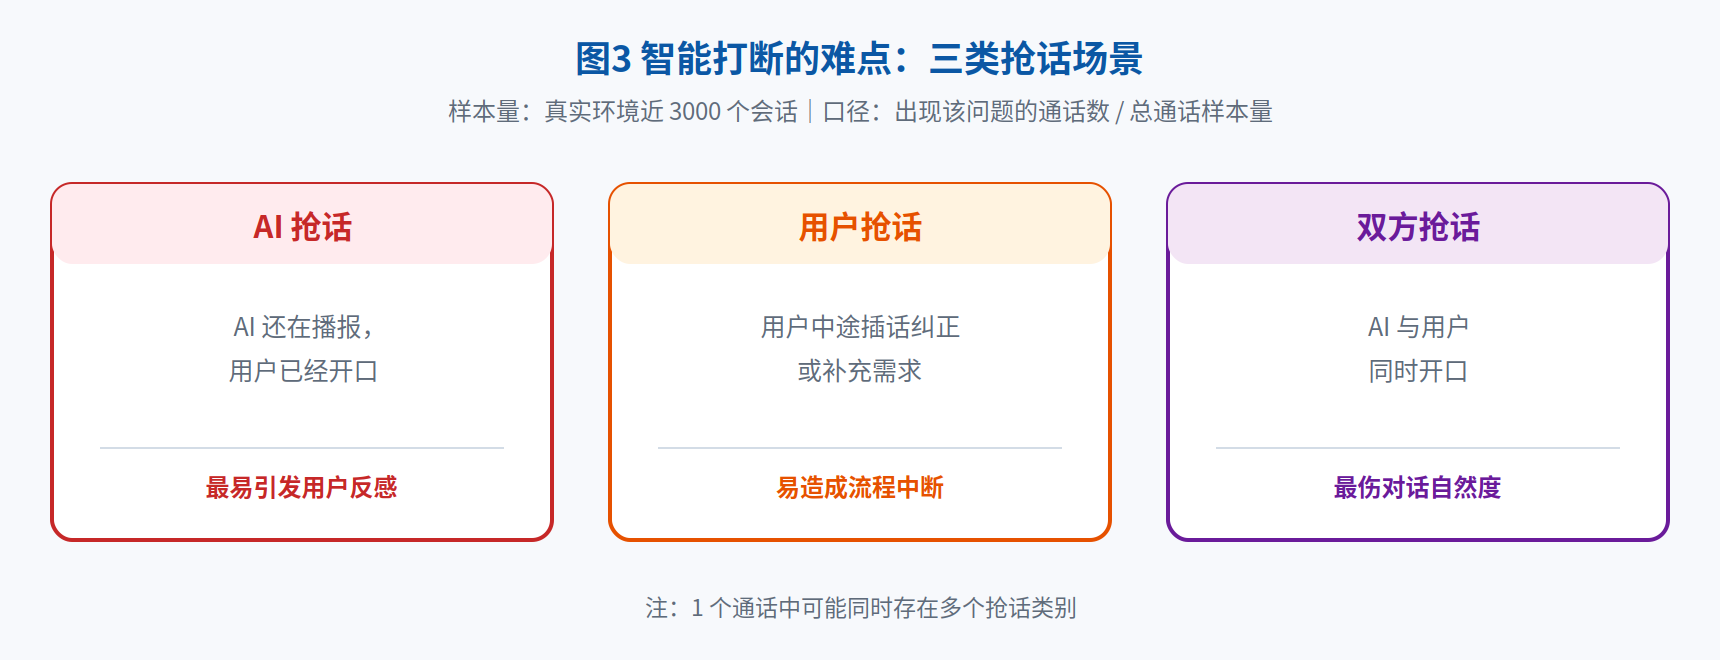
图3 智能打断的难点:三类抢话场景
在自助终端场景中,抢话问题的业务伤害是倍增的:
信息丢失:AI抢话可能导致未完整记录用户需求,造成后续服务错误;
流程中断:一次抢话可能导致整个自动化流程(如信息收集)中断,需要重新收集信息。
2.2 AI抢话:VAD无条件让路
核心机制:第一优先级中断。只要检测到用户语音活动(VAD激活),系统无条件禁止AI数字人播报,从机制上杜绝AI打断用户的可能性。
模型优化:VAD由WebRTC-VAD升级为Silero-VAD,提升嘈杂环境下“用户是否开口”的检出灵敏度。
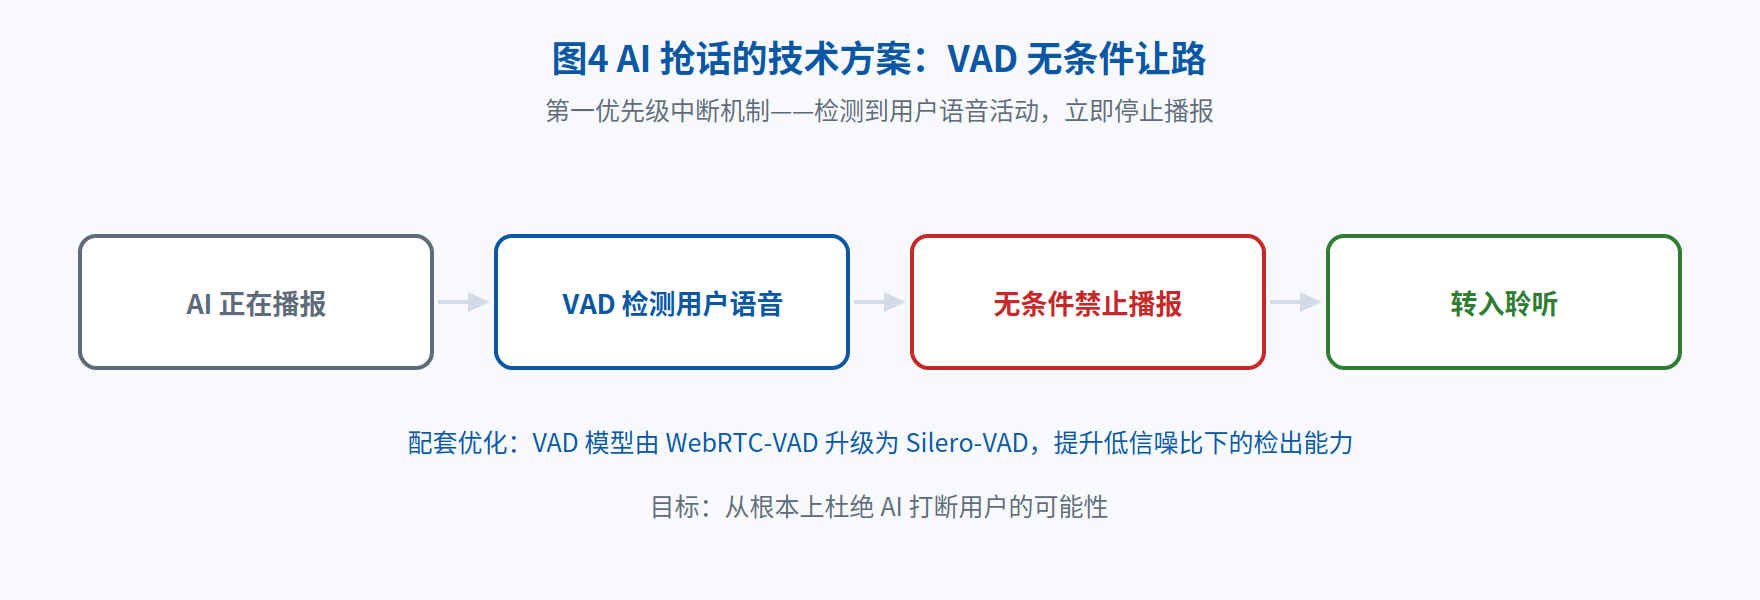
图4 AI抢话的技术方案:VAD无条件让路
2.3 用户抢话:三级过滤规则
用户中途插话时,系统需要判断“这次插话是真的想让AI停下,还是无意义的语气词”。这里刻意没有采用复杂的语义理解模型,而是用关键词规则——原因是ASR流式输出的片段文本语义不完整,语义模型难以在极短时间内做出可靠的意图判断,而规则引擎响应快、行为可解释、可运营。
具体规则分三级:
字数过滤:识别结果少于3个字(如“嗯”“啊”“对”),视为无效片段,不触发打断;
黑名单过滤:命中长度大于3字但无实际意义的表达(如“啊,你说你说”),不触发打断;
白名单触发:仅当识别片段命中关键指令词(如“停”“不是”)时,立即触发打断。
词库依靠持续运营:定期对用户抢话数据做标注质检,将新收集的表达归入黑/白名单。
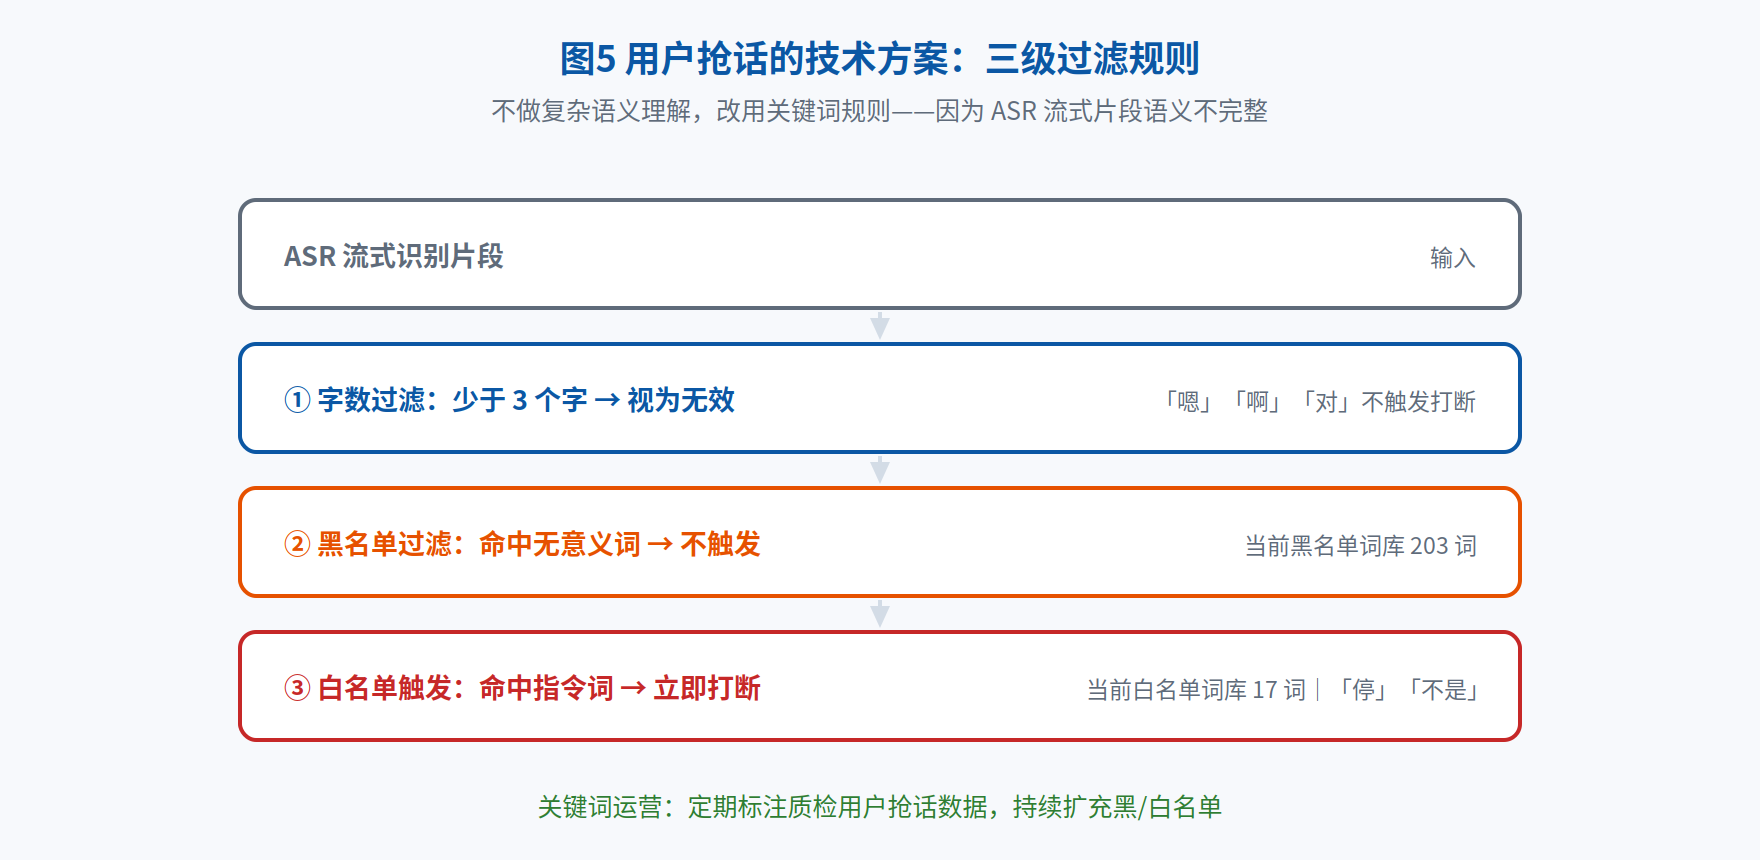
图5 用户抢话的技术方案:三级过滤规则
2.4 双方抢话:EOU轮次检测
最难处理的是AI与用户同时开口。核心机制:通过分析用户上一轮对话文本的语义,判断用户是否已表达完整。“自助易”AI数字人为此引入轮次检测(EOU)模型。
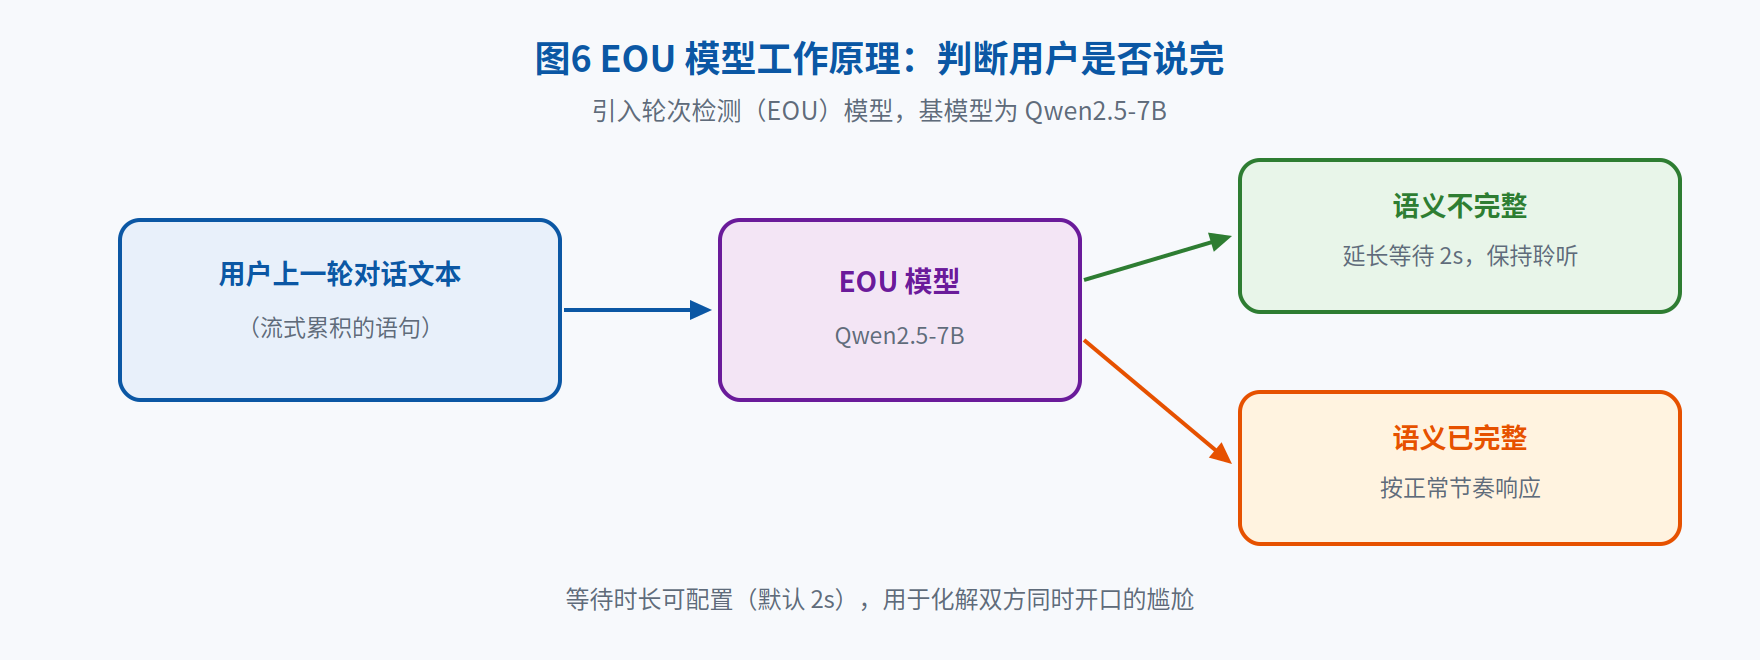
图6 EOU模型工作原理
应对策略按判断结果分流:若模型判断用户语义不完整,AI数字人主动延长等待时间(可配置,当前设为2秒),保持聆听,不争抢会话轮;若判断语义已完整,AI按正常节奏响应。
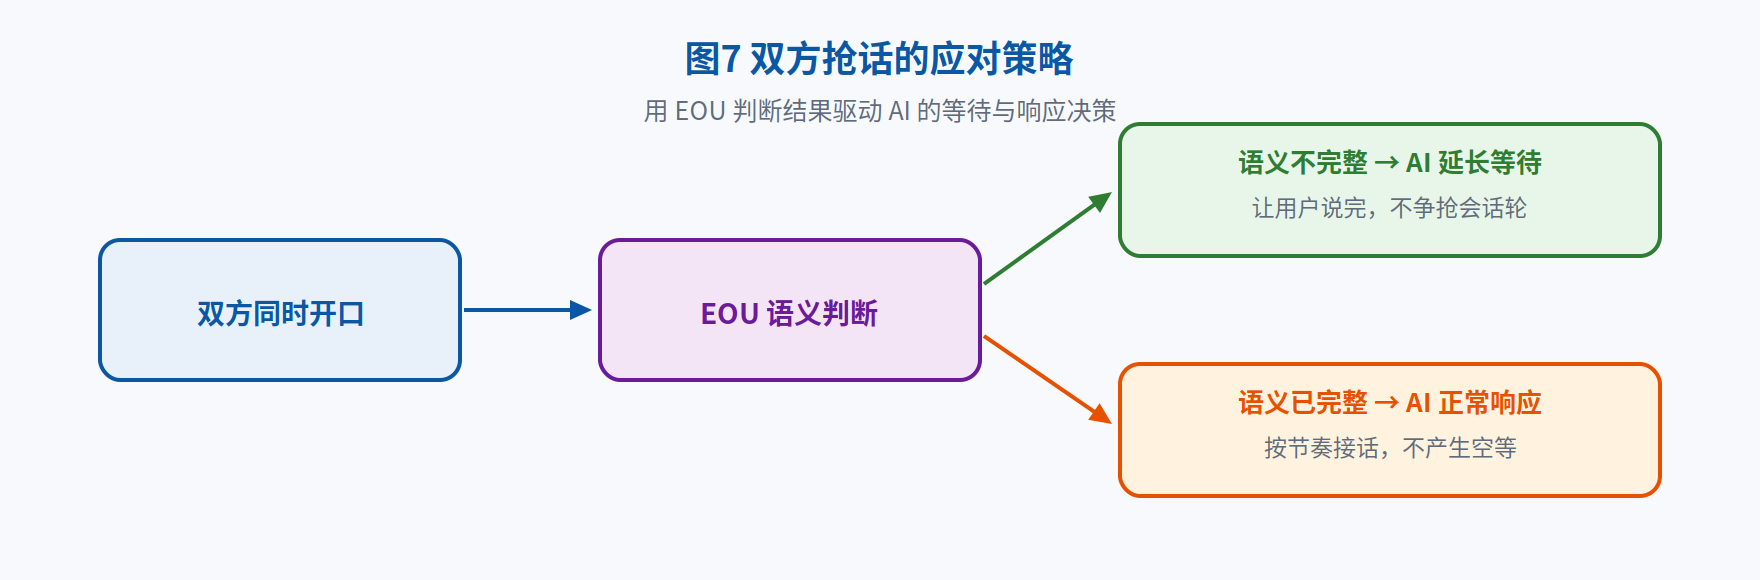
图7 双方抢话的应对策略
2.5 优化效果与判断
优化前后对同类数据做了标注对比,三类抢话问题的发生比例均有明显下降。
需要强调一个认知:实时打断不是一个简单的技术开关,而是信号处理、语音识别、自然语言理解、对话管理和用户体验设计的深度协同。当前的行业水平是从“不能打断”走向“可以但偶尔笨拙地打断”,下一阶段的突破依赖更强的端侧算力、更精准的轻量化模型,以及真正具有“对话意识”的AI——当机器能像真人一样感知对话的节奏、停顿和意图,并优雅地处理话轮交接时,无缝自然的“真”对话才会到来。
三、TTS:赋予AI数字人“人性化声线”
如果说ASR是AI数字人的“耳朵”,TTS就是“嘴巴”。TTS直接决定用户对AI的第一印象和情感信任——冰冷机械的电子音会立刻暴露机器身份,无论对话逻辑多智能,体验都会大打折扣。
3.1 评测:MOS之外的两个自建指标
评价指标在行业通用的MOS(Mean Opinion Score,主观质量平均分)之外,新增两项:
真人程度:判断合成语音能否被轻易识别为AI——这是用户对数字人建立情感信任的前提;
响应速度:自助终端场景的硬要求,响应过慢会带来明显的对话断裂感。
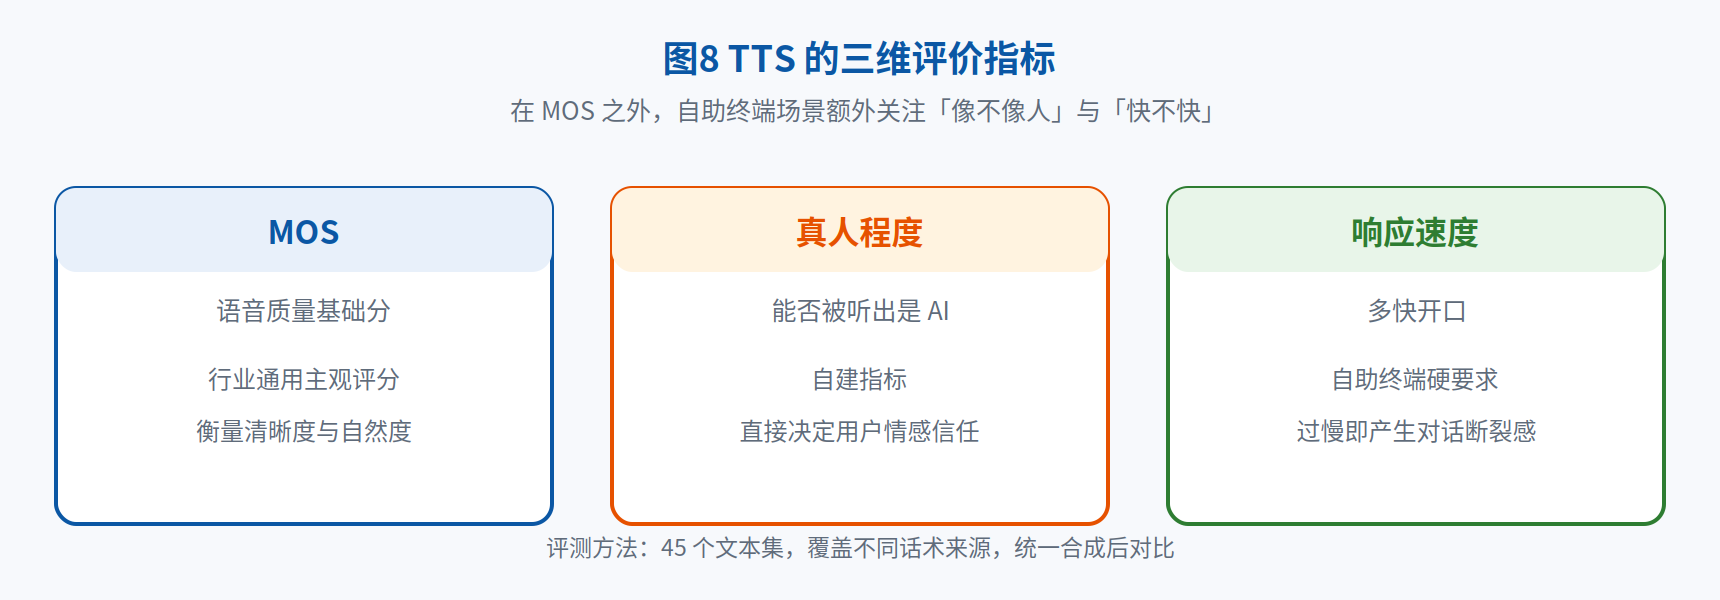
图8 TTS的三维评价指标
3.2 技术方案:从通用TTS到场景化优化
优化从四个方向展开:
韵律与情感控制。韵律上,动态调整语调和连读变调,优化停顿与重音,让语音更自然;情感上,从文本中提取情感特征作为模型输入,增强语音的情感表达。
音色定制。少样本克隆:仅用3-10秒目标说话人音频即可克隆音色;音色筛选:从300位人工客服录音中人工听音标注,挑选出5个最适合政务客服场景的音色。政务场景对音色有特殊要求——既要有亲和力,又要传达专业感与可信度。
读音歧义消除。通过文本标准化,将不规范输入(多音字、缩略语、数字串)清洗为标准读音格式,避免“长itution”式的低级读音错误。
流式生成与低延迟优化。采用Chunk-Based流式生成,边生成边播放,保证实时交互的响应速度。
3.3 未来方向:超越“像人”
当前TTS的目标是无限逼近真人,下一阶段的竞争点在“超越真人”:
动态情感自适应:根据用户实时情绪动态调整回应话术和情感语调,实现共情;
跨语种音色迁移:同一音色既说普通话又说地方方言,贴近本地群众需求;
声音身份:为用户或企业生成独一无二、可验证的专属声音身份。
TTS是拟人化交互的“最后一公里”。它已不是简单的“文本转读音”,而是融合语音学、心理学与品牌表达的综合工程。
四、技术融合:1+1+1>3的交互体验
单独的ASR、打断或TTS即使各自做到极致,也无法带来真正的拟人化体验。自然流畅源于三项技术的深度协同——它们构成一个完整的“听—思—说”闭环,任何一环的延迟或错误都会在链路上被放大。
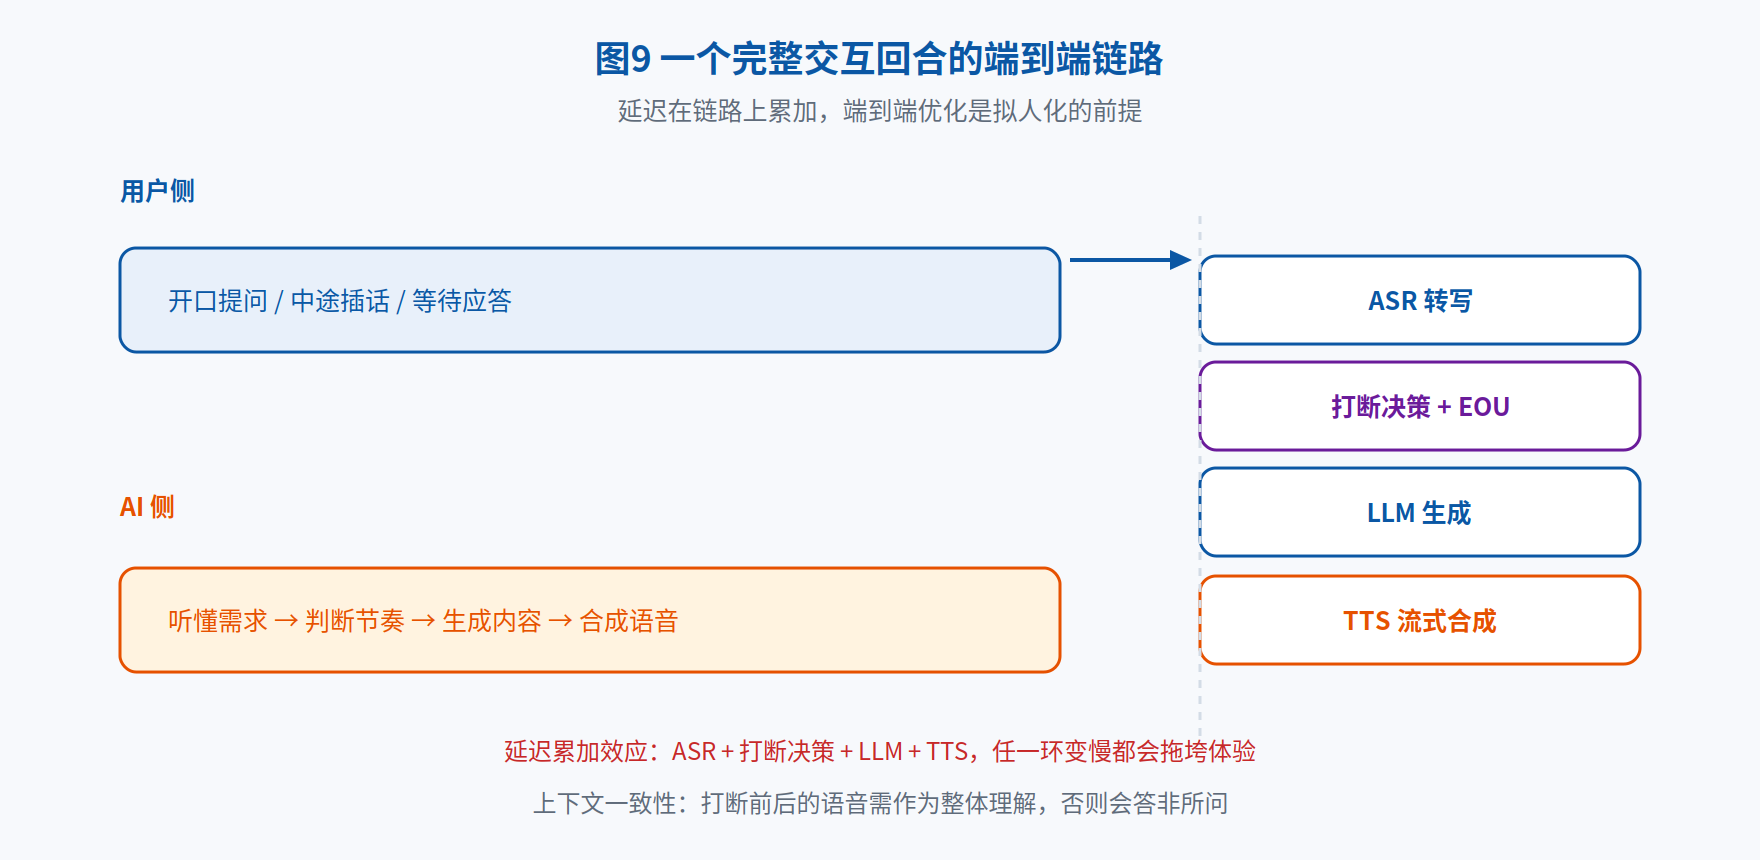
图9 一个完整交互回合的端到端链路
4.1 两个融合挑战
延迟累加效应。一次应答的总延迟 = ASR延迟 + 打断决策延迟 + LLM(大语言模型)延迟 + TTS生成延迟。任何一环变慢,整体响应都会被拖垮,必须做端到端优化,而不是各环节孤立调优。
上下文一致性断裂。用户打断后,ASR需要把打断前后的语音作为一个整体做上下文理解,LLM需要基于完整上下文生成回复——否则就会出现“打断一次,话题丢失”的答非所问。
4.2 总结与展望
三项语音技术环环相扣:ASR是“耳朵”,负责准确输入;实时打断是“大脑”,负责交互节奏;TTS是“嘴巴”,负责情感输出。唯有三者协同优化,才能打造真正拟人化、能降本增效的AI数字人语音服务。
目前,AI数字人拟人化语音交互已在自助终端领域落地应用,凭借情感化语音和智能互动能力有效提升服务效率。同时,端到端语音模型技术正在快速发展——它将语音识别、语义理解与语音合成无缝集成在一个模型内,大幅降低系统延迟与工程复杂度,实现更自然的全双工实时对话。
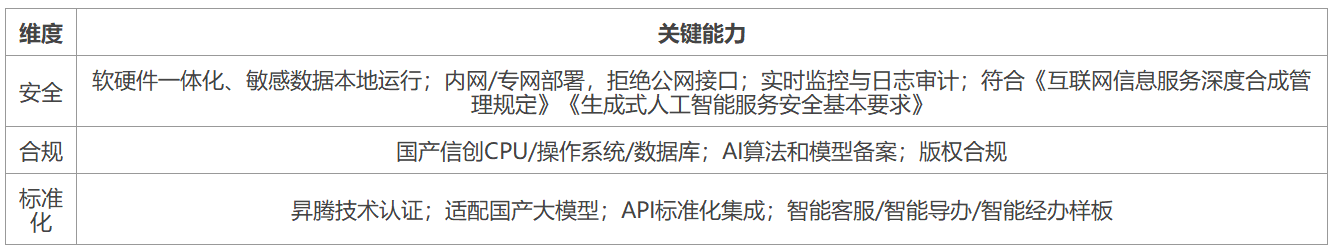
明泰智能「自助易」AI数字人主要部署在政务服务场景的公共设备上,在开放环境中“像人一样”与用户自然交流,提供对讲机语音输入、打电话畅聊等多种语音交互方式。同时,「自助易」AI数字人满足政务AI核心三要素——安全、合规和标准化:

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献91条内容

所有评论(0)