HarmonyOS 7 + Network Kit + WebSocket 项目复盘:实时协作看板的心跳保活、断线重连与消息补偿【鸿蒙心迹】
这次项目最初只是想做一个“多人同时改任务卡片”的协作看板。真正跑到弱网、切后台、Wi‑Fi/蜂窝网络切换之后,我才发现:WebSocket 能连上只是第一步,工程上真正难的是如何判断连接还活着、断线后怎么恢复、丢掉的消息怎么补回来,以及怎样避免同一条操作被重复执行。
一、需求很简单:三个人同时改一张看板
这个项目最开始没有多复杂。
我们做的是一个轻量协作看板。一个房间里通常两到五个人,大家可以同时做几件事:
- 新增任务卡片;
- 拖动卡片顺序;
- 修改标题和负责人;
- 添加评论;
- 看其他成员是否在线。
如果只在办公室稳定 Wi‑Fi 下测试,WebSocket 的体验几乎没有问题。客户端连上服务端,服务端把房间事件广播回来,页面收到消息以后更新状态,看起来就是一个很标准的实时通信功能。
问题出现在第二轮测试。
我把手机从 Wi‑Fi 切到移动网络,页面上仍然显示“在线”,但对端已经收不到我的操作。过十几秒再操作一次,本地卡片变了,服务端却没有记录。再等连接恢复,有时一口气又收到几条旧消息,顺序还不完全符合用户刚才看到的状态。
这时候我意识到,项目真正要解决的已经不是“WebSocket 怎么连接”,而是下面这四件事:
- 连接是否真的活着;
- 断开后什么时候重连;
- 断线期间发出的消息怎么办;
- 恢复后如何保证本地和服务端重新对齐。
后面整个项目的重构,基本都围绕这四个问题展开。
二、先把连接状态从一个 boolean 拆成状态机
第一版代码里,我只有一个 connected: boolean。
连接成功就是 true,close 或 error 就改成 false。这个写法在 Demo 阶段足够,但很快会暴露问题。
比如网络切换时,WebSocket 并不是立刻回调关闭;有时底层 TCP 已经不可达,页面还停留在“已连接”。如果只看一个 boolean,业务层根本分不清:
- 正在建立连接;
- 已连接但等待心跳确认;
- 已进入重连;
- 已恢复连接但正在补消息;
- 已完全同步。
所以我把状态拆成了五个阶段:
export enum SocketState {
  DISCONNECTED = 'DISCONNECTED',
  CONNECTING = 'CONNECTING',
  CONNECTED = 'CONNECTED',
  RECONNECTING = 'RECONNECTING',
  RECOVERING = 'RECOVERING'
}
这里 CONNECTED 只代表底层通道已经建立,真正恢复到业务可用状态,还要完成一次 ACK 游标同步和缺失消息补偿。
也就是说,“连接恢复”与“业务恢复”不是一回事。
这是这次项目里第一个很重要的调整。
三、心跳不是为了制造流量,而是为了尽快发现“假在线”
第二个问题是连接保活。
一开始我对心跳的理解比较机械:每隔一段时间发个 ping,服务端回个 pong。后来真正排查断线问题时,才发现它最有价值的地方不是“保活”,而是尽快确认这条连接是否仍然可用。
我们最终把心跳间隔定在一个相对温和的范围,同时维护最近一次 pong 时间。如果超过连续几个周期没有响应,就不再等待底层自己报错,而是主动进入重连流程。
核心结构大致是这样:
class ConnectionService {
  private heartbeatTimer: number = -1
  private lastPongAt: number = 0
  private heartbeatInterval: number = 15000
  private timeout: number = 45000

  startHeartbeat() {
    this.stopHeartbeat()
    this.heartbeatTimer = setInterval(() => {
      const now = Date.now()

      if (now - this.lastPongAt > this.timeout) {
        this.onConnectionLost('heartbeat timeout')
        return
      }

      this.sendControlMessage({
        type: 'ping',
        timestamp: now
      })
    }, this.heartbeatInterval)
  }
}
这里最关键的不是 15 秒或 45 秒这两个数字,而是心跳失败必须进入统一的连接丢失处理链路。
早期版本里,心跳超时、close 回调、发送失败分别处理,最后出现了多个地方同时发起重连的问题。后面我把它们全部收口到 onConnectionLost(),重连流程才真正稳定下来。
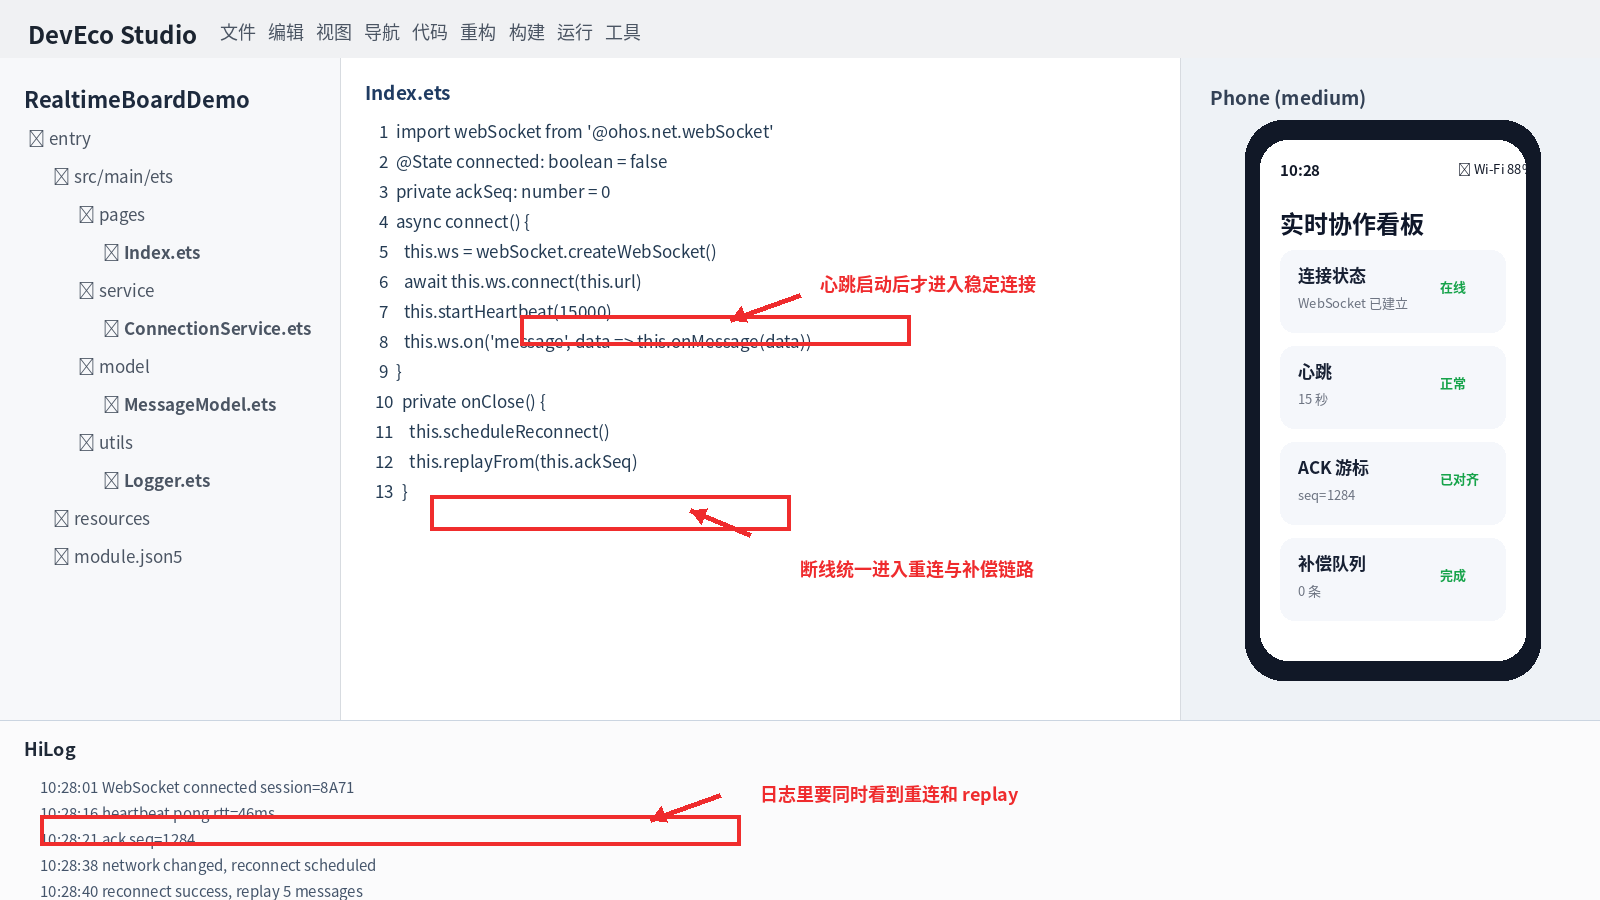
上面的 DevEco 图里,我专门把三个位置标了出来:心跳启动、断线后的统一恢复入口,以及底部重连和 replay 日志。做实时连接问题时,我现在更愿意看这种完整链路,而不是只盯“连接成功”一行日志。
四、重连真正麻烦的是:不能一断就疯狂连
第三个坑是重连节奏。
最初为了“恢复快”,我在连接断开后立刻重连。如果失败,再立刻重连。办公室网络测试没问题,弱网下一跑,日志像刷屏一样增长。
这种做法的问题有两个:
- 网络真的不可用时,大量无意义请求会持续消耗资源;
- 服务端短时抖动时,成百上千个客户端可能同时打回来,形成重连尖峰。
后来我们改成递增退避:
private reconnectDelays: number[] = [1000, 2000, 4000, 8000, 15000]
private reconnectIndex: number = 0

scheduleReconnect() {
  if (this.state === SocketState.RECONNECTING) {
    return
  }

  this.state = SocketState.RECONNECTING
  const delay = this.reconnectDelays[
    Math.min(this.reconnectIndex, this.reconnectDelays.length - 1)
  ]

  setTimeout(async () => {
    try {
      await this.connect()
      this.reconnectIndex = 0
      await this.startRecovery()
    } catch (_) {
      this.reconnectIndex++
      this.state = SocketState.DISCONNECTED
      this.scheduleReconnect()
    }
  }, delay)
}
这个调整带来的变化很明显:短抖动时恢复仍然很快,长时间断网时客户端也不会一直高频尝试。
而且这里有一个很容易漏掉的细节:connect 成功以后不能立刻把 UI 改回“全部正常”。
因为这时候只是物理连接回来了,断线期间缺的消息还没补。
五、我最后用 ACK 序号解决“我到底缺了哪几条消息”
做消息补偿之前,我们先给每条服务端事件加了单调递增的 seq。
客户端每成功消费一条事件,就更新 lastAckSeq。断线以后,本地会保留最后一个已经确认的序号。重新连接时,把这个序号发给服务端:
{
  "type": "resume",
  "sessionId": "8A71",
  "lastAckSeq": 1279
}
服务端知道客户端已经处理到 1279,就只需要返回 1280 以后缺失的事件。
这个机制不复杂,但一下解决了很多模糊问题。
以前我们问的是:
“刚才断线了,会不会丢消息?”
做完 ACK 游标以后,问题变成:
“客户端最后确认到 1279,服务端当前是 1284,那就补 5 条。”
一旦问题可以量化,排查难度会下降很多。
六、断线期间的本地操作,不能直接当成“已经成功”
还有一个很现实的问题:用户断网的时候仍然会继续操作。
比如他把任务从“待处理”拖到“进行中”,页面当然不能直接卡死。于是第一版我们做了乐观更新:先改 UI,后台再发 WebSocket 消息。
问题是如果消息没发出去,用户看到的是“已经改了”,服务端却完全不知道。
所以后来我们给本地操作加了 clientOperationId 和发送状态:
interface PendingOperation {
  operationId: string
  localSeq: number
  payload: BoardOperation
  status: 'PENDING' | 'SENT' | 'ACKED' | 'FAILED'
}
UI 可以先变化,但这条操作会进入 pending 队列。收到服务端 ACK 后才变成 ACKED。如果断线,就保留在本地,连接恢复后按顺序重新发送。
为了避免重复执行,服务端也要根据 operationId 做幂等判断。
这一步做完,用户体验和数据可靠性才真正兼顾起来。
七、我后来做了一个“连接诊断页”,问题一下好查很多
到了第三轮测试,我发现单靠日志还是太慢。
于是干脆把几个关键状态做成了一个开发诊断页:
- 当前 Session;
- 当前 WebSocket 状态;
- 心跳间隔;
- 超时阈值;
- 当前 ACK 序号;
- 服务端最新序号;
- 补偿窗口;
- 最近重连记录。
正常使用时它可以隐藏,开发和测试阶段打开以后非常有用。
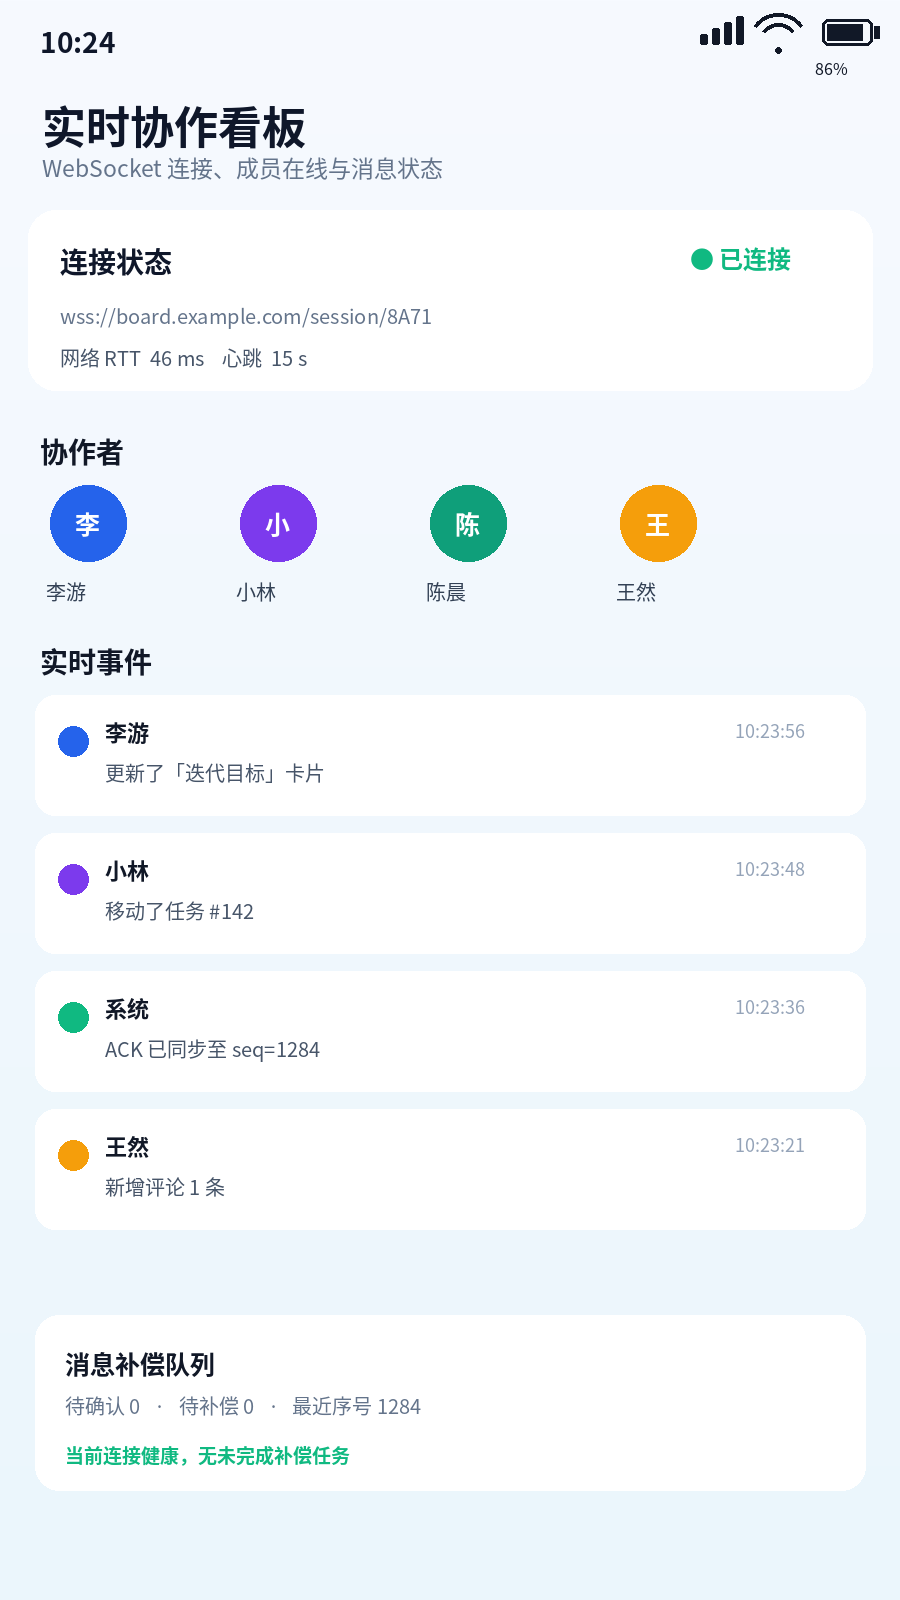
这张图展示的是正常状态。连接建立以后,成员、实时事件、ACK 游标和补偿队列都在一个页面里。现在我判断“连接正常”,已经不是看一个绿色圆点,而是看这几个状态是否同时成立。
真正断网再恢复时,诊断页会更有价值。
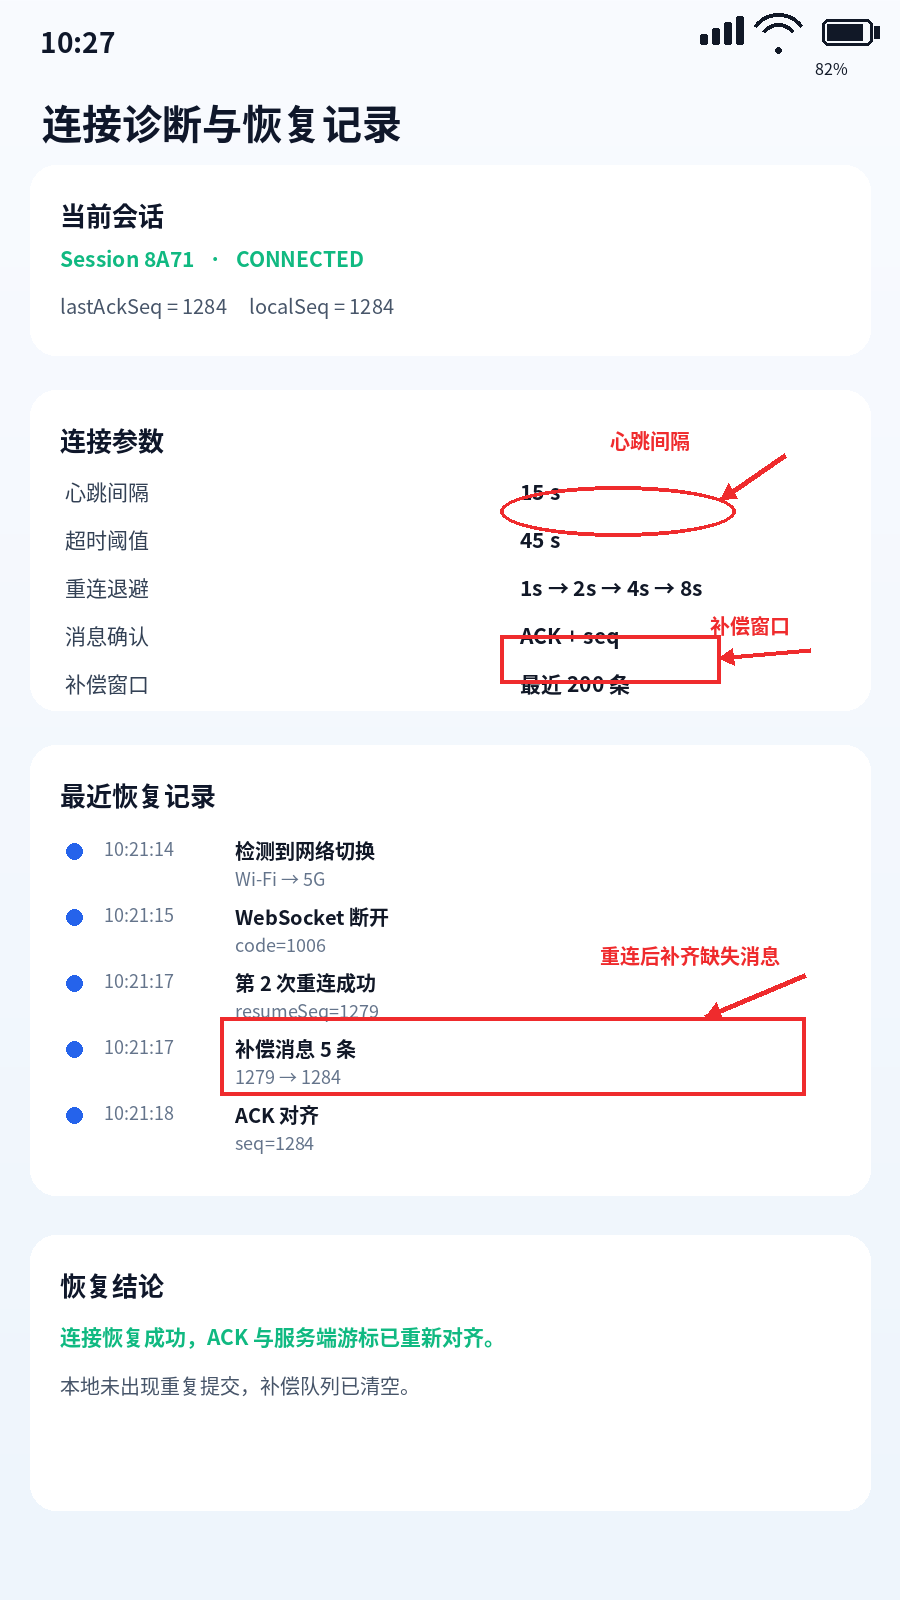
这里我把三个容易被忽略的位置用红色标出来:心跳周期、补偿窗口和重连后补齐消息的记录。尤其是最后一个,如果只看到“WebSocket reconnect success”,其实还不能证明业务已经恢复;必须确认 ACK 与 replay 已经重新对齐。
八、最终验收,我不再只测“能不能聊天”
项目快结束时,我们重新整理了一套验收场景。
以前测试用例基本是:A 改卡片,B 能看到,就算成功。
后来变成:
- 稳定网络下连续操作 30 分钟;
- Wi‑Fi 切 5G 后继续操作;
- 关闭网络 20 秒再恢复;
- 应用进入后台再回前台;
- 重连过程中快速修改多张卡片;
- 反复断网,检查重复消息;
- 重连后校验 ACK 游标与服务端一致;
- 本地 pending 队列必须最终清空。
这些用例看起来比“实时同步是否成功”复杂很多,但它们才是真实项目里的稳定性标准。
九、这次项目复盘,我最后留下的不是一套 WebSocket 代码
这次项目做完以后,我最大的变化,是对“实时连接”这件事的判断方式变了。
以前我会问:
WebSocket 连接成功了吗?
现在我更愿意问:
连接是不是可确认地活着?断线能不能受控恢复?断线期间的操作有没有保存?恢复后状态能不能重新收敛?
真正能上线的实时功能,不是一个 connect(),而是一套完整的状态治理:
连接 → 心跳 → 失活检测 → 退避重连 → 游标恢复 → 消息补偿 → ACK 对齐 → pending 清空。
这套链路一旦走通,后面无论做实时聊天、设备状态、协同编辑还是业务事件订阅,都能复用相同的工程思路。
这也是我这次项目最值得留下来的东西。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)