HarmonyOS 7 + Request Kit + Background Tasks Kit 实战:多附件上传中心的断点续传、失败重试与队列调度【鸿蒙心迹】
这篇文章,我不想只讲“上传功能怎么做出来”,而是把我这次做多附件上传中心时,真正踩到的工程边界梳理清楚:为什么单个上传接口一旦遇到后台切换、网络抖动、超大文件,就会很快失控;以及我最后是怎么把断点续传、失败重试、并发队列和后台调度收成一套能上线的结构。
一、最开始的问题,不是上传失败,而是上传逻辑太“直”了
我最早做这个页面时,想法其实特别直接:用户选文件,点上传,Request Kit 发请求,成功了就改状态,失败了就弹提示。
刚跑 Demo 的时候,这套逻辑看起来没什么问题。
可一旦把场景从“上传一个 3MB 图片”换成“连续上传 5 个附件,其中还混着 1GB 的视频、几十 MB 的文档、网络中途断一下、用户切到后台再回来”,问题马上就全出来了:
- 文件一多,多个任务互相抢占;
- 某个大文件失败以后,整个队列状态会被拖乱;
- 页面退出再回来,任务状态不连续;
- 网络恢复以后,不知道该从头传,还是从上次分片继续;
- 某个任务一直失败,会不会把剩下所有任务都卡住;
- 用户看到“失败”两个字,但根本不知道失败在哪一段。
也就是说,表面看是“上传中心”,本质上已经不是一个按钮功能了,而是一套任务调度系统。
二、我后来先把任务拆成了“状态机”,页面才开始好维护
如果上传任务只有“成功”和“失败”两个状态,这种功能几乎一定会越写越乱。
因为真实业务里,一个上传任务至少会经历这些阶段:
WAITING:已经入队,等待执行;UPLOADING:正在上传;PAUSED:手动暂停或网络暂时不可用;RETRYING:发生异常,进入自动重试;FAILED:超过重试上限,正式失败;SUCCESS:上传完成。
我后面把每个文件都抽成一条 UploadTask,里面除了文件信息,还会记录:
- 当前状态;
- 当前进度;
- 已上传分片数;
- 失败次数;
- 最大重试次数;
- 最近错误信息;
- 本地断点位置。
这样做最大的变化是:页面不再凭感觉拼 UI,而是完全跟着任务状态走。
最基础的一版任务模型,我最后收成了下面这种结构:
export enum UploadStatus {
  WAITING = 'WAITING',
  UPLOADING = 'UPLOADING',
  PAUSED = 'PAUSED',
  RETRYING = 'RETRYING',
  FAILED = 'FAILED',
  SUCCESS = 'SUCCESS'
}

export interface UploadTask {
  id: string
  filePath: string
  fileName: string
  fileSize: number
  chunkSize: number
  uploadedChunk: number
  totalChunk: number
  progress: number
  retryCount: number
  maxRetry: number
  status: UploadStatus
  errorMessage?: string
}
这段代码看起来只是多了几个字段,但它解决的是一个更底层的问题:上传任务终于有了统一的生命周期。
三、真正让我稳下来的,不是接口,而是“上传队列”
一开始我也试过最省事的做法:用户选了几个文件,就起几个并发上传。
结果非常快,问题就来了。
大文件占住带宽,小文件一直排队;网络一差,多个任务同时重试;页面上明明只坏了一项,但用户看到的却像全部都卡住了。
后来我就不再让页面直接发请求,而是加了一层 UploadManager。这层只做三件事:
- 维护任务队列;
- 控制最大并发数;
- 统一管理重试和状态回调。
也就是说,页面负责“发起上传”,真正执行上传的是队列管理器。
我最后保留的核心逻辑大概是这样:
class UploadManager {
  private queue: UploadTask[] = []
  private runningCount: number = 0
  private maxConcurrent: number = 3

  addTask(task: UploadTask) {
    this.queue.push(task)
    this.schedule()
  }

  private schedule() {
    while (this.runningCount < this.maxConcurrent) {
      const nextTask = this.queue.find(item => item.status === UploadStatus.WAITING)
      if (!nextTask) {
        break
      }
      this.runningCount += 1
      nextTask.status = UploadStatus.UPLOADING
      this.uploadTask(nextTask).finally(() => {
        this.runningCount -= 1
        this.schedule()
      })
    }
  }
}
这里最关键的,不是 while 这几行,而是思路变了:
- 上传不是页面事件,而是队列事件;
- 页面点击“上传”,只是在往队列里塞任务;
- 调度权在管理器手里,不在按钮手里。
这一点想通以后,很多以前很乱的问题,一下就有了归宿。
四、断点续传不是一个按钮,而是一段“已上传分片”的记录
真正让我觉得这个功能像样起来的,是把断点续传补完整。
用户看到的只是“继续上传”四个字,但工程上它背后至少要回答三件事:
- 已经传到哪个分片了;
- 下次恢复时从哪里接着走;
- 失败后重试,是重试当前分片还是重试整个文件。
我最后没有做整文件一次性上传,而是把大文件按分片处理。每个分片完成以后,立即更新:
uploadedChunkprogresslastCallbackTime- 本地持久化断点位置
这样做的好处非常直接:如果第 385 个分片超时,恢复时就不必从第 1 个分片重新开始,而是从 384 的下一个位置继续。
这也是为什么在上传详情页里,我刻意把“总分片数”“断点位置”“重试次数”“最后回调时间”都显式展示出来。
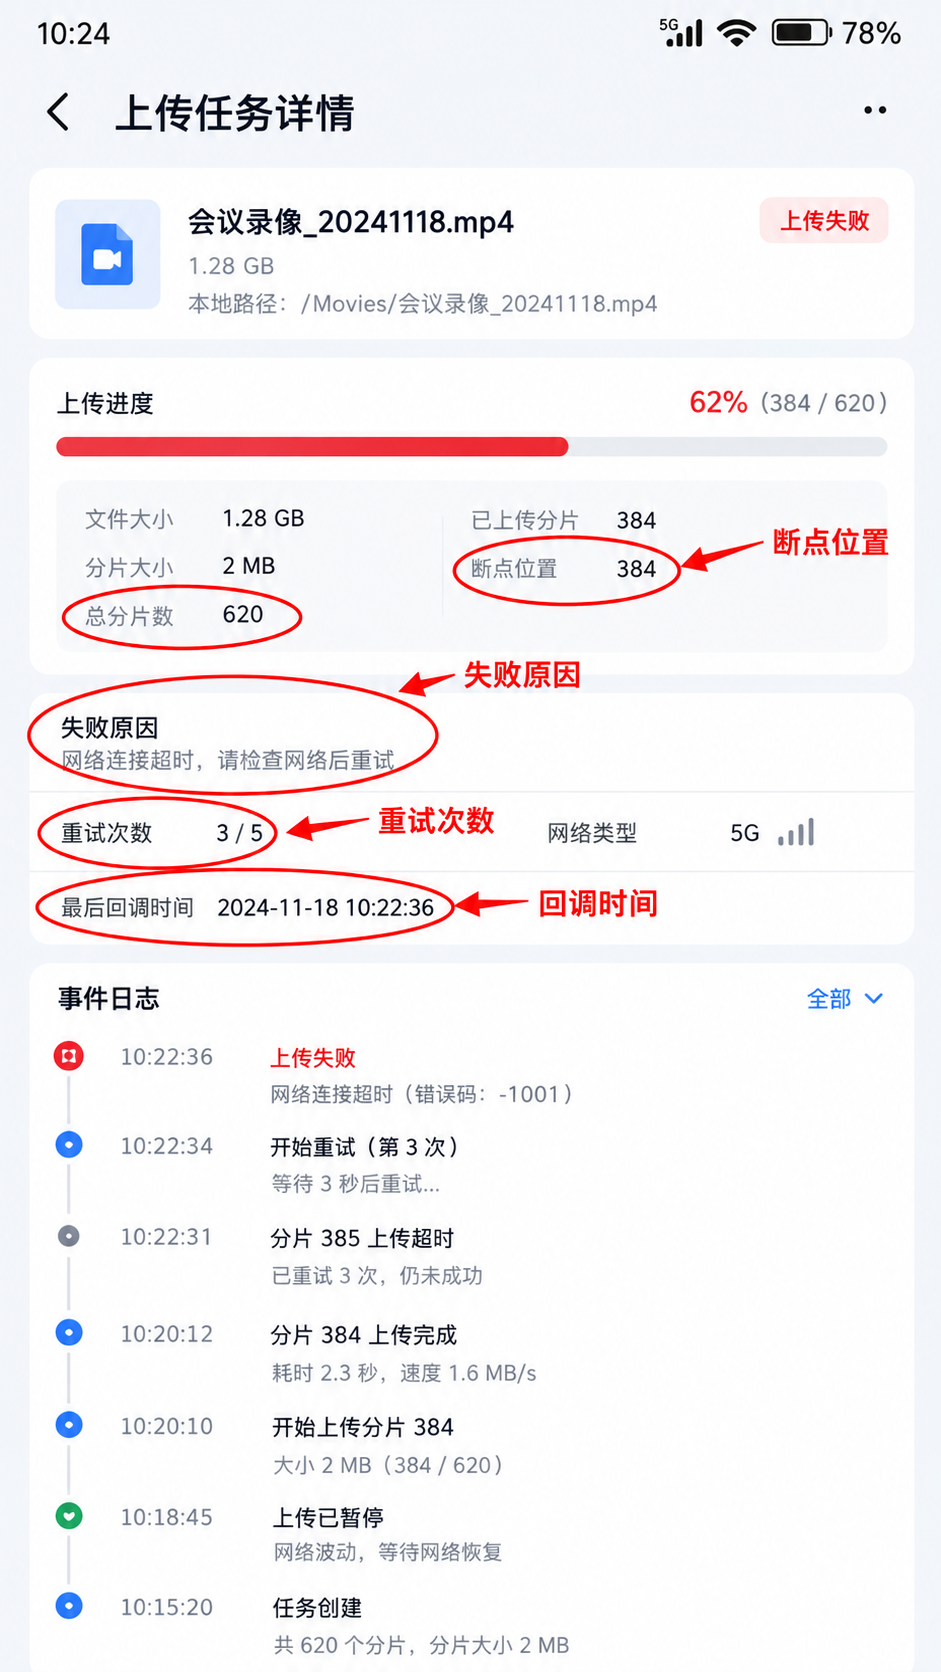
你看这张图,其实就是在讲这套链路的几个关键证据:
- 红圈标出的“总分片数”和“断点位置”,告诉我们恢复到底从哪一段开始;
- “失败原因”不是一句泛泛提示,而是具体到网络超时;
- “重试次数”和“最后回调时间”能让排查不再停留在猜测层面。
很多上传功能看起来也有失败页,但如果没有这些字段,开发者很难判断问题到底卡在哪一步。
五、自动重试真正难的,不是“重试一下”,而是别把队列拖崩
自动重试听起来像一句话,真正落地时却很讲分寸。
如果所有失败都立刻重试:
- 网络一抖,整个队列会同时重试;
- 某个必然失败的任务会反复耗资源;
- 用户会觉得页面一直在转,但又不知道什么时候结束。
所以我最后给重试定了三条规则:
- 只对可恢复错误重试,例如网络超时、瞬时连接失败;
- 限制最大重试次数,超过上限进入
FAILED; - 重试前做延迟退避,避免多个任务瞬间同时重试。
比如第 1 次重试等 2 秒,第 2 次等 4 秒,第 3 次等 8 秒。这样一来,网络刚刚恢复时,队列不会一下子全部撞上去。
页面上我也把这件事讲清楚了:失败任务不是彻底结束,而是会先进入“可重试”的状态,再决定是系统自动兜底,还是用户手动触发。
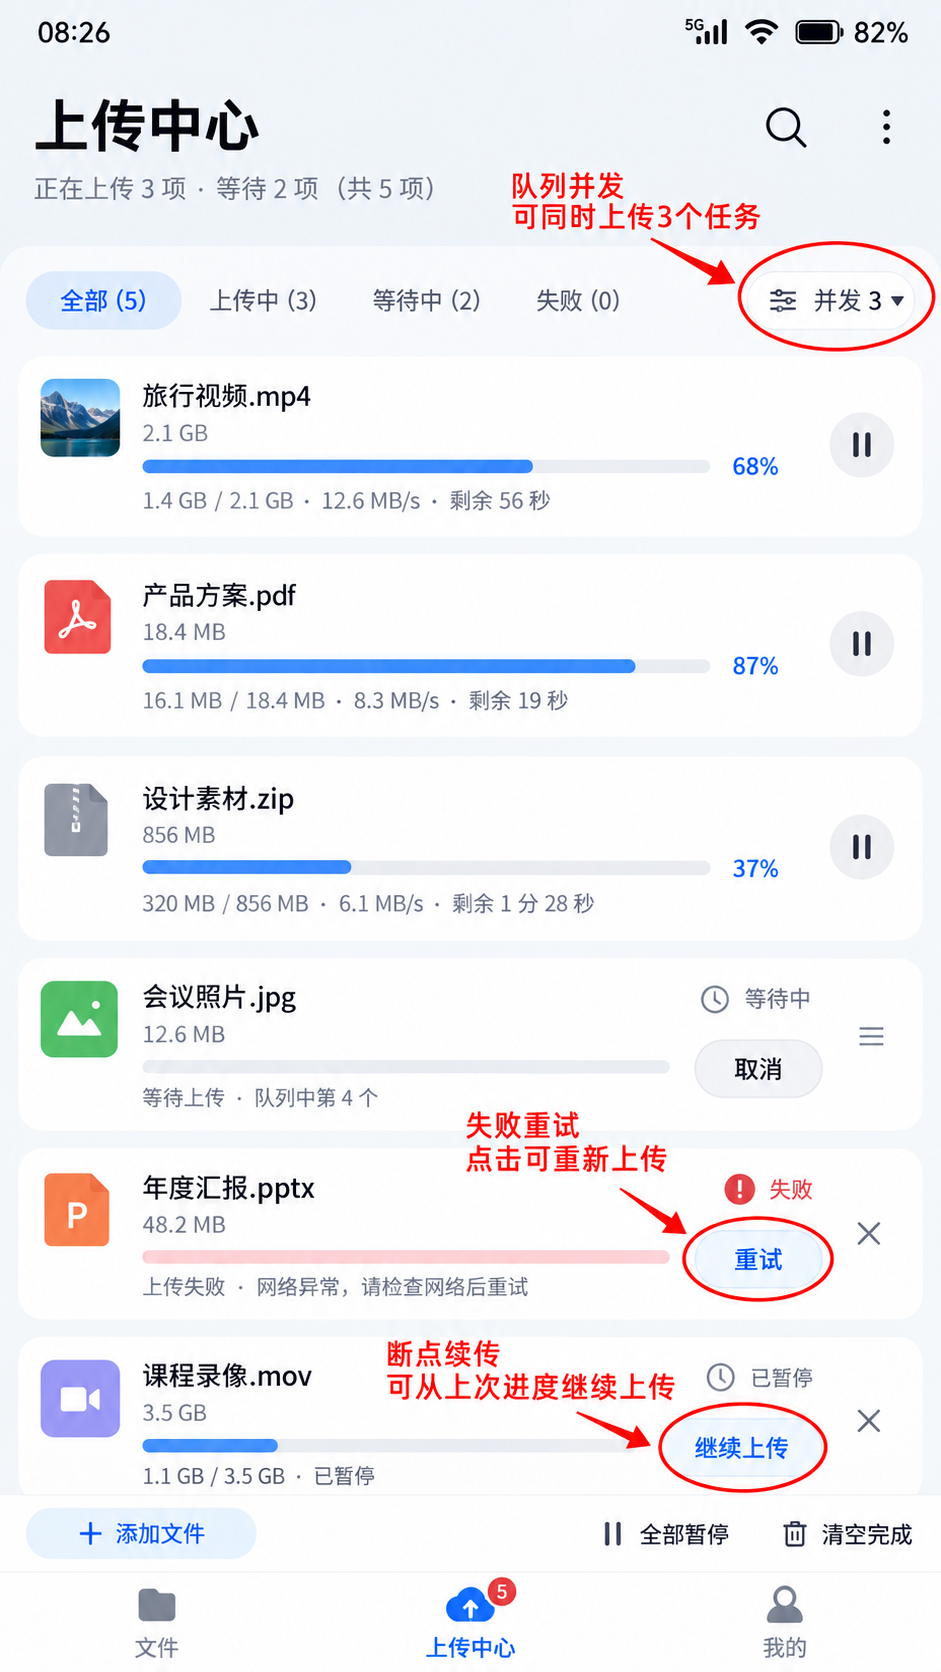
这张图里红色标注圈出来的点,其实刚好就是用户最关心、开发者也最该先排查的几个位置:
- “并发 3” 对应的是队列调度能力;
- “重试”按钮对应失败任务的人工接管入口;
- “继续上传”对应断点续传能力。
读者看一眼就能理解:这不是一个简单的文件列表,而是一套带调度、带恢复、带失败兜底的上传中心。
六、后台切走以后还能继续,是因为我把后台任务和上传链路接在了一起
多附件上传真正的考题,很多时候不是前台,而是后台。
因为用户上传视频、压缩包这类大文件时,几乎不可能一直盯着页面看。他切出去回消息、查文档、锁屏,都是很正常的操作。
如果这时候上传能力完全依赖当前页面生命周期,用户体验一定很差。
所以我后面又补上了 Background Tasks Kit 的调度逻辑,让上传任务在应用退到后台后,仍然能维持可控执行。
在工程结构上,我没有把后台任务另写成一套上传逻辑,而是只让后台能力负责“保活与调度”,真正的任务状态还是统一落在 UploadManager 上。
也就是说:
- 前台和后台,不是两套上传系统;
- 它们共享同一套任务队列;
- 后台只是改变任务执行时机,而不改变任务模型。
这个收法很重要。否则很容易出现前台一个状态、后台一个状态、页面回来又对不上的情况。
七、整个工程为什么能稳下来,我觉得关键不是某个 API,而是“证据可见”
后面我回头看这次实战,真正让我满意的不是“上传成功率提高了”,而是整个系统开始有了可解释性。
比如在 DevEco 的开发视角里,我会同时看三块东西:
- 左边项目结构里,页面、管理器、后台任务是不是分层清楚;
- 中间代码里,队列状态、重试入口、后台调度是不是收口在少数几个方法里;
- 底部日志里,任务回调、重试日志、队列状态是不是连续可追踪。
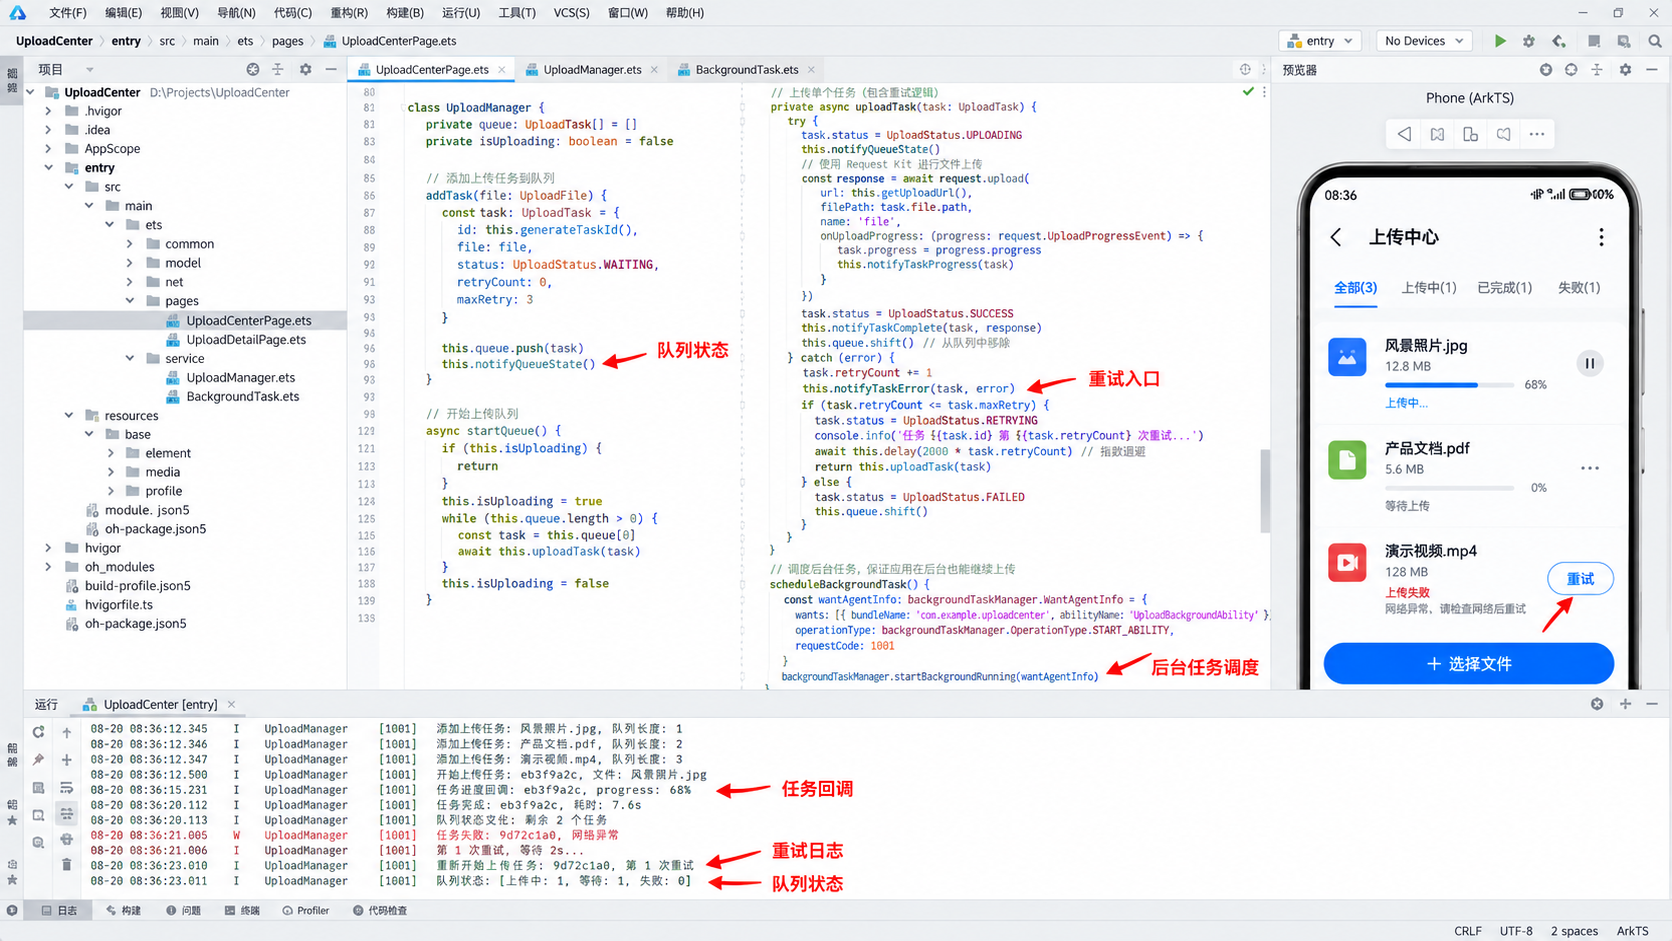
这张图对我来说就很像这次工程的缩影:
- 红色箭头标注“队列状态”,说明上传中心不再是散点逻辑;
- “重试入口”说明错误恢复是有结构的;
- “后台任务调度”说明页面生命周期之外,任务还能被系统托住;
- 底部日志把“回调—重试—队列状态”串成了一条完整证据链。
这也是我这次最强烈的体会:上传功能一旦进入工程化阶段,最值钱的不是单次成功,而是状态可见、过程可追。
八、本文小记
如果让我用一句话总结这次实战,我会写成:多附件上传中心的难点,不在“传”,而在“调度”。
真正决定体验的,从来不是那个“选择文件”按钮,而是:
- 队列是不是稳;
- 分片是不是能续;
- 失败是不是能判;
- 重试是不是有边界;
- 后台是不是还能接着跑。
对我自己来说,这次做完以后,有几个判断基本算是固定下来了:
- 任务一定要先抽成状态机;
- 上传一定要收进队列管理器;
- 断点续传一定要落到可持久化的分片进度上;
- 自动重试一定要有错误类型和次数边界;
- 后台调度一定要和前台任务共用一套状态来源。
如果你现在也在做 HarmonyOS 的文件上传类功能,我的建议不是“先把上传接口接上”,而是先想清楚:你的上传中心,究竟只是一个页面,还是一套任务系统。
想清楚这一点,后面的工程结构会完全不一样。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)