HarmonyOS 7 + Rust-Node-API:图像哈希库的跨语言边界与崩溃隔离【鸿蒙心迹】
一、先看最终形态:ArkTS 不认识 Rust 指针
HashVault 是一个离线图片去重工具,输入一张 1024 × 768 的 RGBA 图片,调用 Rust 编写的感知哈希库,返回 64 位哈希。最终联调结果是:任务 HASH-20260930-024 在 arm64-v8a Release 构建中耗时 36 ms,结果为 a93f-71c2-4d88-b50e;故意传入短缓冲区时,页面收到结构化错误 ERR_NATIVE_BUFFER_RANGE,应用没有崩溃。
这个结果并不是把 Rust 函数直接暴露给 ArkTS 得到的。实际链路有三层:ArkTS 负责参数模型与页面状态;C++ Node-API 胶水负责读取 ArrayBuffer、检查类型并创建返回对象;Rust 只接收 C ABI 能表达的指针、长度和整数,并把所有失败收敛成错误码。
这条边界看起来保守,却很实用。ArkTS 不应知道 Rust 的所有权和生命周期,Rust 也不应持有 napi_env 或 ArkTS 对象。中间层只做翻译,不承载算法。这样升级图像库、替换并发模型或定位崩溃时,每一层都有清楚的责任。
二、第一天:先固定接口契约,再接动态库
最初的接口是 hash(buffer): string。它的问题不是不能用,而是任何失败都只能抛异常字符串:尺寸错误、缓冲区不够、库未加载、算法内部 panic,全都混在一起。更麻烦的是,调用者忘了传宽高和像素步长,Native 侧只能猜测内存布局。
我们把契约改成 compute(request): HashResult。请求必须包含 jobId、width、height、stride 和像素缓冲区;结果必须包含状态、错误码、哈希、耗时和实际读取字节数。对本次图片,期望字节数严格等于 1024 × 768 × 4 = 3,145,728。
这段代码解决什么问题。 它在 ArkTS 入口完成可读的前置校验,并把 Native 返回值转换成页面可以稳定消费的领域结果。
import hashvault from 'libhashvault.so'

export interface HashRequest {
  jobId: string
  width: number
  height: number
  stride: number
  pixels: ArrayBuffer
}

export interface HashResult {
  jobId: string
  state: 'SUCCEEDED' | 'REJECTED'
  code: 'OK' | 'ERR_NATIVE_BUFFER_RANGE' | 'ERR_NATIVE_PANIC'
  hash: string
  elapsedMs: number
  consumedBytes: number
}

export class HashVaultAdapter {
  compute(request: HashRequest): HashResult {
    const expected = request.stride * request.height
    if (request.width <= 0 || request.height <= 0 ||
        request.stride < request.width * 4 || request.pixels.byteLength < expected) {
      return {
        jobId: request.jobId,
        state: 'REJECTED',
        code: 'ERR_NATIVE_BUFFER_RANGE',
        hash: '',
        elapsedMs: 0,
        consumedBytes: 0
      }
    }
    return hashvault.computeHash(request)
  }
}
前置校验不是为了取代 Native 校验,而是尽早给业务层可理解的反馈。跨语言边界必须“双方都不信任对方”:ArkTS 检查可以减少无意义调用,C++ 和 Rust 仍要重新验证指针与长度,防止未来其他入口绕过适配器。
stride 必须显式传递。很多图片并不是紧密排列,行尾可能有填充;若简单按 width × 4 递增,算法会从第二行开始读错位置。当前 Demo 的 stride=4096,恰好等于宽度乘四,但接口没有把这个偶然条件写死。
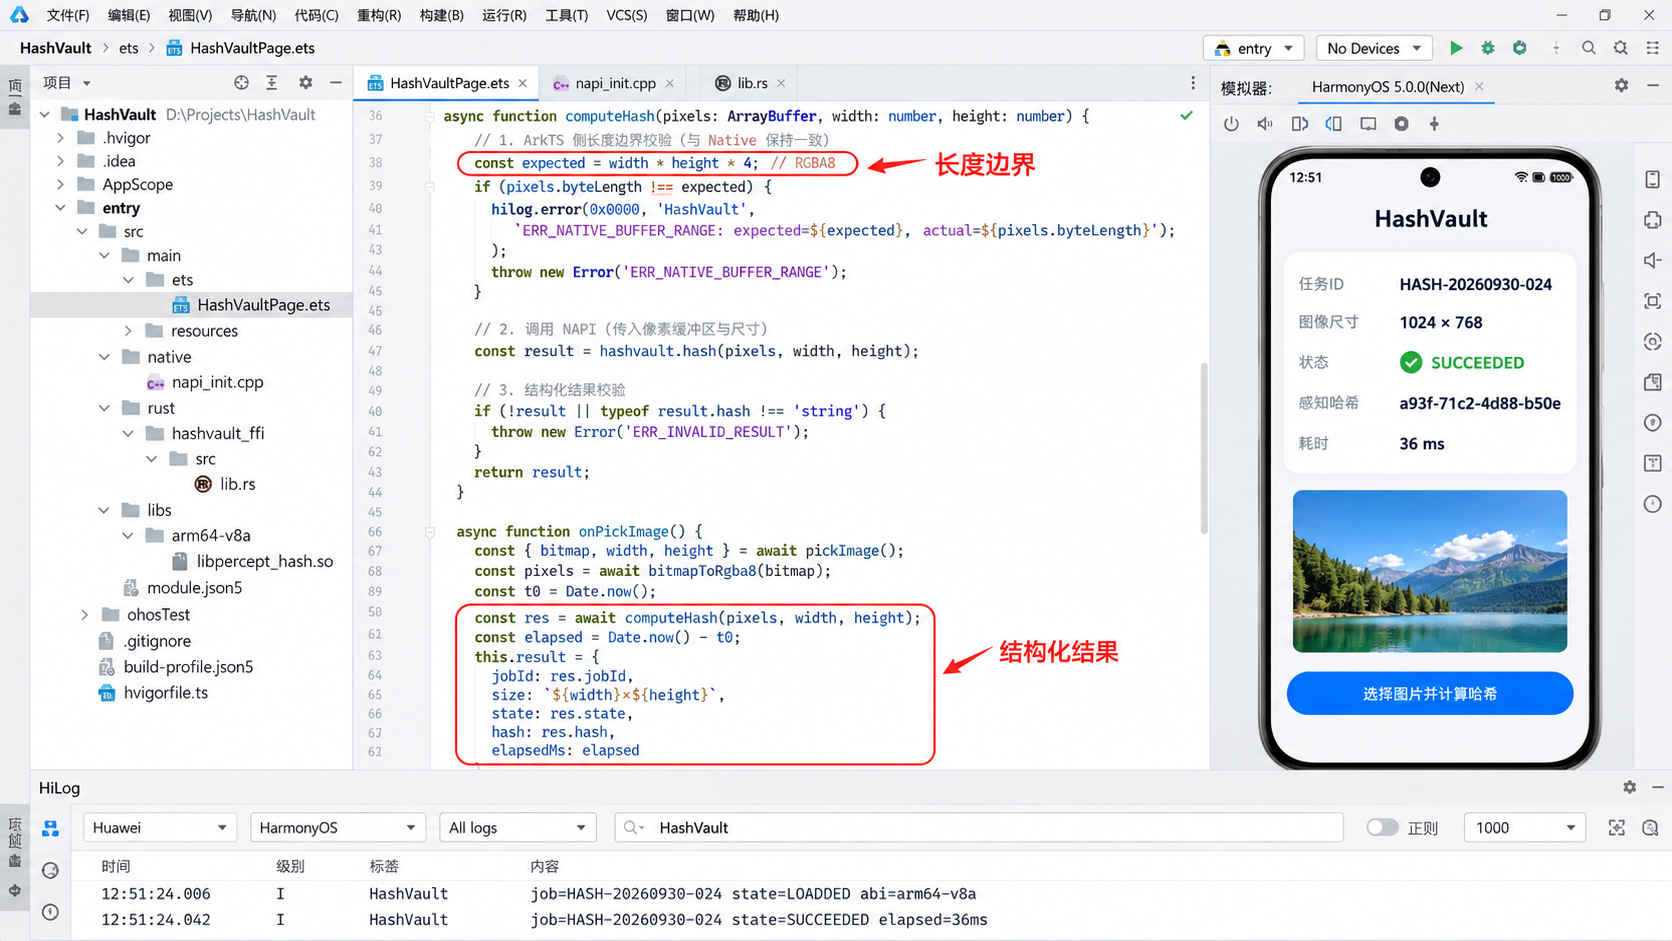
DevEco Studio 图中左侧能看到 HashVaultAdapter.ets、napi_init.cpp 与 hashvault_ffi;中间代码正在校验 byteLength=3145728;右侧模拟器显示任务成功;底部 HiLog 打印 LOADED → VALIDATED → EXECUTING → SUCCEEDED。红色标注只圈出缓冲区长度和 Native 错误码。
三、第二天:C++ 胶水只做翻译,不做图像算法
Node-API 是 ArkTS/JS 与 C/C++ 交互的稳定接口面。我们在 C++ 中读取对象字段、取得 ArrayBuffer 数据指针,调用 Rust 导出的 C 函数,再组装 ArkTS 对象。算法逻辑不进入这一层,否则同一个错误可能在 C++ 和 Rust 各实现一遍。
这段代码解决什么问题。 它在 Node-API 边界验证参数,确保传给 Rust 的指针、长度和尺寸互相一致,并把 Rust 错误码映射为结构化对象。
#include "napi/native_api.h"
#include "hashvault_ffi.h"

static napi_value ComputeHash(napi_env env, napi_callback_info info)
{
    size_t argc = 1;
    napi_value args[1] = { nullptr };
    napi_get_cb_info(env, info, &argc, args, nullptr, nullptr);
    if (argc != 1) return MakeError(env, "ERR_ARGUMENT_COUNT");

    uint32_t width = GetUint32(env, args[0], "width");
    uint32_t height = GetUint32(env, args[0], "height");
    uint32_t stride = GetUint32(env, args[0], "stride");
    napi_value bufferValue = GetNamed(env, args[0], "pixels");

    void *data = nullptr;
    size_t length = 0;
    bool isArrayBuffer = false;
    napi_is_arraybuffer(env, bufferValue, &isArrayBuffer);
    if (!isArrayBuffer || napi_get_arraybuffer_info(
        env, bufferValue, &data, &length) != napi_ok) {
        return MakeError(env, "ERR_NATIVE_BUFFER_RANGE");
    }

    const size_t expected = static_cast<size_t>(stride) * height;
    if (data == nullptr || stride < width * 4 || length < expected) {
        return MakeError(env, "ERR_NATIVE_BUFFER_RANGE");
    }

    HvOutput output {};
    int32_t code = hv_compute_rgba(
        static_cast<const uint8_t *>(data), length,
        width, height, stride, &output);
    return MakeResult(env, code, output);
}
这里最重要的不是 API 调用数量,而是生命周期。data 指向的是 ArkTS ArrayBuffer 管理的内存,只能在它有效的范围内读取。同步调用时,Rust 必须在函数返回前完成读取,不能偷偷保存这个指针。如果改成异步工作,应该把必要数据复制到 Native 自己拥有的缓冲区,或者建立明确的引用与释放机制。
expected 使用 size_t,并且在乘法前要考虑溢出。示例为了易读省略了完整的安全乘法函数,生产代码应检查 stride > SIZE_MAX / height。尺寸来自外部文件时,这不是理论问题:错误元数据可能让整数回绕,随后绕过长度检查。
四、第三天:Rust 侧把 panic 留在语言边界以内
第一次压力测试时,某个调试断言触发 panic。桌面测试程序能看到堆栈,装到设备后却表现为整个应用退出。原因很直接:Rust panic 穿过了 C ABI。跨 FFI 边界展开栈没有可靠语义,不能期待 C++ 帮忙接住。
我们做了两层处理:Release 构建避免依赖 panic 作为业务控制流;导出函数最外层使用 catch_unwind,把意外 panic 转成 HV_ERR_PANIC。这并不能捕获进程被系统杀死、非法指针或 abort,但能封住可展开的 Rust panic。
这段代码解决什么问题。 它为 Rust 导出函数建立唯一的异常出口,验证裸指针范围,并只通过 C 兼容结构返回结果。
use std::{panic::catch_unwind, slice, time::Instant};

#[repr(C)]
pub struct HvOutput {
    pub hash: u64,
    pub elapsed_ms: u32,
    pub consumed_bytes: usize,
}

const HV_OK: i32 = 0;
const HV_ERR_BUFFER_RANGE: i32 = 1001;
const HV_ERR_PANIC: i32 = 1900;

#[no_mangle]
pub unsafe extern "C" fn hv_compute_rgba(
    data: *const u8,
    len: usize,
    width: u32,
    height: u32,
    stride: u32,
    out: *mut HvOutput,
) -> i32 {
    if data.is_null() || out.is_null() || width == 0 || height == 0 {
        return HV_ERR_BUFFER_RANGE;
    }
    let expected = match (stride as usize).checked_mul(height as usize) {
        Some(value) if value <= len && stride >= width.saturating_mul(4) => value,
        _ => return HV_ERR_BUFFER_RANGE,
    };

    match catch_unwind(|| {
        let started = Instant::now();
        let pixels = slice::from_raw_parts(data, expected);
        let hash = perceptual_hash_rgba(pixels, width, height, stride);
        HvOutput {
            hash,
            elapsed_ms: started.elapsed().as_millis() as u32,
            consumed_bytes: expected,
        }
    }) {
        Ok(result) => { out.write(result); HV_OK }
        Err(_) => HV_ERR_PANIC,
    }
}
所有 unsafe 都被压缩在导出函数里,核心算法 perceptual_hash_rgba() 接收安全切片。这样代码审查可以集中检查三件事:指针是否为空、长度是否足够、输出指针是否可写。Rust 内部不接触 Node-API,也不分配需要 ArkTS 释放的字符串,避免跨语言分配器不一致。
哈希通过 u64 返回,C++ 再格式化为 a93f-71c2-4d88-b50e。这比 Rust 分配 C 字符串再让 C++ 释放更简单。若必须返回变长数据,要明确“谁分配、谁释放”,并提供成对的 alloc/free 接口;绝不能让 ArkTS、C++ 和 Rust 各自猜测所有权。
五、第四天:把耗时任务从 UI 线程拿走
36 ms 对单次按钮操作不算长,但连续处理相册时足以造成掉帧。同步 Node-API 调用会占用发起调用的线程,不能因为算法写在 Rust 里就自动获得并发。我们最终让页面提交任务,后台执行 Native 调用,完成后只把可序列化结果送回 UI。
这段代码解决什么问题。 它让页面状态沿 LOADED → VALIDATED → EXECUTING → SUCCEEDED 推进,并对成功与缓冲区拒绝采用同一套结果模型。
@Entry
@Component
struct HashVaultPage {
  @State jobId: string = 'HASH-20260930-024'
  @State state: string = 'LOADED'
  @State hash: string = '--'
  @State latency: string = '--'
  @State errorCode: string = 'OK'
  private adapter = new HashVaultAdapter()

  private async run(pixels: ArrayBuffer): Promise<void> {
    this.state = 'VALIDATED'
    const request: HashRequest = {
      jobId: this.jobId,
      width: 1024,
      height: 768,
      stride: 4096,
      pixels
    }
    this.state = 'EXECUTING'
    const result = await HashTaskRunner.execute(request, this.adapter)
    this.state = result.state
    this.hash = result.hash || '--'
    this.latency = `${result.elapsedMs} ms`
    this.errorCode = result.code
  }

  build() {
    Column({ space: 16 }) {
      Text('HashVault').fontSize(28).fontWeight(FontWeight.Bold)
      Text(this.state).fontSize(32).fontColor('#6C3FD1')
      Text(this.jobId)
      Text('1024 × 768 · RGBA · 3,145,728 bytes')
      Text(this.hash).fontFamily('monospace')
      Text(`耗时 ${this.latency}`)
      Text(this.errorCode).fontColor(this.errorCode === 'OK' ? '#067647' : '#D92D20')
    }.padding(24).width('100%')
  }
}
HashTaskRunner 是项目自己的任务调度抽象,底层可以根据当前 SDK 与数据传递约束选择异步工作、TaskPool、Worker 或子进程。关键不是名字,而是 UI 线程不直接承担批量计算,跨线程对象也不能偷偷携带不可转移的 Native 指针。
如果目标是隔离普通 panic,FFI 最外层转换错误码已经足够;如果目标是隔离非法内存访问,线程并不能提供进程级保护。对于不可信图片解析或历史包袱很重的 Native 库,可以评估 HarmonyOS 的 ArkTS/Native 子进程机制,把故障域进一步缩小。但子进程带来数据拷贝、启动成本和生命周期管理,不能为了“看起来安全”一律使用。
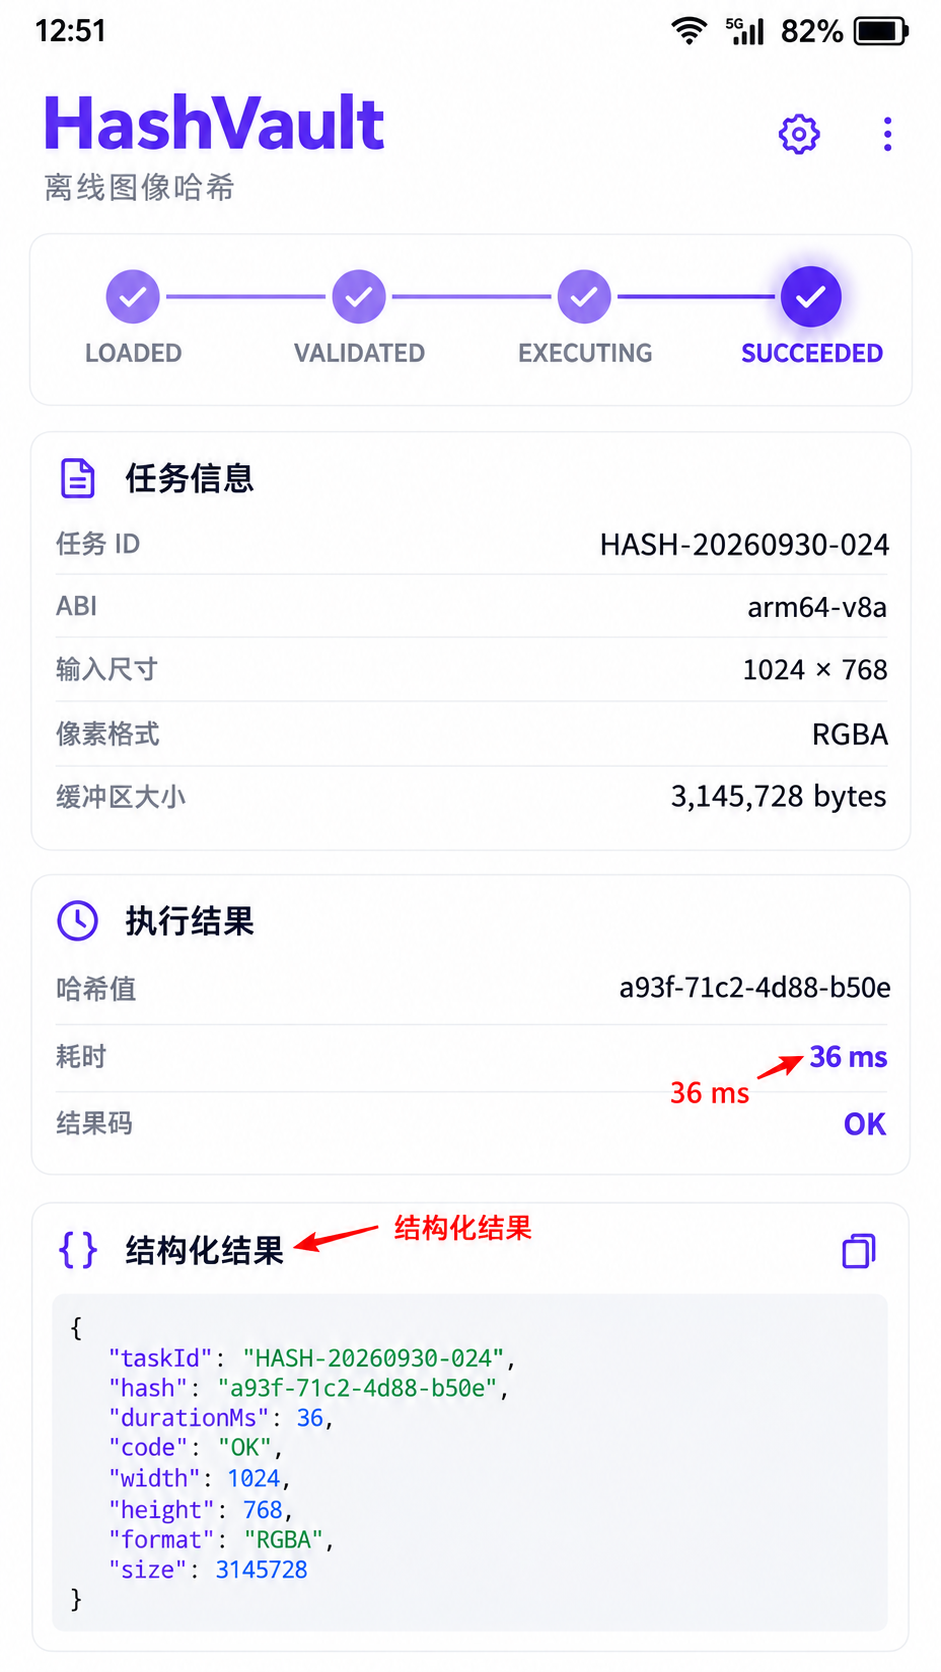
运行页展示成功路径:状态为 SUCCEEDED,输入 1024 × 768、缓冲区 3,145,728 bytes、结果 a93f-71c2-4d88-b50e、耗时 36 ms。红色箭头指向哈希值和耗时,和正文、HiLog 保持一致。
六、第五天:用错误注入验证边界,而不是只测成功页
跨语言库最危险的状态往往无法靠正常操作触发。我们做了三组错误注入:把缓冲区裁成 3,145,724 bytes,验证短 4 字节也会被拒绝;把 stride 改成 2048,验证行跨度小于 width × 4 会被拒绝;在测试构建中让算法主动 panic,验证返回 ERR_NATIVE_PANIC。
短缓冲区的 HiLog 如下:
12:51:24.006 I HashVault: job=HASH-20260930-024 state=LOADED abi=arm64-v8a
12:51:24.011 I HashVault: expected=3145728 actual=3145724 state=VALIDATED
12:51:24.012 E HashVault: code=ERR_NATIVE_BUFFER_RANGE state=REJECTED
12:51:24.012 I HashVault: native_call_skipped=true process_alive=true
最后一行很关键:错误在 ArkTS 前置校验阶段就被发现,Native 调用被跳过,进程仍然存活。随后我们绕过 ArkTS 适配器直接调用 C++ 测试入口,C++ 也返回同一个错误码;说明两层验证没有出现语义分叉。
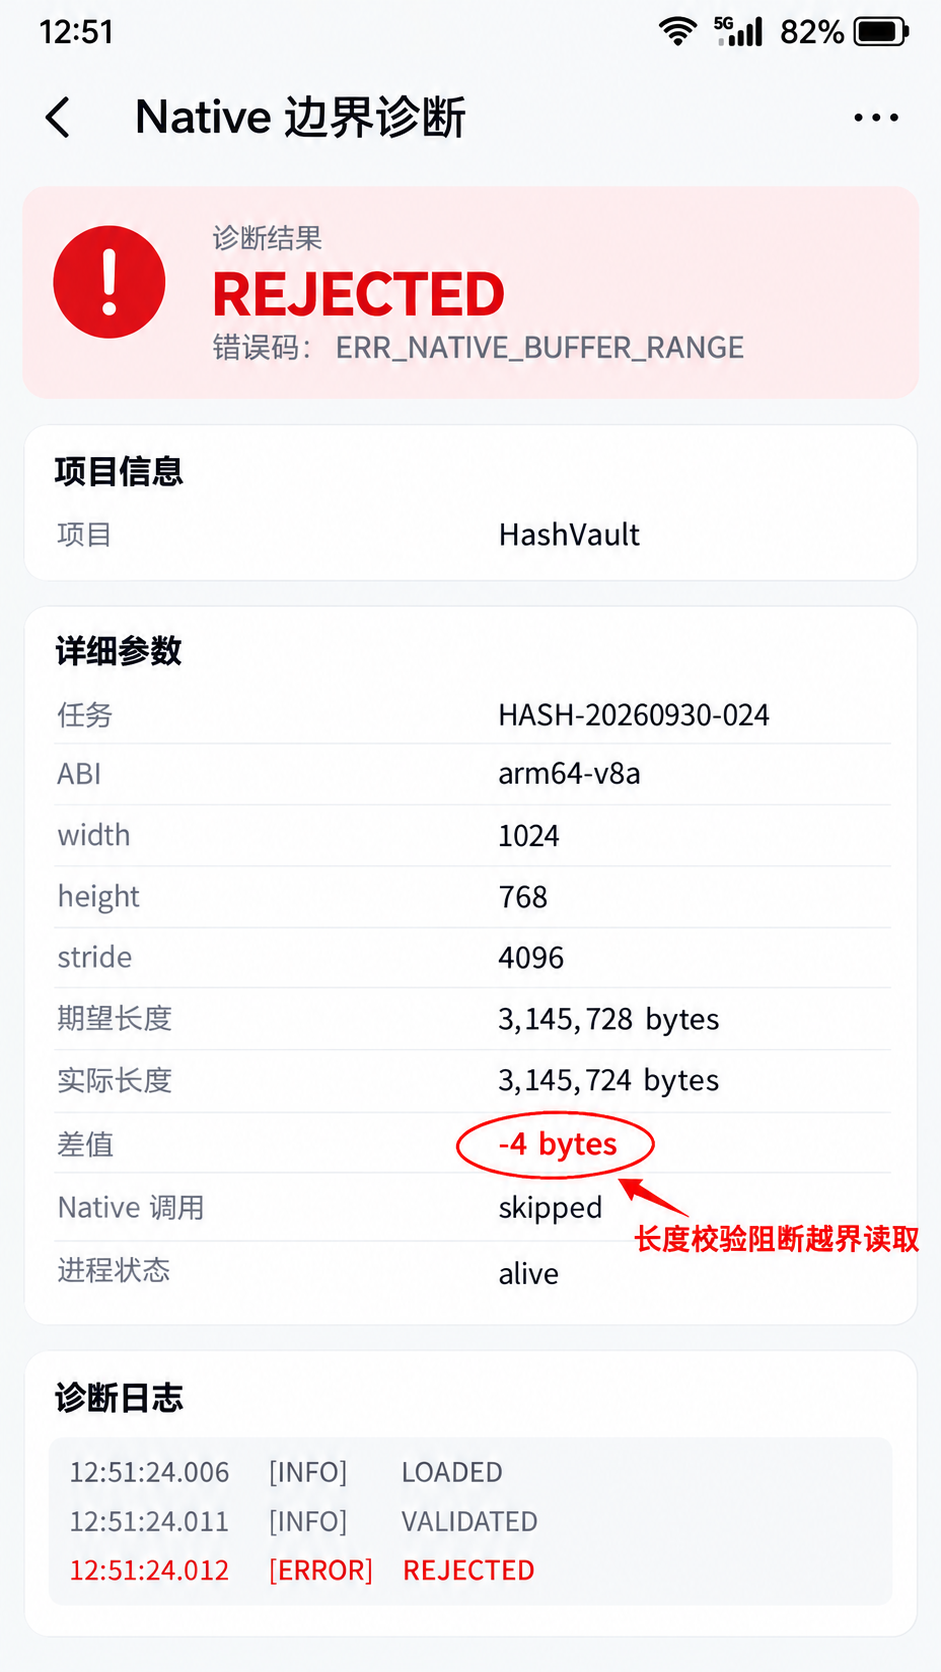
诊断页与成功页明显不同:它展示期望长度 3,145,728、实际长度 3,145,724、错误码 ERR_NATIVE_BUFFER_RANGE 和 process alive。红圈落在 4 字节差值上,箭头指向“Native 调用已跳过”,让读者看到崩溃隔离是怎样发生的。
七、构建与发布时真正容易遗漏的东西
库能在本机跑起来不代表可以发布。首先要确认产物 ABI 与设备一致,本次只验证了 arm64-v8a;如果同时提供其他架构,Rust target、CMake 导入路径和打包目录必须一一对应。其次要固定 Rust 工具链与依赖锁文件,避免构建机升级后生成不同二进制。
符号策略也要提前决定。发布包可以剥离符号减小体积,但必须安全保存与版本完全对应的未剥离符号文件,否则线上 Native 崩溃只有地址,没有可读堆栈。libpercept_hash.so 的版本号、Git 提交、Rust 编译器版本和 HAP 版本应写入构建清单,HiLog 至少打印库版本,不打印用户图片内容。
性能测试要区分冷启动与热调用。第一次加载动态库、初始化查找表与分配缓存会放大耗时;后续 36 ms 不能代表首次体验。批处理还要观察峰值内存,避免为每张图片重复复制 3 MB 缓冲区。只有确认生命周期安全后,才考虑共享缓冲区或零拷贝优化,不能倒过来。
八、最终保留下来的边界清单
这次接入最后稳定在四条约束上。ArkTS 只接触领域对象,不接触 Rust 指针;C++ Node-API 层只做类型、长度和结果映射,不写算法;Rust 导出层只使用 C ABI 数据结构,所有 unsafe 集中审查;耗时和高风险任务根据故障模型选择线程或子进程,UI 只订阅状态。
成功路径的指标是 36 ms / 3,145,728 bytes / SUCCEEDED,失败路径的指标是 ERR_NATIVE_BUFFER_RANGE / native_call_skipped=true / process_alive=true。后者甚至比前者更重要,因为三方库接入的质量,不只看它能不能算出结果,还要看输入错误、算法异常和版本漂移发生时,应用能否给出可定位、可恢复的结果。
参考资料:

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 2
 0
- 0


 已为社区贡献4条内容

所有评论(0)