HarmonyOS 7 gl-matrix:3DGS视锥裁剪与首帧防闪
一、模型没有变,转一下镜头却白了一帧
SplatFrustumLab 的目标很直接:在 HarmonyOS 设备上预览一个 124 万 Splat 的室内 3DGS 场景,拖动相机时只提交视锥内的点。第一版已经做了裁剪,静止画面从 1240000 个点降到 286400 个点,GPU 压力明显下降;真正影响体验的,是快速转向时偶发的一帧空白。
日志里那一帧并非 GPU 崩溃。相机从 poseEpoch 41 切到 42,旧裁剪任务晚返回 6ms,把“旧视角可见批次”提交给了新相机。新视角看不到那批点,于是画面像闪了一下,下一帧新任务到达才恢复。问题不在裁剪数学,而在异步结果缺少相机所有权。
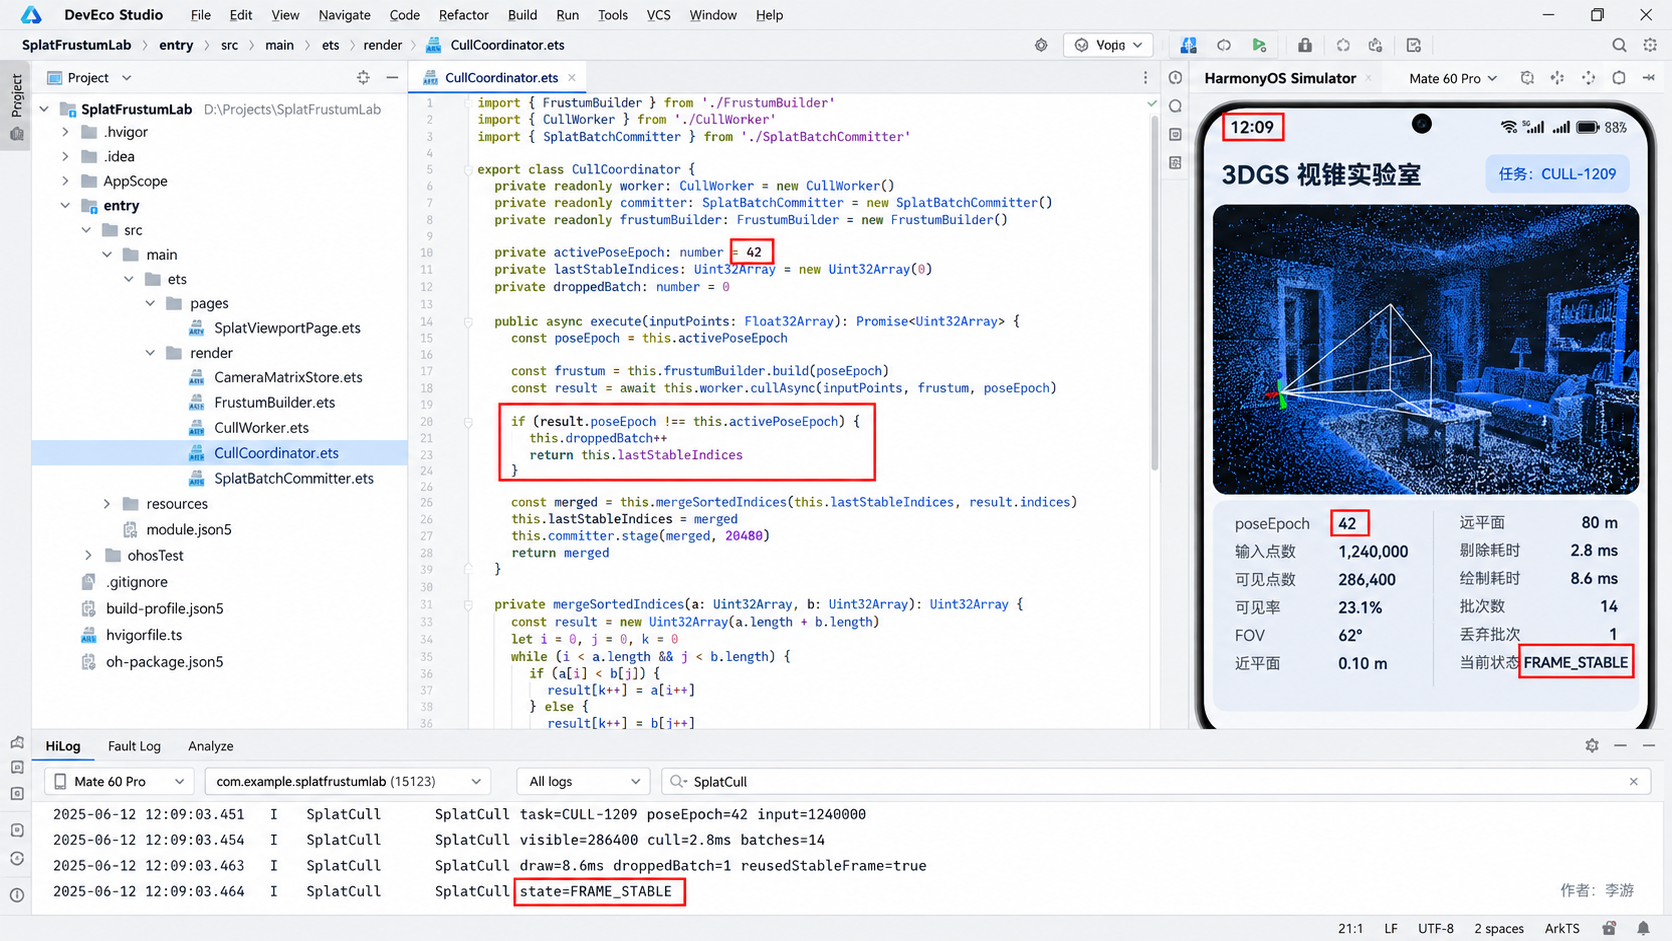
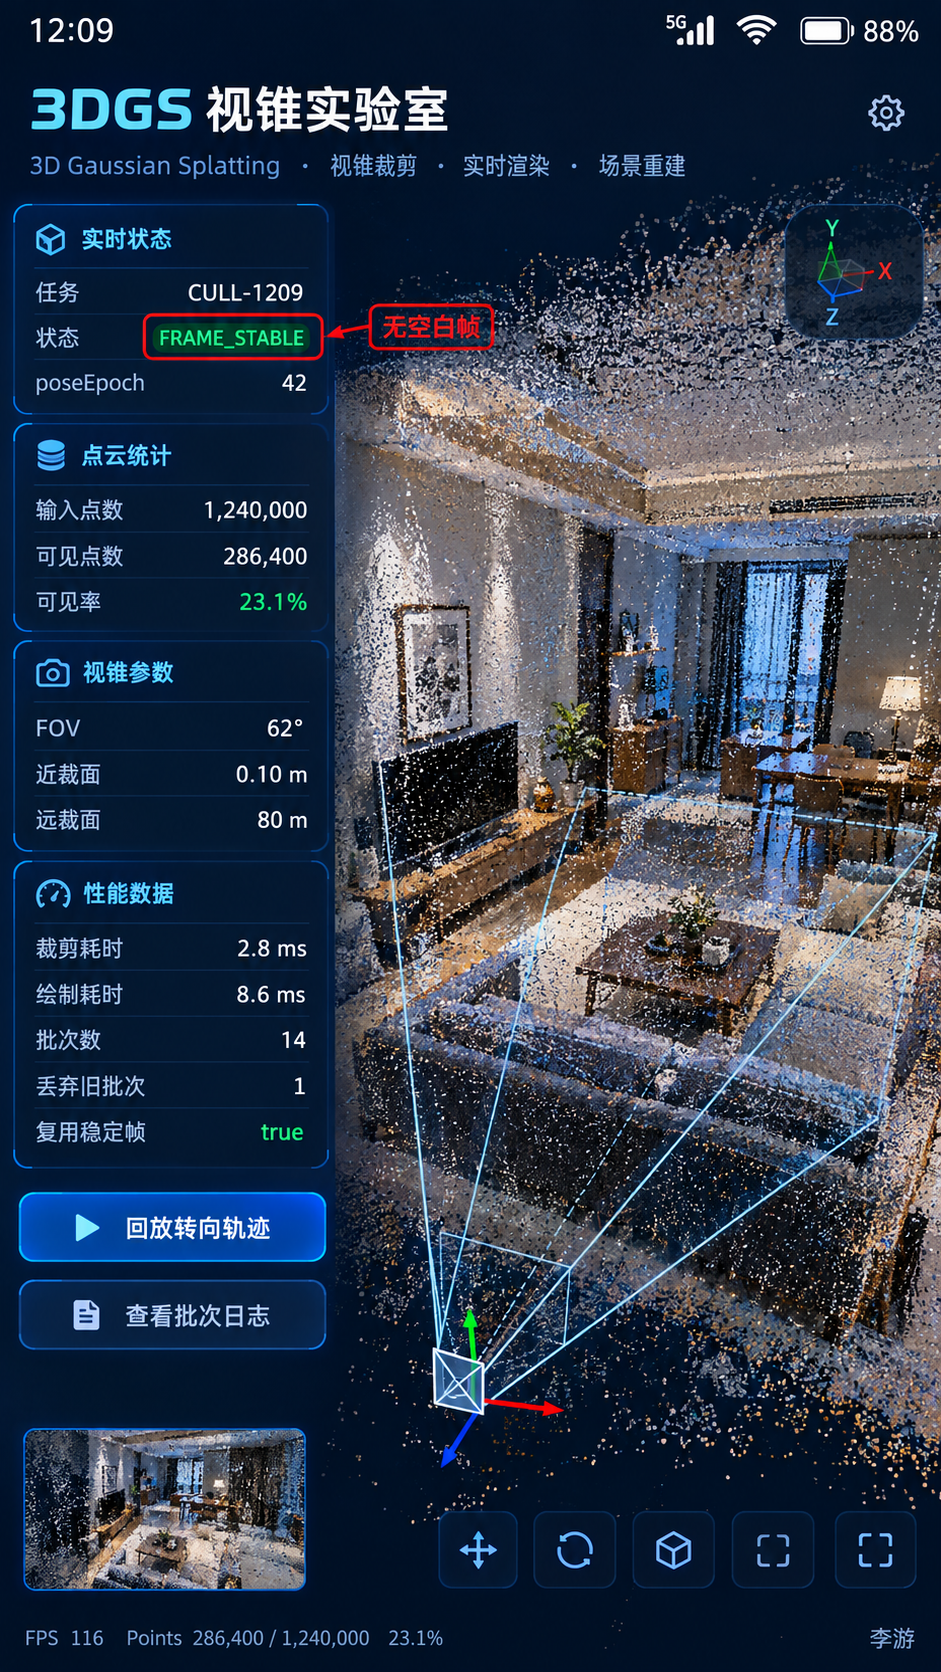
我把这次 Demo 的验收条件固定下来:任务 CULL-1209,页面 SplatViewportPage,相机 FOV 62°,near=0.10m,far=80m,poseEpoch=42;裁剪输入 1240000,输出 286400,CPU 裁剪 2.8ms,提交批次 14 个,绘制 8.6ms,状态 FRAME_STABLE。所有图片和日志都围绕这组数据,不再把“帧率看着还行”当结论。
二、视锥平面只计算一次,点只做有界判断
项目引入 gl-matrix 不是为了把渲染器改成数学课,而是借它稳定处理 view/projection 矩阵。每次相机提交时生成 viewProjection,提取六个归一化平面;裁剪循环只做点到平面的符号判断,并给 Splat 半径留出余量。若每个点都重新做矩阵乘法,124 万次循环会把节省下来的 GPU 时间又花在 CPU 上。
第一段代码解决视锥快照如何与相机代次绑定。FrustumSnapshot 是不可变输入,裁剪任务拿到它后不再读取页面上的相机对象,避免任务执行到一半时相机矩阵被原地修改。
import { mat4, vec4 } from 'gl-matrix'

interface FrustumSnapshot {
  poseEpoch: number
  planes: Float32Array
  fov: number
  near: number
  far: number
}

function buildFrustum(view: mat4, projection: mat4,
  poseEpoch: number): FrustumSnapshot {
  const vp = mat4.multiply(mat4.create(), projection, view)
  const rows: vec4[] = [
    vec4.fromValues(vp[3] + vp[0], vp[7] + vp[4], vp[11] + vp[8], vp[15] + vp[12]),
    vec4.fromValues(vp[3] - vp[0], vp[7] - vp[4], vp[11] - vp[8], vp[15] - vp[12]),
    vec4.fromValues(vp[3] + vp[1], vp[7] + vp[5], vp[11] + vp[9], vp[15] + vp[13]),
    vec4.fromValues(vp[3] - vp[1], vp[7] - vp[5], vp[11] - vp[9], vp[15] - vp[13])
  ]
  const planes = new Float32Array(24)
  rows.forEach((plane, index) => {
    const length = Math.hypot(plane[0], plane[1], plane[2])
    for (let i = 0; i < 4; i++) planes[index * 4 + i] = plane[i] / length
  })
  return { poseEpoch, planes, fov: 62, near: 0.10, far: 80 }
}
示例省略了 near/far 两个平面的展开,实际工程会补齐六面。关键不是公式数量,而是 snapshot 的生命周期:相机变化就创建新对象,旧任务仍可读完自己的数据;不要把同一块 Float32Array 原地覆盖,否则代次判断正确,数学输入仍可能被污染。
三、裁剪任务可以过期,提交动作不能过期
第二步把 124 万点按 65536 个一块分片,TaskPool 只返回可见索引,不碰 ArkGraphics 3D 节点。页面持有 activePoseEpoch,合并前后都核对代次。这样旧任务即使已经占用 CPU,也只会被统计为 droppedBatch,不会写入 GPU 批次。
下面代码解决旧相机结果覆盖新相机的问题。它还保留 lastStableIndices:当新代次尚未形成完整批次时,渲染器继续显示上一份稳定结果,而不是先清空再等待。
interface CullResult {
  poseEpoch: number
  visible: Uint32Array
  elapsedMs: number
}

class CullCoordinator {
  activePoseEpoch: number = 42
  droppedBatch: number = 0
  private lastStableIndices: Uint32Array = new Uint32Array()

  async cull(snapshot: FrustumSnapshot,
    points: Float32Array): Promise<Uint32Array> {
    const result = await taskpool.execute<CullResult>(
      new taskpool.Task(cullWorker, snapshot, points))
    if (result.poseEpoch !== this.activePoseEpoch) {
      this.droppedBatch++
      return this.lastStableIndices
    }
    const merged = mergeSortedIndices(result.visible)
    if (snapshot.poseEpoch !== this.activePoseEpoch) {
      this.droppedBatch++
      return this.lastStableIndices
    }
    this.lastStableIndices = merged
    return merged
  }
}
这里不在相机变化时立刻把旧任务“强杀”。多数运行时取消只能阻止尚未开始的任务,不能可靠终止正在执行的循环;把提交权收回更确定。页面销毁时仍要清空待办与 GPU 引用,但正常转向只更新 activePoseEpoch,让旧结果自然失效。
四、批次合并要服从一帧预算
第三个问题是一次性上传 286400 个索引会造成主线程尖峰。我们把结果按 20480 个索引拆成 14 个批次,在下一次 VSync 前只提交完整集合。14 个批次不是 14 次逐步可见;先写 staging buffer,校验批次总数、代次和索引范围后,再一次性交换 active buffer。
第三段代码把“准备”和“可见”分开。commit() 只接受当前代次的完整集合,避免用户看到半个房间先出现、另外一半后补上的视觉撕裂。
class SplatBatchCommitter {
  private staging: Uint32Array[] = []

  stage(indices: Uint32Array, batchSize: number = 20480): number {
    this.staging = []
    for (let offset = 0; offset < indices.length; offset += batchSize) {
      this.staging.push(indices.slice(offset, Math.min(offset + batchSize, indices.length)))
    }
    return this.staging.length
  }

  commit(node: SplatRenderNode, poseEpoch: number,
    activePoseEpoch: number): boolean {
    if (poseEpoch !== activePoseEpoch || this.staging.length !== 14) return false
    const buffer = node.createIndexBuffer(286400)
    this.staging.forEach((batch) => buffer.append(batch))
    node.swapVisibleIndexBuffer(buffer)
    this.staging = []
    return true
  }

  release(): void {
    this.staging = []
  }
}
索引数量和批次数在产品代码里应来自结果,不应写死;本文固定为演示数据,便于正文、图片和验收对齐。若某批写入失败,staging buffer 整体释放,active buffer 保持不变。这样错误最多让画面停留在上一帧,不会生成空白帧。
五、目录与日志如何证明没有闪白
工程将 CameraMatrixStore.ets、FrustumBuilder.ets、CullWorker.ets、CullCoordinator.ets 和 SplatBatchCommitter.ets 分开。页面只接收 FrameViewState。HiLog 固定输出:task=CULL-1209 poseEpoch=42 input=1240000、visible=286400 cull=2.8ms batches=14、draw=8.6ms droppedBatch=1 reusedStableFrame=true、state=FRAME_STABLE。
六、结果与边界
连续快速转向 60 次后,旧 epoch=41 的结果被丢弃一次,active buffer 没有被清空;新 epoch=42 的 14 个批次完整后一次交换,画面保持 FRAME_STABLE。最终页面显示 FOV 62°、near 0.10m、far 80m、可见率 23.1%、裁剪 2.8ms、绘制 8.6ms。
这套实现解决的是 CPU 视锥裁剪结果与相机状态的时序一致性,不替代遮挡剔除,也不处理 Splat 的深度排序误差。场景继续变大时,还需要空间索引或 GPU 计算。对这个 Demo 来说,真正重要的改动不是“少画了多少点”,而是任何异步优化都不能牺牲一帧的可见性契约:旧结果可以浪费一点计算,不能拥有新画面的提交权。
七、三个容易被性能数字掩盖的细节
第一个细节是可见率不能单独拿来比较性能。镜头朝向墙面时,可见点少,裁剪更快;转向开阔区域时,可见点增加,上传与排序成本都会变化。验收时要固定相机路径,而不是挑一张最轻的静止画面。CULL-1209 保存了 60 次转向的相机轨迹,所有版本都按同一轨迹回放。
第二个细节是上一稳定帧也有有效期。如果相机已经转过很大角度,长时间复用旧结果会变成拖影。Demo 给稳定帧设置 50ms 上限,超过后改用低密度全场景代理,而不是继续展示错误视角。本文的 2.8ms 裁剪始终在这个窗口内,因此没有触发代理降级。
第三个细节是内存峰值。active、staging 与 worker result 同时存在时,会短暂持有三份索引。提交完成后必须立即释放 staging 和旧 active;页面进入后台则停止新裁剪,保留一份最小代理。否则“没有白帧”可能是靠无限缓存换来的,实机运行几分钟后仍会被内存压力打回原形。
我最终把性能验收写成四个同时成立的条件:裁剪时间不超过 4ms,绘制不超过 10ms,旧代次提交为 0,空白帧为 0。前两个是速度,后两个是正确性。只有四项一起达标,优化才算完成。
八、把生命周期也纳入帧状态机
页面退到后台时,我最初只停止了下一次 worker 派发,却没有废弃正在计算的 poseEpoch。结果是页面再次前台化后,后台期间完成的旧结果仍能进入 commit(),第一帧会短暂跳回旧视角。修正方式不是增加延迟,而是在 onPageHide 和窗口不可见回调里同时递增 activePoseEpoch、清空 staging,并把当前 active buffer 降为只读稳定帧;恢复可见后重新读取相机矩阵,创建新代次,再允许 worker 返回结果。这样前后台切换和快速转向遵守同一套提交规则。
资源释放也要讲顺序。先让协调器拒绝新结果,再等待本轮 buffer 交换结束,最后释放 worker、staging 和旧索引缓冲。如果先销毁 RenderNode,晚到的回调可能继续写入已经失效的对象;如果只置空数组,底层图形资源仍可能占用显存。Demo 在离场日志中额外记录 pendingJob=0、stagingBatch=0 和 renderBufferReleased=true,并连续执行二十次进出页面。峰值没有随次数爬升,才说明首帧防闪不是靠泄漏上一帧资源实现的。
这一轮还验证了窗口尺寸变化。折叠或分屏会改变宽高比,但不会自动代表相机姿态变化;矩阵仓库因此把 viewportRevision 与 poseEpoch 分开记录,两者任一变化都重建视锥,提交时则同时比对。这样旋转窗口不会误用旧平面,单纯相机移动也不必重建与尺寸无关的资源。状态拆细以后,性能日志稍长,却能准确指出是哪一种变化让批次失效。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 1
 0
- 0


 已为社区贡献15条内容

所有评论(0)