HarmonyOS 7 textSearchImage:相似度门限样本校准与空结果降级
文搜图接入后,页面能返回图片,并不代表检索体验已经稳定。真正容易被忽略的是那一串 similarity:它看起来像百分制分数,开发时也很容易顺手写成“高于 0.5 就展示”,但官方定义只说明取值范围为 [-1, 1],数值越大越相似,并没有替业务规定统一及格线。
同一门限放到“晚霞”“蓝色文件夹旁的咖啡杯”“会议白板上的箭头”这些查询上,留下的结果数量往往完全不同。门限太高,页面看起来像搜索失败;门限太低,用户看到一排勉强沾边的图。问题不在 API 是否返回,而在应用有没有把分数变成可解释的产品决策。
本文用 SemanticRankLab 做一套校准台。演示任务固定为 TXT-1918-526,时间 19:18,查询词是“蓝色文件夹旁的咖啡杯”,作用域为 album2026,topKey 为 25。演示样本在门限 0.42 下保留 17 张,也就是 68%,状态记为 CALIBRATED_READY。这些是为了让代码、日志和配图可以对账的示例数据,不冒充真实设备跑分,也不把 0.42 宣称成通用推荐值。
一、先把“分数”从界面文案里拿出来
textSearchImage.search(query, scope, topKey) 返回 ImageObject[]。对象里有沙箱路径、作用域和相似度。API 26 的参数边界也很明确:查询词长度 1~100,不能只由数字或字母组成;scope 由 1~32 个字母或数字构成;topKey 是 0~100 的整数,默认 100。
这些边界解决的是“请求是否合法”,没有替应用回答“哪张图值得展示”。相似度也不等于置信概率,不能直接写成“42% 正确”。更稳妥的做法是把它称为相关度分数,并把筛选、排序、兜底都留在应用层。
我更在意三个现象。
第一,同一批结果在门限附近会很密。0.41 和 0.42 的差别可能只是浮点数的最后几位,却会让列表突然少掉几张。第二,分数相同或非常接近时,如果没有二级排序,页面刷新后顺序可能变化。第三,空结果既可能表示图库里没有匹配内容,也可能只是门限过紧,不能都翻译成“没有照片”。
所以 SearchTuningPage 不直接消费原始结果。页面只认识 RankedPhoto:包含原始分数、归一后的展示分、是否入选、稳定排序键和拒绝原因。这样做看起来多了一层,实际把不可解释的 UI 抖动挡在了服务层外面。
二、样本校准不是拍脑袋选一个小数
门限应来自一组与产品场景接近的标注样本。最小可用做法不需要复杂训练:准备若干查询词,每个查询取固定 topKey,让标注者把结果分为“相关”“勉强相关”“不相关”。然后在多个候选门限上计算保留率、准确率和漏召回情况。
演示台用 25 个候选结果做一次检查。门限 0.42 时保留 17 个,进度条显示 68%。这个数字只说明本次样本的过滤结果,不能外推到其他图库。实际项目至少要按查询类型分桶:颜色与物体组合、场景描述、文字内容、人物关系,分数分布往往不在同一条线上。
下面这段代码解决“原始结果不能直接绑定 UI”的问题。它做三件事:校验分数范围、按门限标记入选,再用 similarity → imagePath 做稳定排序。路径不是相关性依据,只在分数相同的时候提供确定顺序。
import { textSearchImage } from '@kit.CoreVisionKit';

interface RankedPhoto {
  imagePath: string;
  scope: string;
  similarity: number;
  selected: boolean;
  rejectReason: string;
}

async function rankQuery(
  query: string,
  scope: string,
  topKey: number,
  threshold: number
): Promise<RankedPhoto[]> {
  const source = await textSearchImage.search(query, scope, topKey);
  return source
    .filter(item => Number.isFinite(item.similarity))
    .map(item => {
      const inRange = item.similarity >= -1 && item.similarity <= 1;
      const selected = inRange && item.similarity >= threshold;
      return {
        imagePath: item.imagePath,
        scope: item.scope,
        similarity: item.similarity,
        selected,
        rejectReason: inRange ? (selected ? '' : 'BELOW_THRESHOLD') : 'INVALID_SCORE'
      };
    })
    .sort((a, b) => b.similarity - a.similarity ||
      a.imagePath.localeCompare(b.imagePath));
}
这里没有把分数乘 100 后称为准确率。页面可以显示 0.63,也可以显示“相关度较高”,但不要改写它的统计含义。另一个易错点是先排序再过滤却没有保存拒绝原因,调试时只看到数量变少,不知道是分数越界还是门限过滤。保留原因字段,日志才有审计价值。
三、把初始化、搜索和释放做成一段生命周期
官方指南建议在页面出现时初始化,在页面消失时释放。实际页面还有连续输入、路由切换和旧 Promise 回调。只写 aboutToAppear 与 aboutToDisappear 仍然可能让上一次查询覆盖新查询。
RankCalibrator 因此持有 generation。每次查询加一,页面离开时再加一并进入关闭状态。结果返回后只有代次仍一致才允许提交。release() 也要等待当前接纳逻辑结束,避免释放过程中又启动新搜索。
下面这段代码解决“快速改词后旧结果回写”和“页面退出时资源释放”的问题。textSearchImage 没有在这里被描述成支持取消;代次只是应用层拒绝迟到结果,并不会停止系统内部已经发出的请求。
import { textSearchImage } from '@kit.CoreVisionKit';
import { hilog } from '@kit.PerformanceAnalysisKit';

class RankCalibrator {
  private generation: number = 0;
  private ready: boolean = false;
  private closing: boolean = false;

  async open(): Promise<void> {
    this.closing = false;
    this.ready = await textSearchImage.init();
  }

  async search(query: string): Promise<RankedPhoto[]> {
    if (!this.ready || this.closing) {
      throw new Error('SEARCH_SERVICE_NOT_READY');
    }
    const generation = ++this.generation;
    const ranked = await rankQuery(query, 'album2026', 25, 0.42);
    if (generation !== this.generation || this.closing) {
      hilog.warn(0x1918, 'RankCalibrator', 'late result ignored');
      return [];
    }
    return ranked;
  }

  async close(): Promise<void> {
    this.closing = true;
    this.generation++;
    if (this.ready) {
      await textSearchImage.release();
      this.ready = false;
    }
  }
}
成对处理很重要。只调用 init() 不释放,会让页面反复进入后的资源状态难以判断;先把 ready 设为 false 再等待释放,又可能让错误恢复逻辑误以为可以立刻初始化。当前实现用 closing 阻止新请求,并在 release() 完成后再清理状态。若产品把服务提升到 Ability 级单例,生命周期边界也要一起提升,不能机械照搬页面代码。
四、日志要能回答“为什么只剩 17 张”
项目目录刻意分成页面、协调器和校准规则:
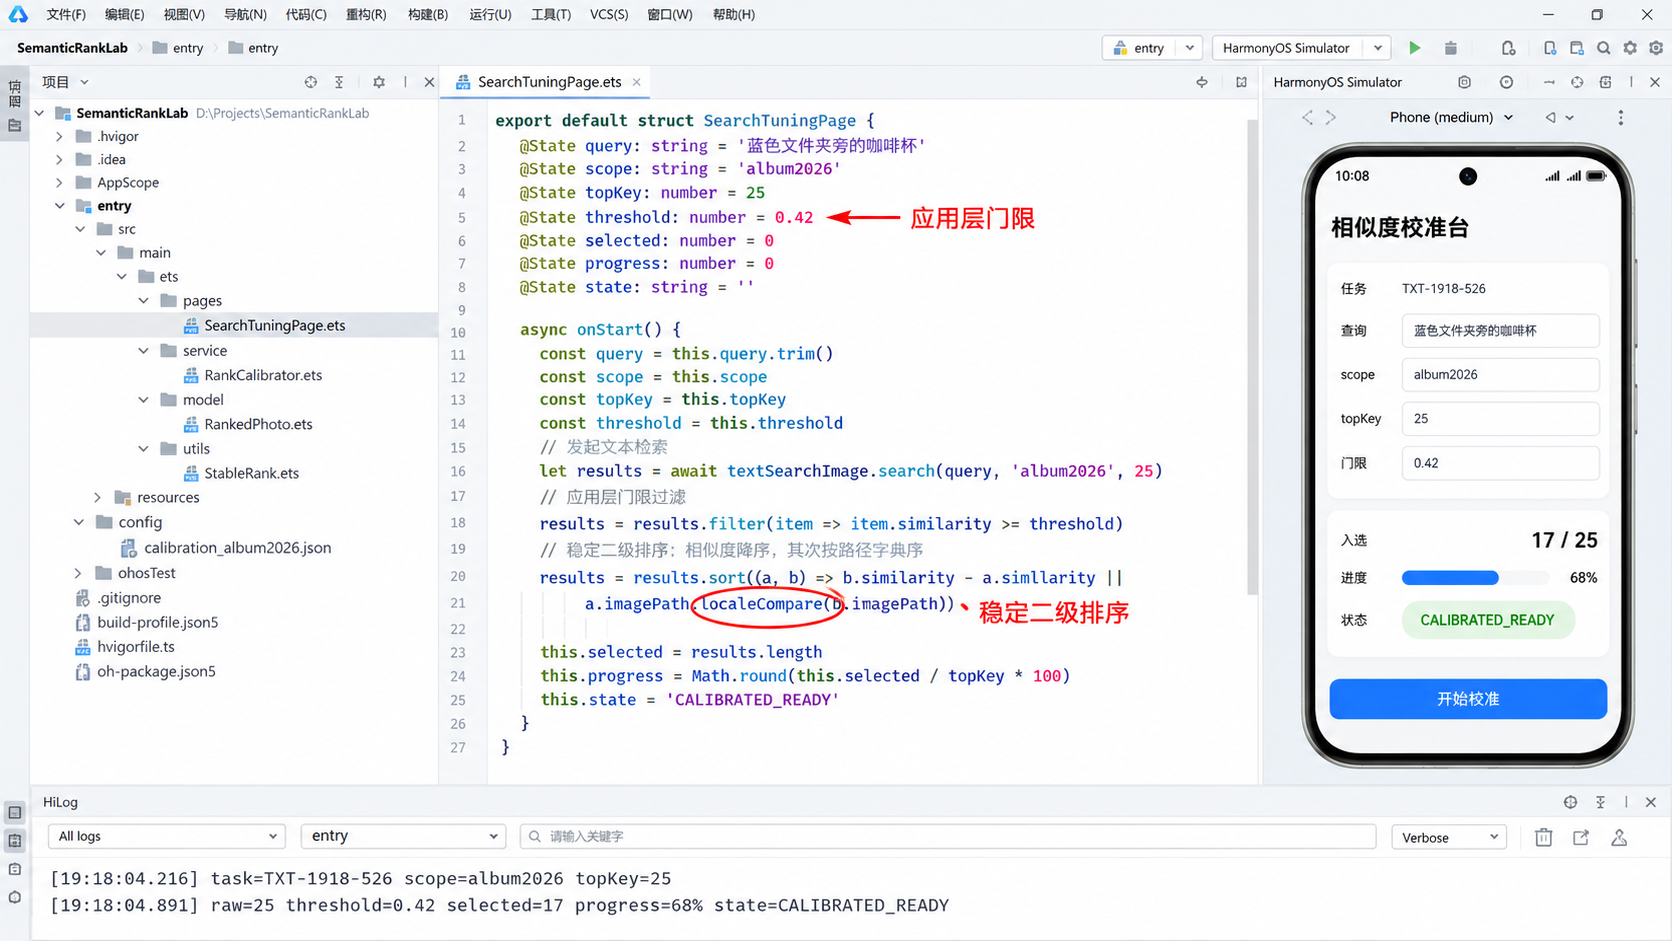
pages/SearchTuningPage.ets:展示查询、门限和结果;service/RankCalibrator.ets:管理初始化、代次与释放;model/RankedPhoto.ets:保存原始分数和拒绝原因;config/calibration_album2026.json:保存样本版本与门限;utils/StableRank.ets:提供稳定二级排序。
演示日志固定为:
[19:18:04.216] task=TXT-1918-526 query=蓝色文件夹旁的咖啡杯 scope=album2026 topKey=25
[19:18:04.891] raw=25 threshold=0.42 selected=17 progress=68% state=CALIBRATED_READY
图中的 DevEco Studio 是与本文数据一致的演示配图,不是真实 IDE 截屏,也不能替代真机验证。它承担的是结构解释:左边能看到校准文件,中间是稳定排序代码,右侧模拟器显示 17/25,底部日志说明 68% 如何得到。
真实调试时还要记录校准版本。只记 threshold=0.42 不够,因为同一个数值可能来自不同样本集。建议至少记录 calibrationId、样本日期、查询分桶和图库版本。阈值更新后,线上现象才能回到具体规则,而不是陷入“昨天还正常”的口头描述。
五、稳定排序解决的是闪动,不是相关性
很多实现把结果直接交给瀑布流。只要两张图分数接近,异步缩略图加载就可能让用户误以为排名变化。稳定排序先固定数据顺序,再让图片各自加载。加载失败可以显示占位,但不能把后面的图片偷偷顶到更高排名,否则截图、点击统计和复现日志会对不上。
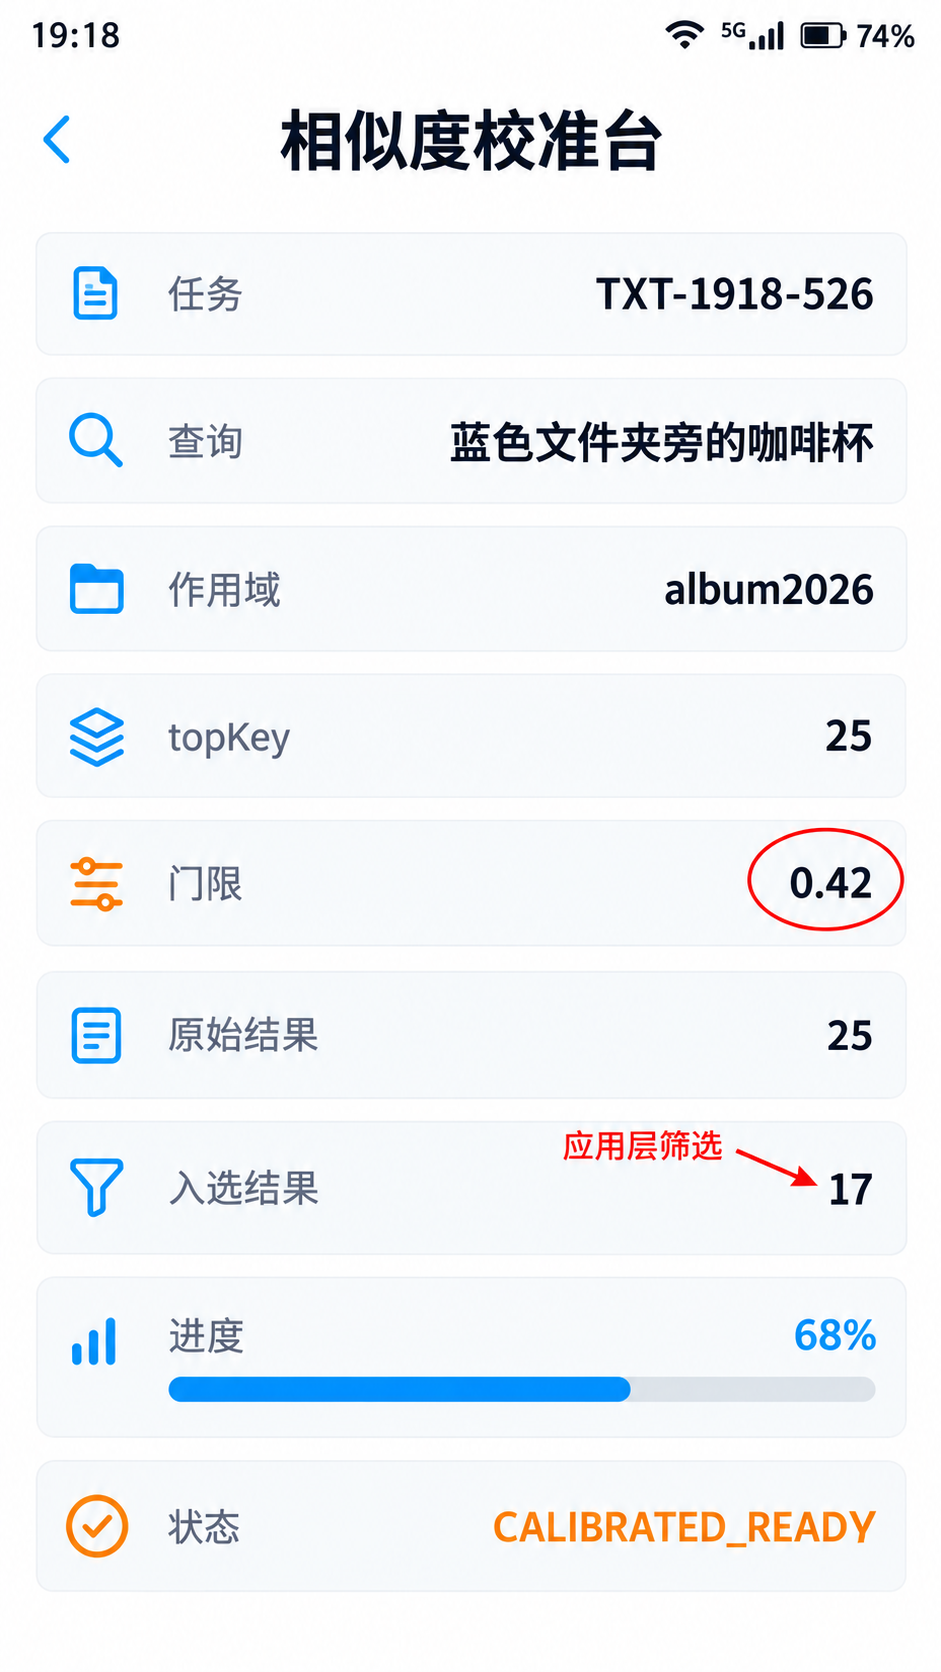
手机运行页展示本次校准结果:任务 TXT-1918-526,查询词、作用域、门限、25 个原始结果、17 个入选结果和 68% 都与正文一致。红圈只标门限,箭头指向应用层筛选结果。
对分数相同的结果,本文使用路径作为二级键,是因为它稳定且现成;它并不代表业务偏好。若产品希望“最近照片优先”,需要明确引入拍摄时间,并在日志里写出排序策略版本。不要一边说“按相关度排序”,一边悄悄混入时间权重。
六、空结果要区分三种状态
页面没有卡片时,至少可能有三种原因:原始搜索就是空数组;原始结果存在,但都低于门限;服务异常或能力更新要求重建数据。第三种此前已有专门的全库重建主题,本文不重复展开,只保留错误状态并停止把异常翻译成业务空结果。
对“全部低于门限”,可以给一次受控降级。这里不是自动把门限一路降到有结果,而是使用预先定义的底线 floorThreshold,并标记结果来自降级策略。低于底线仍为空,就展示最近图片入口,不伪装成搜索命中。
下面这段代码解决“空数组含义混乱”的问题。它把严格结果、降级结果和真正空结果分开,页面可据此显示不同说明。
type SearchState = 'STRICT_READY' | 'FALLBACK_READY' | 'EMPTY';

interface SearchDecision {
  state: SearchState;
  items: RankedPhoto[];
  appliedThreshold: number;
}

function decideResults(
  ranked: RankedPhoto[],
  threshold: number,
  floorThreshold: number
): SearchDecision {
  const strict = ranked.filter(item => item.similarity >= threshold);
  if (strict.length > 0) {
    return { state: 'STRICT_READY', items: strict, appliedThreshold: threshold };
  }
  const fallback = ranked.filter(item => item.similarity >= floorThreshold);
  if (fallback.length > 0) {
    return { state: 'FALLBACK_READY', items: fallback, appliedThreshold: floorThreshold };
  }
  return { state: 'EMPTY', items: [], appliedThreshold: floorThreshold };
}
floorThreshold 同样要由样本决定,不能在代码里不断减 0.05。若降级结果被点击,也应单独统计,不能混进严格命中率。这样才能判断问题来自门限过紧,还是图库本来就缺少用户想找的内容。
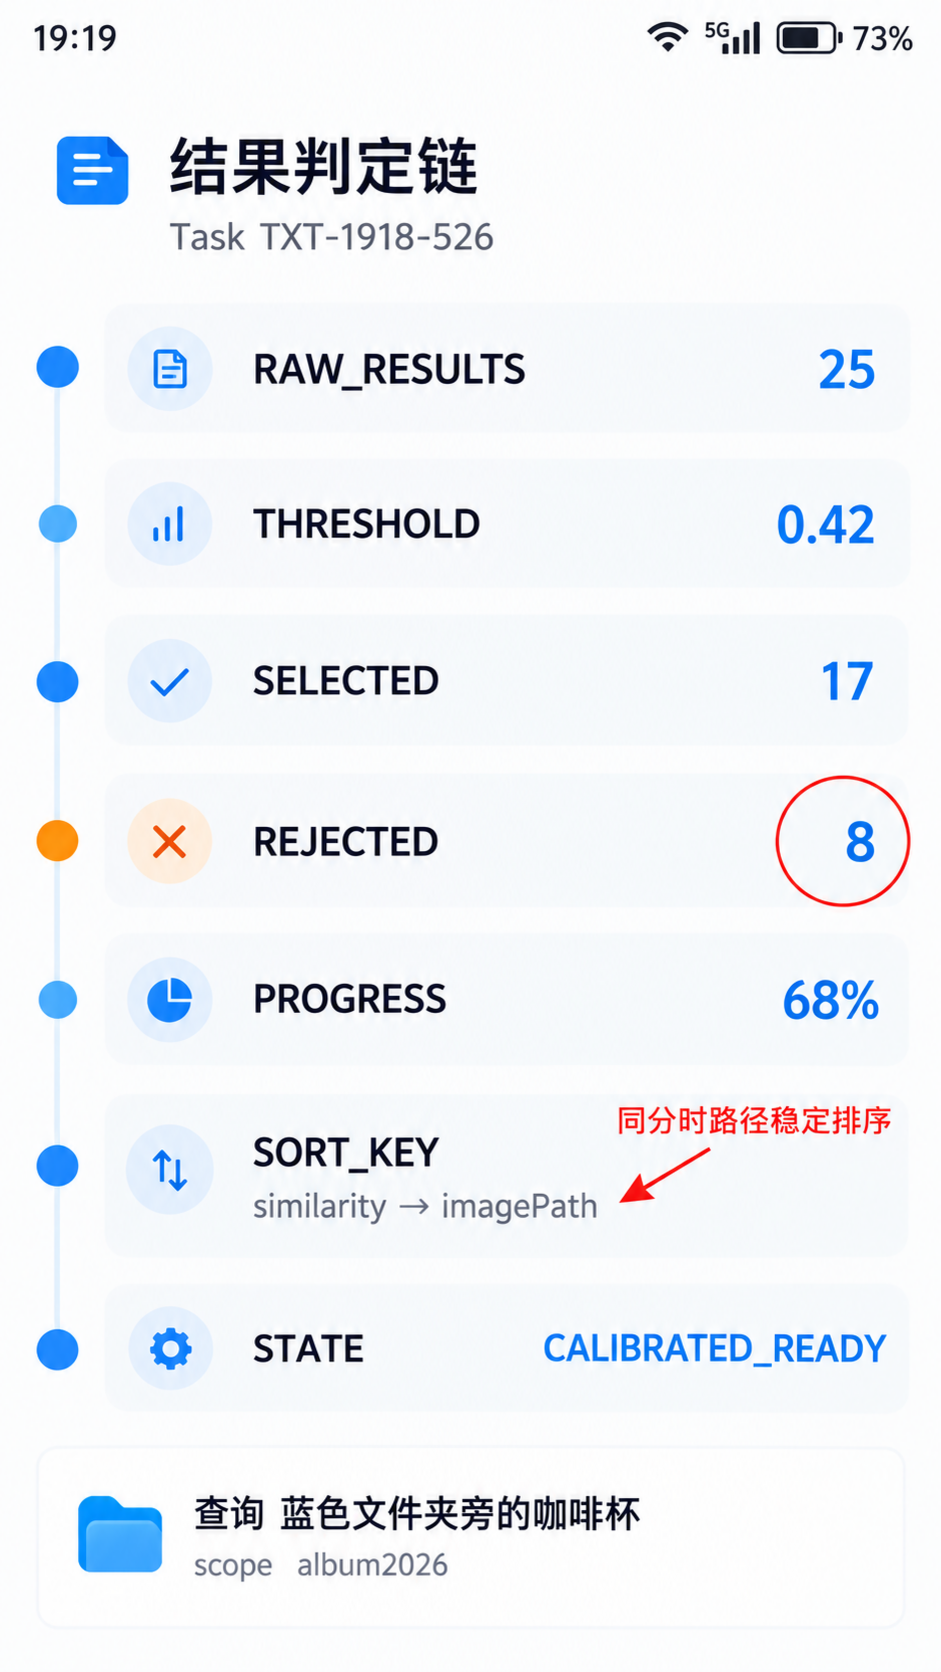
详情页把本次判定链完整展开:原始 25、门限 0.42、入选 17、拒绝 8、稳定排序键 similarity→imagePath,最终状态 CALIBRATED_READY。它与运行页不同,重点不是展示照片,而是解释一条结果为何留下。
七、这套实现的边界
第一,本文没有声称 0.42 适合所有应用。它只属于 album2026 这份演示样本。换模型、换图库、换查询分布都应重新校准。
第二,topKey=25 是演示选择,不是 API 的推荐上限。官方允许 0~100;值越大,应用层排序和缩略图准备的成本通常也越高,实际值要结合页面容量和设备验证决定。
第三,稳定排序只保证相同输入下的展示确定性,不改善模型相关性。要提升检索质量,仍需补足索引图片、优化查询表达和扩大标注样本。
第四,代次隔离不会取消系统搜索,只是阻止旧结果进入当前 UI。页面频繁触发时还需要输入防抖,防止无意义请求占用资源。
第五,本文的界面、时间、任务号和统计是配图演示契约。真实项目应在目标设备上验证 init/search/release、错误码、耗时和不同图库分布,再决定发布门限。
还有一个实际项目里很容易遗漏的边界:图库变化后,旧校准报告不能自动代表新数据。用户批量导入截图、删除旅行照片,或者索引范围从私人相册切到团队素材库,分数分布都可能改变。可以给校准文件同时绑定 scope、图库样本摘要和生成日期;摘要变化超过预算时,只提示“需要复核”,不要在运行时偷偷重算一个门限。门限属于可审查的发布配置,而不是页面为了填满卡片随手改变的动画参数。
无障碍文案也应与状态保持一致。严格命中可以朗读“找到 17 张相关图片”,降级结果则应明确提示“以下为相近内容”,空结果才使用“未找到”。若三种状态都写成同一句,视觉上做出的技术区分最终还是会在用户侧消失。
文搜图最难的部分往往不是调用 search(),而是承认“相关度”仍需要业务解释。把门限、样本版本、稳定排序和降级状态写进同一条日志,页面才不会把一次模型输出包装成毫无依据的确定答案。
参考资料:
- Huawei Core Vision Kit:
textSearchImageArkTS API(API 26,包含ImageObject.similarity、查询参数与错误码) - Huawei Core Vision Kit:通过文本搜索图片开发指南(初始化、检索、删除与释放流程)
讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献320条内容

所有评论(0)