HarmonyOS 7 Spatial Recon:3DGS热滞回暂停与会话复位
端侧 3DGS 重建把持续计算、图像处理和模型写入压在一段较长的会话里。只看进度条时,最直觉的做法是让任务一路跑完;可设备热等级上升、应用切到后台时,继续按前台策略争抢资源,通常不是一个好选择。更隐蔽的问题是温度刚降一点就恢复、刚升一点又暂停,任务会在边界附近反复抖动。
这篇文章用 ThermalReconLab 讨论一个热治理 Demo。ArkTS 页面是 ThermalGuardPage,Native 协调器是 recon_governor.cpp。任务号 RECON-1624-608,会话 S-608,演示时间 16:24,当前阶段 OPTIMIZING,进度 68%。内部热信号为 5 时进入 THERMAL_PAUSED,恢复阈值为 3,还要连续稳定 30 秒并处于前台。这里的等级与阈值是 Demo 规则,不冒充所有设备的统一温度语义。
一、进度停在 68%,先别把它当成卡死
Spatial Recon Kit 提供 3DGS 空间重建会话。当前文档中,HMS_SpatialRecon_PauseSession 可以暂停正在进行的会话,HMS_SpatialRecon_ResumeSession 可以恢复暂停会话,HMS_SpatialRecon_SetRunningMode 用于设置前台或后台运行模式。运行模式必须在 StartSession 之后、重建完成之前设置;对非活动会话调用不会产生预期效果。
系统还定义了 COMMON_EVENT_THERMAL_LEVEL_CHANGED 公共事件,用于通知设备热等级发生变化。事件只是信号源,不应该直接等同于业务状态。工程仍要处理会话是否活动、是否已经暂停、应用是否在前台、用户是否主动取消,以及上一次操作是否成功。
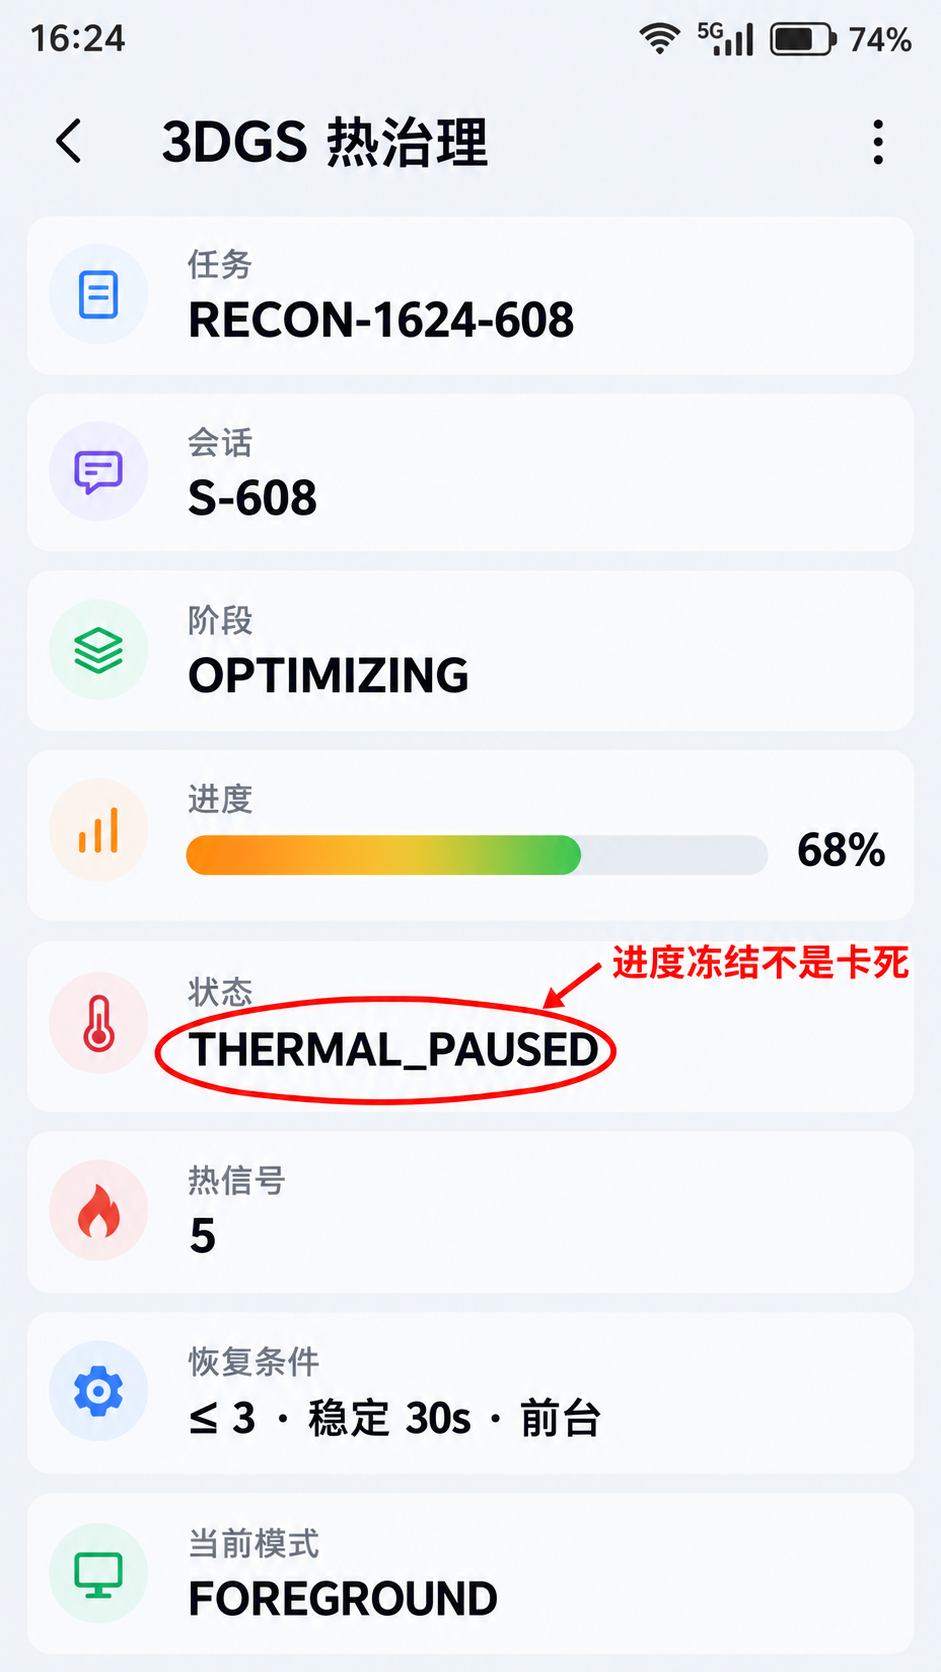
Demo 把热治理状态定义为:RUNNING_FOREGROUND、RUNNING_BACKGROUND、PAUSE_REQUESTED、THERMAL_PAUSED、COOLING_STABLE、RESUME_REQUESTED、COMPLETED、FAILED。页面显示 68% 时可能处于 THERMAL_PAUSED,这不是卡死,而是协调器主动冻结会话并等待稳定恢复条件。
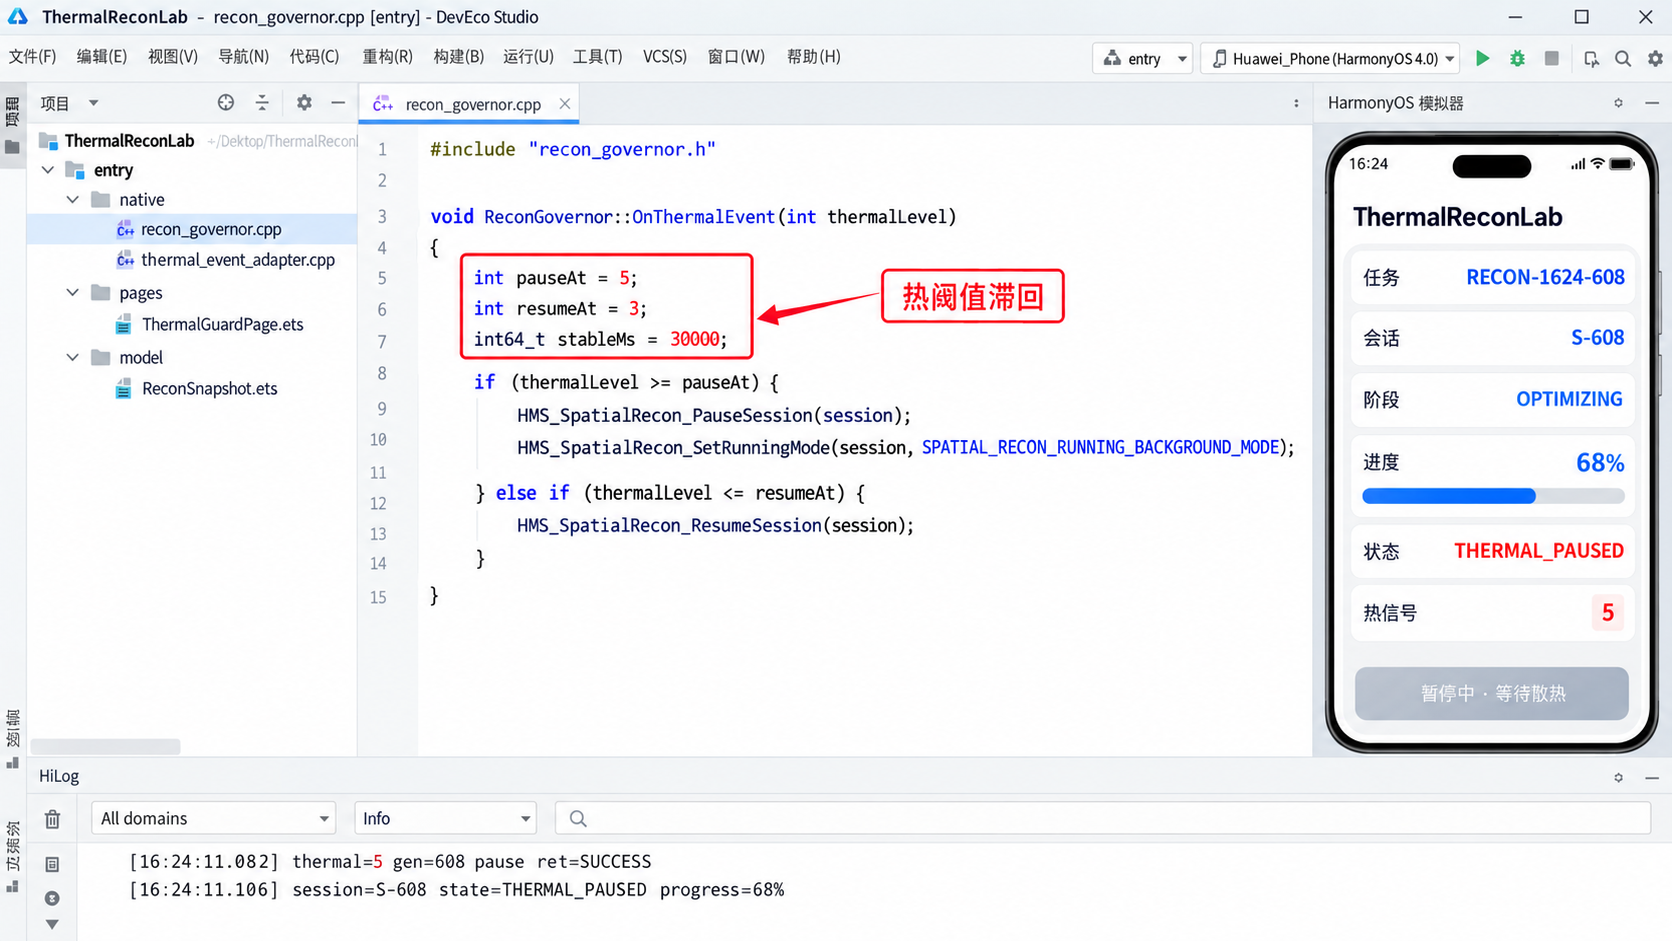
阈值不直接绑定系统常量。平台适配层负责把当前设备、当前 SDK 的热事件解析成 ThermalSignal,协调器只消费内部等级。示例使用 pauseAt=5、resumeAt=3,目的是演示滞回:暂停阈值高于恢复阈值,避免在同一条线附近来回切换。真实值应结合设备、业务负载和官方热等级说明验证。
二、暂停与恢复必须围绕同一个活动会话
下面代码解决热事件到达时会话可能已经完成或销毁的问题。协调器持有 session、generation 与明确状态。只有活动代次、运行态且等级达到门槛时才调用暂停;返回成功后才进入 THERMAL_PAUSED。
#include "spatial/spatial_recon_interface.h"

struct ReconGovernor {
    HMS_SpatialRecon_Session* session = nullptr;
    int generation = 608;
    int pauseAt = 5;
    int resumeAt = 3;
    bool foreground = true;
    bool completed = false;
    bool thermalPaused = false;

    HMS_SpatialReconStatus OnThermalSignal(int level, int eventGeneration)
    {
        if (session == nullptr || completed || eventGeneration != generation) {
            return SPATIAL_RECON_STATUS_FAILED;
        }
        if (!thermalPaused && level >= pauseAt) {
            HMS_SpatialReconStatus ret =
                HMS_SpatialRecon_PauseSession(session);
            if (ret == SPATIAL_RECON_STATUS_SUCCESS) {
                thermalPaused = true;
            }
            return ret;
        }
        return SPATIAL_RECON_STATUS_SUCCESS;
    }
};
示例中的 OnThermalSignal 是业务适配函数,不是系统 API。系统事件的订阅和参数解析应封装在单独平台层,并通过已验证的数据结构传入。这样热事件字段发生变化时,不会把重建协调器一起改乱。文章没有臆造公共事件参数键,只依赖官方确认存在的事件名称和订阅能力。
eventGeneration 防止旧订阅把上一会话的热信号送进新会话。销毁 S-607 后若回调晚到,而 session 已指向 S-608,只检查指针非空就会暂停错误任务。代次让事件、会话和页面形成同一条时间线。
暂停返回值必须记录。不能先把 UI 改成 THERMAL_PAUSED,再忽略 Native 返回。如果会话已经完成、参数错误或底层拒绝,页面显示暂停而任务仍运行,会给热治理制造假安全感。状态变化应由调用结果驱动,并把返回码写入 HiLog。
三、应用退到后台时是降载,不一定要暂停
热暂停与前后台模式不是同一把开关。应用退到后台时,如果产品允许继续重建,可以调用 HMS_SpatialRecon_SetRunningMode 切换到后台模式,让系统按后台策略分配资源;回到前台再切回前台模式。若已经因为过热暂停,切换运行模式也不能自动替代 Resume。
下面代码解决生命周期回调重复到达和完成后仍切模式的问题。它只在活动会话中调用,并把前后台状态作为恢复条件的一部分。
HMS_SpatialReconStatus ReconGovernor::SetForeground(bool value)
{
    foreground = value;
    if (session == nullptr || completed) {
        return SPATIAL_RECON_STATUS_FAILED;
    }
    HMS_SpatialReconRunningMode mode = value
        ? SPATIAL_RECON_RUNNING_FOREGROUND_MODE
        : SPATIAL_RECON_RUNNING_BACKGROUND_MODE;
    HMS_SpatialReconStatus ret =
        HMS_SpatialRecon_SetRunningMode(session, mode);
    return ret;
}
这段调用的时机有严格边界:必须在 HMS_SpatialRecon_StartSession() 之后、重建完成之前。把它放在 Ability 生命周期回调里并不意味着每次都能调用,生命周期只是输入,协调器还要检查会话状态。应用刚启动但会话未开始时,只保存期望模式;会话启动成功后再应用。
退到后台是否继续,是产品决策。需要用户持续观察的采集阶段可以暂停;纯计算阶段可能允许后台降载。本文 Demo 在 OPTIMIZING 阶段选择后台模式,不直接暂停;但如果热等级达到 5,热策略优先,仍进入 THERMAL_PAUSED。
工程目录将公共事件适配放在 native/thermal_event_adapter.cpp,会话治理放在 native/recon_governor.cpp,ArkTS 只订阅桥接后的不可变快照。下面的 DevEco Studio 风格图是基于本文数据生成的说明图,右侧模拟器展示 68% 与暂停状态,底部 HiLog 显示热信号、暂停返回值和代次;它不是实际性能测试截图。
四、恢复不看一次降温,而看一段稳定窗口
最简单的恢复判断是 level <= resumeAt 就调用 Resume。设备在边界附近波动时,这会形成 Pause/Resume 抖动。Demo 增加 30 秒稳定窗口:第一次进入恢复区只记录时间;期间任何一次超过恢复阈值都清零;稳定期满、应用在前台、用户未取消,才允许恢复。
#include <cstdint>

HMS_SpatialReconStatus ReconGovernor::TryResume(
    int level, int eventGeneration, int64_t nowMs, int64_t& coolSinceMs)
{
    if (session == nullptr || completed || eventGeneration != generation) {
        return SPATIAL_RECON_STATUS_FAILED;
    }
    if (!thermalPaused) return SPATIAL_RECON_STATUS_SUCCESS;
    if (level > resumeAt) {
        coolSinceMs = -1;
        return SPATIAL_RECON_STATUS_SUCCESS;
    }
    if (coolSinceMs < 0) {
        coolSinceMs = nowMs;
        return SPATIAL_RECON_STATUS_SUCCESS;
    }
    if (!foreground || nowMs - coolSinceMs < 30000) {
        return SPATIAL_RECON_STATUS_SUCCESS;
    }
    HMS_SpatialReconStatus ret = HMS_SpatialRecon_ResumeSession(session);
    if (ret == SPATIAL_RECON_STATUS_SUCCESS) {
        thermalPaused = false;
        coolSinceMs = -1;
    }
    return ret;
}
30 秒只是 Demo 规则,不是系统规定。关键是把恢复阈值、稳定时长和前台资格显式化。这样测试可以注入时间,不需要真的等设备冷却,也能验证 5 -> 3 -> 4 -> 3 会重置窗口,而 5 -> 3 持续 30 秒后才恢复。
恢复调用失败时仍保持 thermalPaused=true,不能因为“尝试过”就修改 UI。下一次是否允许重试还要看错误类型与会话状态。若任务已经完成,应该进入完成收口;若会话句柄失效,应转 FAILED 并禁止继续调用,而不是每个热事件都撞一次失效指针。
手机运行图停在 THERMAL_PAUSED,显示任务 RECON-1624-608、会话 S-608、阶段 OPTIMIZING、热信号 5、进度 68%。红色标注说明“进度冻结不是卡死”。页面还显示恢复条件:热信号不高于 3、稳定 30 秒、应用回到前台。
五、订阅与会话销毁要按顺序收口
公共事件采用发布订阅模型。无论使用 ArkTS 还是 C API,订阅与取消订阅都必须成对。Demo 在会话启动并确认支持后才开启热事件监听;结束流程先把协调器标记为 completed,使迟到回调失效,再取消订阅,最后销毁会话。
为什么先标记完成?因为取消订阅和已经进入队列的回调之间可能存在竞态。只依赖“取消成功”无法证明没有回调正在执行。完成标志和代次校验是业务层栅栏,取消订阅是资源层收口,两层都需要。
销毁顺序还要避开正在执行的暂停或恢复调用。可用串行执行器把 Start、SetRunningMode、Pause、Resume、Destroy 排进同一队列,确保一个会话同一时刻只有一项控制操作。Spatial Recon 本身也强调会话互斥,工程层不要再制造并行控制。
进度查询与暂停状态也要对账。暂停后页面可以保留最后一次有效进度 68%,但不要继续伪造增长。恢复成功后再允许新的进度快照覆盖。若最终保存模型,还要把保存阶段与重建阶段分开记录,不能把输出文件写入等待当成重建仍在计算。
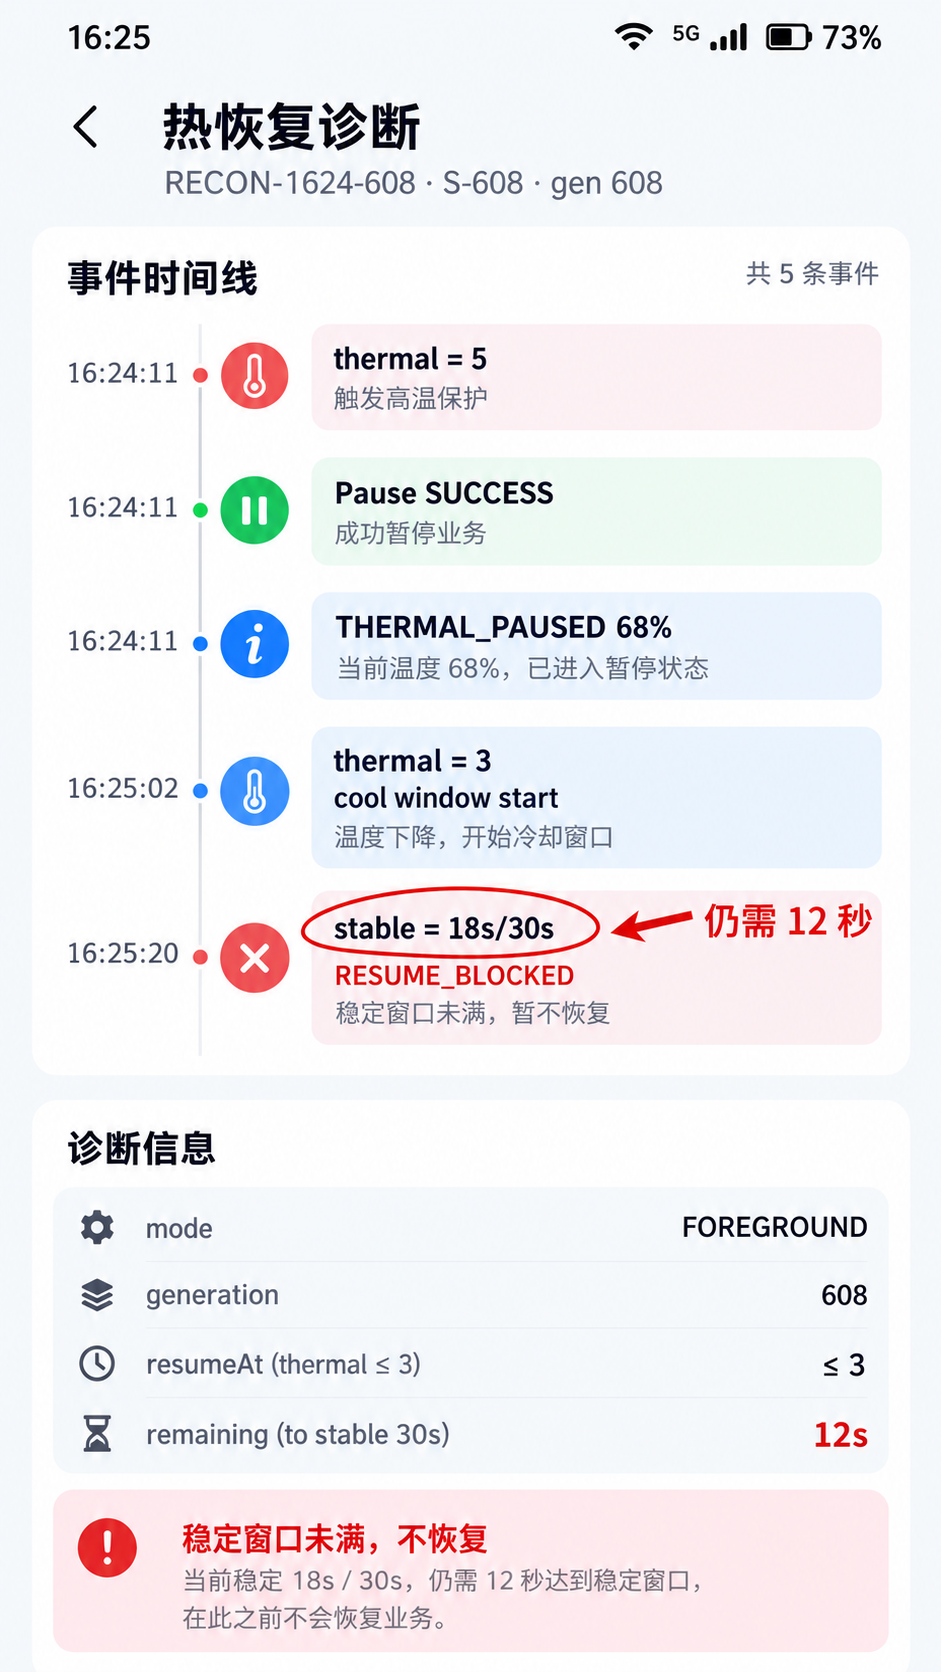
诊断图与运行图承担不同作用。它展示热事件时间线:等级 5 到达、Pause 返回成功、进入暂停、等级 3 开始冷却计时、因尚未达到 30 秒而拒绝恢复。红圈标出“stable=18s/30s”,解释为什么页面仍停在 68%。
六、如何验证热治理不是另一套随机状态机
第一组测试注入 4 -> 5,期望只调用一次 Pause,重复的 5 不重复调用。第二组注入 5 -> 3 并推进虚拟时间 18 秒,期望保持暂停;推进到 30 秒且前台为 true,才调用一次 Resume。第三组在冷却 20 秒时注入 4,计时清零。
第四组测试前后台:运行态进入后台只切 BACKGROUND_MODE;热暂停态进入后台不恢复;冷却满 30 秒但仍在后台,也不恢复。第五组在完成回调后注入热事件,协调器应以 completed 拒绝,不再触碰会话。
还要验证订阅生命周期。重复进入页面不能创建两个热监听;结束会话后订阅者必须释放;上一代 generation=607 的事件不能影响 S-608。HiLog 至少包含任务号、会话号、代次、输入热等级、旧状态、新状态、Native 返回码和进度快照。
真正的设备测试不能被模拟器代替。官方资料提示 Spatial Recon 对设备能力有要求,开发前应调用支持性检查;正式验收要在符合要求的真机上完成,并以目标版本文档为准。本文图片是演示界面,只验证文图数据一致,不证明真实热曲线或重建性能。
七、把热策略写成“允许恢复的证据”
热事件到达时立即暂停很容易,困难的是证明什么时候可以安全恢复。低于阈值、稳定足够久、应用在前台、会话仍活动、用户未取消,这些条件缺一不可。把它们写成显式门禁,恢复就不再靠单个回调里的冲动判断。
前后台模式切换与热暂停也必须分层。后台降载是资源调度策略,热暂停是会话控制;二者可以同时存在,却不能互相冒充。页面只显示最后一次成功的系统操作,失败调用保留原状态。
RECON-1624-608 在 68% 停住,是一条可解释的主动决策:热信号达到 5,Pause 成功,稳定冷却只有 18 秒,还没有满足 30 秒恢复窗口。比起一条不断跳动却无法解释的进度条,这份证据更值得交付给调试和验收团队。
参考资料:
讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)