ArkUI+Node.js:多语言资源键漂移与占位符一致性校验【鸿蒙心迹】
技术栈:HarmonyOS ArkUI、resources/element、Node.js、JSON 资源检查
有些发布风险不会在中文页面上直接出现。开发时默认语言一切正常,切到英文后,某个确认按钮突然退回中文;另一个提示虽然显示英文,却把订单号插入了错误位置。只靠人工翻一遍页面很容易遗漏,尤其当项目同时维护 base、zh_CN 和 en_US 资源时,语言包里的资源键不一致会随着迭代逐渐累积。
这次换个思路,不把上架前检查寄托在逐张截图上,而是给资源文件加一层构建前静态门禁。演示项目叫 LocaleGuard,追踪编号为 L10N-042。假定基准资源有 36 个键,需要检查两套地区资源;示例故意安排 en_US 少一个 order_tip,并让 payment_count 的占位符类型与基准不一致。预期报告是 BLOCKED、缺失键 1、占位符差异 1。这里的数量均为演示输入设定,不是已经运行过项目得到的检查报告。
一、先定一个真正可执行的检查范围
多语言资源不等于“找不到翻译就一定崩溃”。HarmonyOS 会根据资源目录和匹配规则选择合适的资源,某个限定目录缺少条目时可能出现资源回退。因此,页面还能显示文字,不能证明国际化完整;更不能把所有回退都视作错误。团队应自行明确哪些关键文案必须在目标语言中存在,哪些品牌名或术语可以复用基准资源。
当前方案只检查三项:资源键是否覆盖、同名占位符的数量与类型是否一致、同一语言包内部是否存在重复键。它不尝试自动评估翻译是否自然,也不声称可以替代专业语言审校。涉及金额、日期、复数或从右到左布局的内容,仍然需要在真机或真实设备环境里验证。
项目目录约定为 entry/src/main/resources/base/element/string.json、zh_CN/element/string.json、en_US/element/string.json。每个文件使用资源数组,数组元素包含 name 和 value。由于我们只读取资源源文件,执行程序不必连接模拟器,也不需要发明新的 HarmonyOS SDK 接口。
1. 把失败定义成能复核的问题单
本次把 base 看作键集合的基线;zh_CN 和 en_US 是待核对目录。若目标语言缺少 order_tip,记录 MISSING;若 payment_count 从 %d 变成 %s,记录 PLACEHOLDER。当出现任意阻断性问题时,构建前审计脚本返回非零退出码。它只是团队 CI 规则,并不是华为应用市场公开定义的审核处罚或审核通过标准。
二、读取资源之前,先防止检查器自己漏报
首先解决资源格式读取和重复资源键问题。常见的偷懒写法是直接用 Object.fromEntries 建表,碰到同名键时后一个值覆盖前一个值,最后检查器甚至不知道原文件有重复。下面把重复作为明确的问题项返回,并保留输入路径便于定位。
// tools/locale-utils.mjs 运行环境:Node.js
import { readFileSync } from 'node:fs';

export function loadStrings(path) {
  const source = JSON.parse(readFileSync(path, 'utf8'));
  if (!Array.isArray(source.string)) {
    throw new Error(`INVALID_FORMAT:${path}`);
  }
  const values = new Map();
  const duplicates = [];
  for (const row of source.string) {
    if (typeof row.name !== 'string' || typeof row.value !== 'string') {
      throw new Error(`INVALID_ITEM:${path}`);
    }
    if (values.has(row.name)) duplicates.push(row.name);
    else values.set(row.name, row.value);
  }
  return { values, duplicates };
}

export function signature(value) {
  return (value.match(/%(?:[1-9][0-9]*\$)?[sd]/g) ?? [])
    .sort().join('|');
}
Map 的职责是保存原始键与值,duplicates 单独累计重复项;格式异常则直接抛出,让 CI 将文件列为不可检验,而不是装作该语言没有问题。signature 只识别示例约定使用的 %s、%d 及位置编号格式,它不是一个覆盖全部本地化语法的万能解析器。若项目使用不同的占位约定,应扩展扫描规则并增加单元测试。
有一处工程取舍需要写清楚:排序后的占位符签名只能发现类型与数量差异,不能校验句子的语义顺序。对允许位置参数重排的语言,简单比较出现顺序会误报;对不允许重排的自定义格式,单纯排序又会漏报。本文把这个问题留给格式规范层,不在资源门禁里偷偷做语言学判断。
三、让差异输出稳定,而不是只打印一句失败
第二段代码负责两套地区资源与基准的对照,并把结果归入机器可识别的错误类别。路径列表由团队自己维护,检查程序不会擅自猜测有哪些地区参与正式上架。
// tools/verify-locales.mjs
import { loadStrings, signature } from './locale-utils.mjs';

const root = 'entry/src/main/resources';
const base = loadStrings(`${root}/base/element/string.json`);
const targets = ['zh_CN', 'en_US'];
const issues = base.duplicates.map(k => `DUPLICATE:base.${k}`);
for (const locale of targets) {
  const current = loadStrings(`${root}/${locale}/element/string.json`);
  for (const k of current.duplicates) issues.push(`DUPLICATE:${locale}.${k}`);
  for (const [key, value] of base.values) {
    const translated = current.values.get(key);
    if (translated === undefined) {
      issues.push(`MISSING:${locale}.${key}`);
    } else if (signature(translated) !== signature(value)) {
      issues.push(`PLACEHOLDER:${locale}.${key}`);
    }
  }
  for (const key of current.values.keys()) {
    if (!base.values.has(key)) issues.push(`EXTRA:${locale}.${key}`);
  }
}
issues.sort();
console.log(`LocaleGuard L10N-042 keys=${base.values.size} locales=${targets.length}`);
for (const issue of issues) console.log(issue);
console.log(issues.length ? 'BLOCKED' : 'PASS');
if (issues.length) process.exitCode = 1;
它不会删除、改写任何资源文件,扫描结束后只返回报告。process.exitCode = 1 适合放到构建流水线前置步骤;但前提是项目自己的流水线确实把这条命令列为必要检查。示例中用 EXTRA 作为阻断项,是团队选择,不代表多出资源键必然导致平台审核失败。
如果某个 JSON 无法解析,Node.js 会抛出异常并以失败状态退出,这反而是正确行为:数据不可信时应停止比较。将来资源规模变大,可以增加白名单配置、错误详情的 JSON 导出和按语言统计;但第一版最好先保持规则可解释,不要一口气引入机器翻译或复杂的语义模型。
四、页面样式检查仍然不能省
静态门禁只能告诉我们资源是否对齐,不能验证文案长度、按钮换行和触控区域。在 ArkUI 页面中使用 $r('app.string.xxx') 引用资源,就可以依据系统配置选择匹配语言。下面的代码只展示待检查的关键订单卡片,不把 Node.js 的报告伪装成应用运行时自动生成的数据。
// pages/OrderPreview.ets
@Entry
@Component
struct OrderPreview {
  build() {
    Column({ space: 12 }) {
      Text($r('app.string.order_title'))
        .fontSize(24).fontWeight(FontWeight.Bold)
      Text($r('app.string.order_tip'))
        .fontSize(16).maxLines(3)
      Row() {
        Text($r('app.string.payment_count'))
          .maxLines(2)
      }.width('100%')
      Button($r('app.string.confirm_action'))
        .width('100%')
    }.width('100%').padding(20)
  }
}
请注意,这只是渲染层的引用示意。资源字符串如果含有动态参数,实际显示时还需要依据项目的占位符规范提供参数,不能因为代码片段省略了业务数量就认为动态格式已经验证。maxLines 可以限制文字占用的行数,却可能裁掉关键信息;是否需要滚动或自适应高度,要根据页面交互而定。
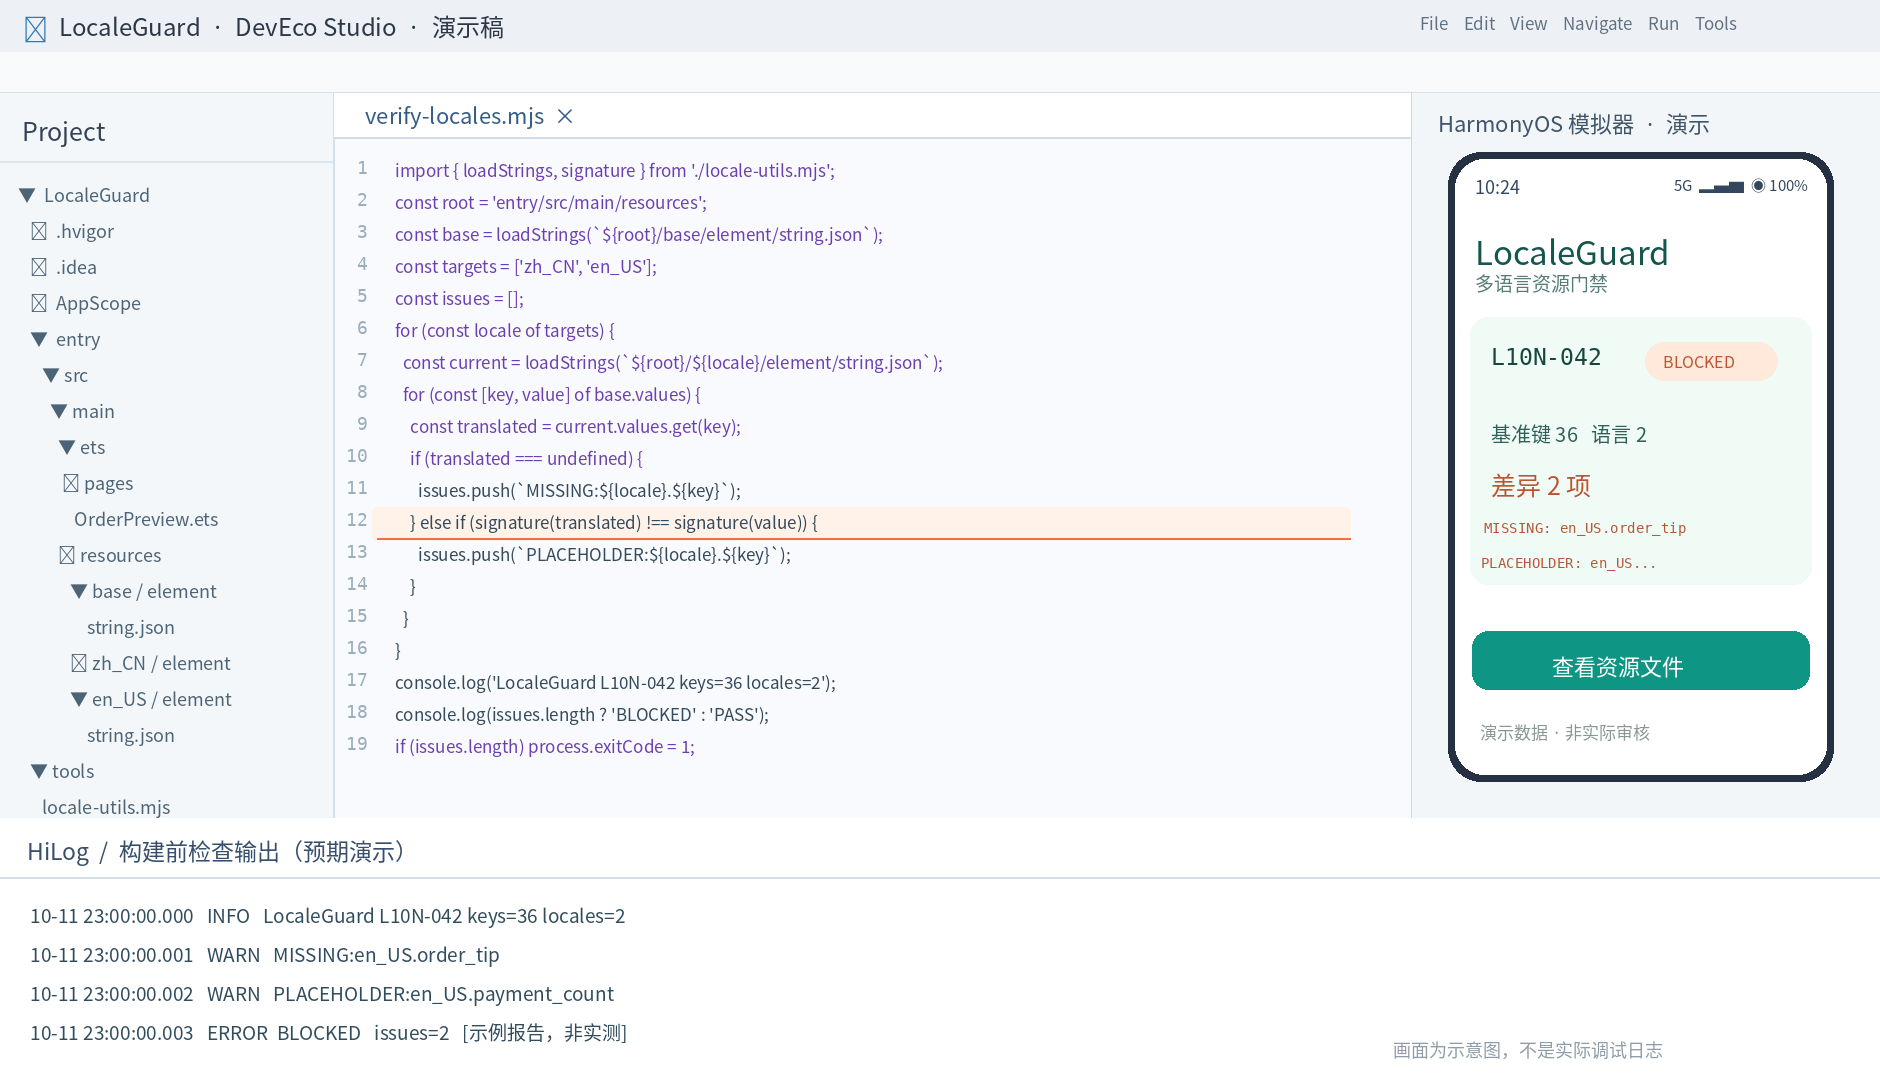
这张 DevEco 演示配图同时标出 order_tip 缺失与 payment_count 差异,底部日志表达的是预期门禁报告。我们特意没有写“已通过应用市场审核”,因为本篇讨论的是提交前的团队质量措施。将脚本跑进真实工程,才有资格把这些行称为实际扫描输出。
五、怎么组织一份不会误导人的演示报告
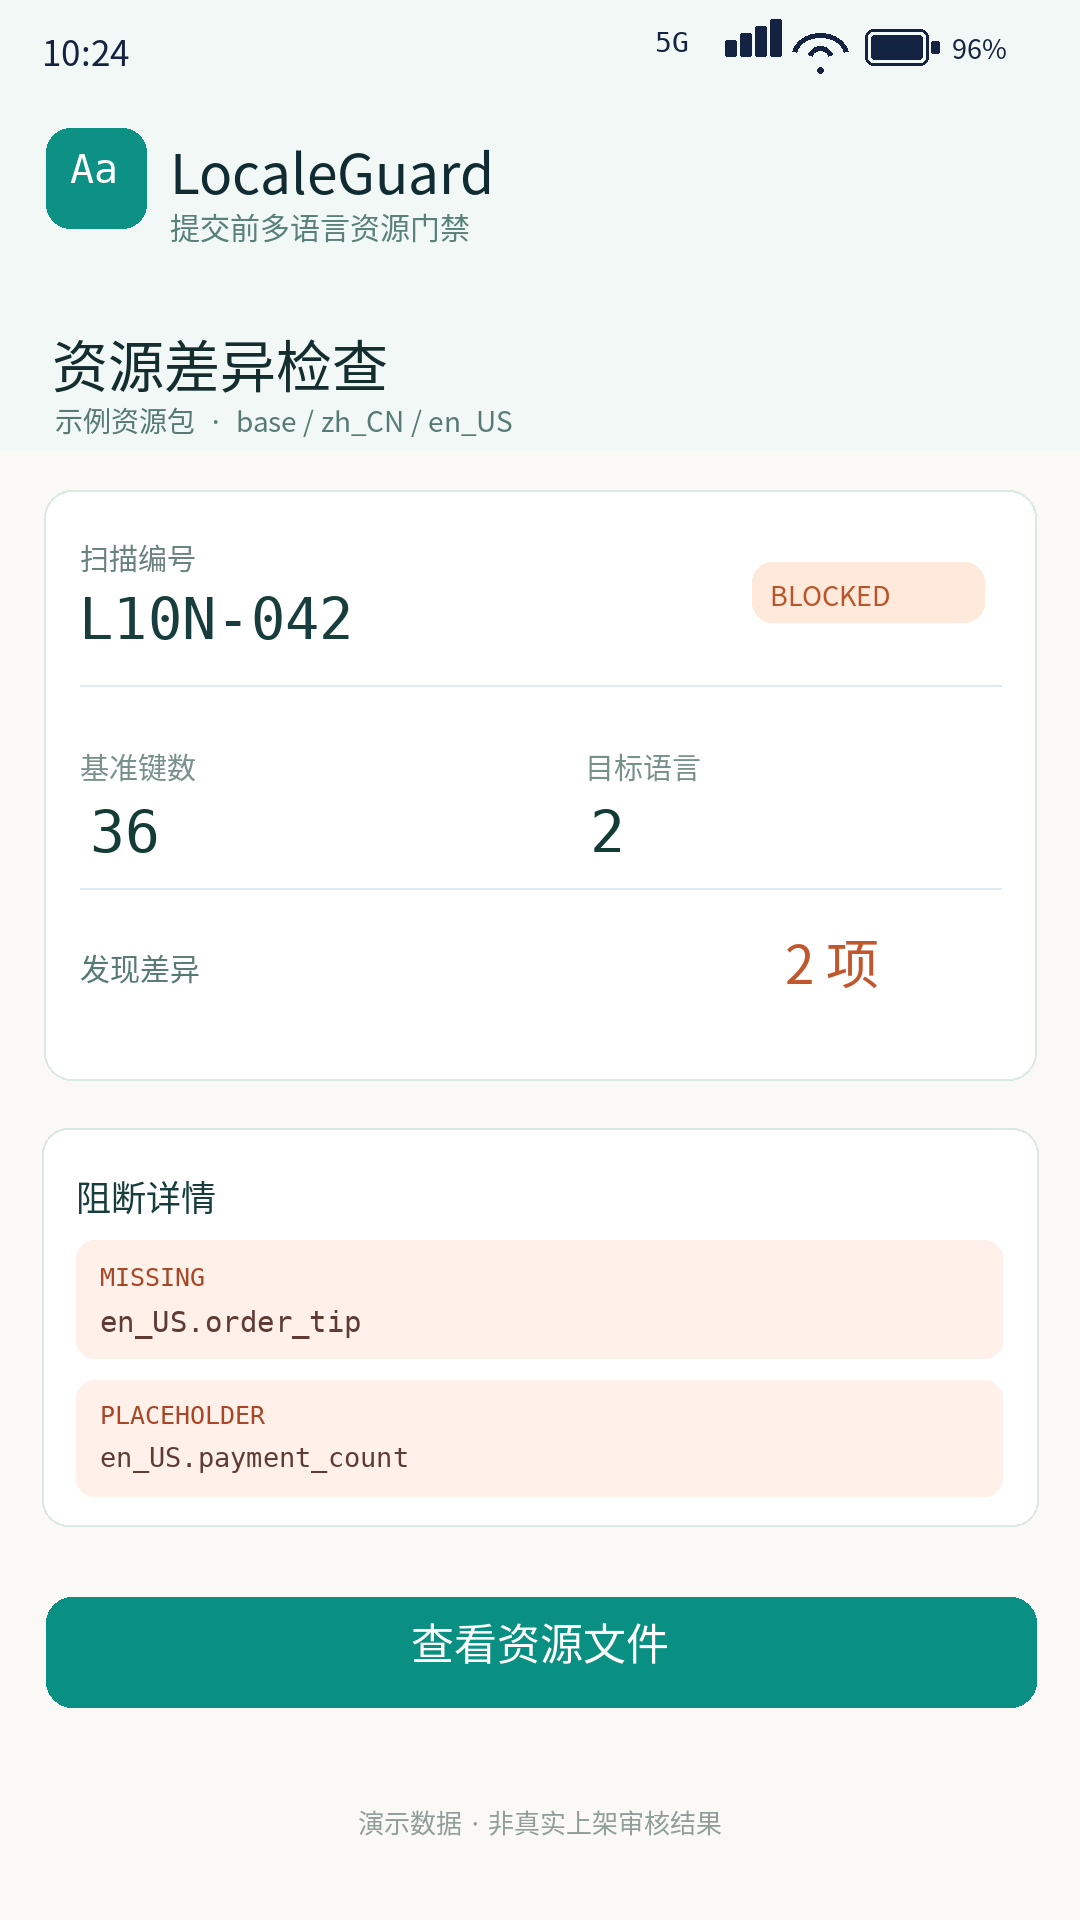
LocaleGuard 的本轮样例统一使用 L10N-042。基准键数假定 36,语言范围是 zh_CN 与 en_US;错误列表恰好有两行:MISSING:en_US.order_tip 和 PLACEHOLDER:en_US.payment_count。页面上应显示 BLOCKED、已检查 36 项、发现 2 项差异。如果未来改了演示输入,日志、配图、本文数字要一起更新,不能沿用旧截图。
实际验收建议分三层。第一层在每次提交时运行 Node 脚本,保证资源键和格式一致;第二层在 DevEco Studio 中切换多语言配置,检查关键业务页、弹窗、无障碍朗读文本与长文案;第三层结合目标地区、目标设备以及商店要求复核截图、隐私描述和法律文本。三层属于不同责任,静态门禁无法覆盖所有可能的翻译和发布问题。
如果临近发布,有人提出“让英文缺失项自动沿用中文就行”,团队至少应区分非关键描述与交易确认、权限解释等敏感文案。后者即使技术上能够回退,也未必构成合适的产品体验。可以设置有明确负责人和到期时间的例外清单,但例外不能无限期累积,否则脚本会退化成打印一堆大家都不看的黄色提示。
六、准确性的底线,是知道脚本没验证什么
这个方案不依赖未经证实的新 SDK,也没有调用应用市场私有审核接口。它检查的是开发者自己控制的 JSON 源文件,依据文件差异给出一个本地发布建议。HarmonyOS 的官方多语言资源机制涉及资源目录、限定词和匹配规则;我们在上面只实现了其中很小的一部分质量检测,没有覆盖资源选择的所有优先级。
后续若要扩展到复数资源、带单位的数值、图片资源和屏幕阅读器文本,应先查阅目标 SDK 的资源语法,再为每个类型建立测试样例。对占位符还可以增加格式数量、位置参数和转义百分号的独立用例,避免把文本中的百分比误识别成变量。中文英文都通过门禁,只意味着键和选定语法达标;它绝不代表界面已经没有截断、布局抖动或本地化歧义。
工程结论: 提交前把资源键漂移拦在 CI,比发布后从投诉里反推缺少哪个文案更可控。前提是规则足够小、异常可定位、团队能区分“静态检查通过”和“真实发布合格”。本例没有实际执行 DevEco 构建,也未进行应用市场审核,所有 UI 及日志数值都是约定好的模拟数据。
官方资料: 华为《提供多语言资源》说明资源目录配置及匹配规则,《文档中心》列有应用上架分发、测试与体验建议。示例脚本属于自主编写的工程检查逻辑,不是系统 API 或官方发布硬性要求。
- https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V13/l10n-multilingual-resources-V13
- https://developer.huawei.com/consumer/cn/doc/

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献403条内容

所有评论(0)