【共创稿事节】HarmonyOS 7 Agent 开发实战 04:云端 RAG 搭企业私有知识库问答
前三篇把云端大模型接进了 HarmonyOS 7(API 26),搭好了对话脚手架,也让模型学会了用 Tool Calling 查订单查库存。但企业落地还有一大块硬需求没解决:员工问"年假怎么申请"“报销单十五日内交还是十日内”,模型要么答不上,要么凭训练语料编一个"像那么回事"的答案——制度是你们公司定的,模型根本没见过,它答得越流畅越危险。
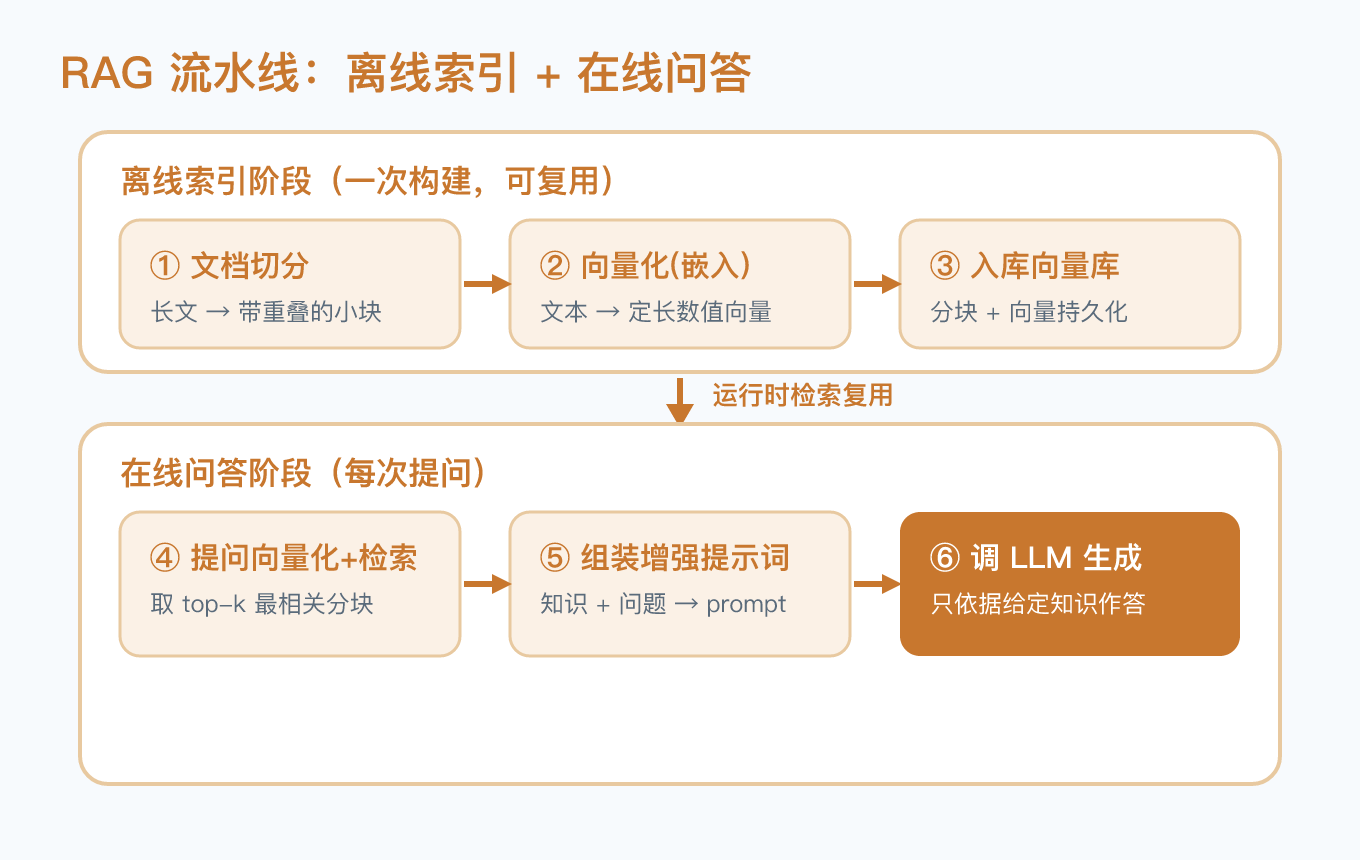
把公司制度文档做成企业私有知识库,让 AI 只凭库里的内容作答、答不出就明说,这就是 RAG(Retrieval-Augmented Generation,检索增强生成)要解决的问题。本篇在一个可开箱即跑的 DevEco 工程里把整条流水线落地:切分 → 向量化入库 → 余弦检索 top-k → 组装增强提示词 → 调云端大模型生成,纯逻辑全部配了不联网就能跑的 Hypium 单测。
一、RAG 到底解决了什么问题
没有 RAG 时,想让 AI 答对企业制度,常见两条歪路:
- 整本文档塞进提示词:每轮对话把制度全文拼进上下文。几十页文档轻轻松松顶爆上下文窗口,就算塞得下,token 费用也按轮次翻倍,而且绝大部分内容和当前问题毫无关系。
- 微调模型:拿制度文档去 fine-tune。成本高、更新慢,制度一改就得重训,而且微调不保证逐字准确——它改变的是"说话风格",不是"知识记忆"。
RAG 的思路完全不同:把"知识"放在模型外面。文档先切成小块向量化入库;用户提问时,先把问题也向量化,用相似度从库里捞回最相关的几段,把它们和问题一起组装成提示词,再让大模型只依据这几段生成回答。
这样模型每次只看"最相关的几段",窗口小、费用低,而且答案可追溯——页面上能直接展示"AI 依据了哪几段"。制度更新时只需重建索引,不动模型。
二、切块与向量化:splitIntoChunks 与 Embedder
第一步是把文档变成可检索的粒度。长文档切成带重叠的滑动窗口:窗口保证单块不超上下文预算,重叠保证跨界的句子不会被拦腰截断。
// feature/rag/RagAgent.ets(节选)
splitIntoChunks(text: string): string[] {
  const clean: string = text.replace(/\s+/g, ' ').trim();
  if (clean.length === 0) {
    return [];
  }
  if (clean.length <= this.window) {
    return [clean];
  }
  const chunks: string[] = [];
  let start = 0;
  while (start < clean.length) {
    const end: number = Math.min(start + this.window, clean.length);
    chunks.push(clean.substring(start, end));
    if (end === clean.length) {
      break;
    }
    start = end - this.overlap;   // 回退 overlap 字符,形成重叠
  }
  return chunks;
}
然后是向量化。生产环境应调用云端 Embedding 接口(盘古 / OpenAI 兼容网关的 /embeddings),本工程为了不联网就能跑通检索逻辑,内置了一个确定性向量化器:用语料的去重字符表当维度,统计字符词频再做 L2 归一化。
// feature/rag/Embedder.ets(节选)
export class VocabularyEmbedder implements Embedder {
  private readonly vocab: string[];
  readonly dim: number;

  constructor(vocab: string[]) {
    this.vocab = vocab;
    this.dim = vocab.length;
  }

  embed(text: string): number[] {
    const counts: number[] = new Array(this.dim).fill(0);
    for (let i = 0; i < text.length; i++) {
      const idx: number = this.vocab.indexOf(text[i]);
      if (idx >= 0) {
        counts[idx] = counts[idx] + 1;
      }
    }
    // L2 归一化,让余弦相似度可直接比较
    let norm = 0;
    for (const c of counts) { norm = norm + c * c; }
    norm = Math.sqrt(norm);
    if (norm === 0) {
      return counts;
    }
    const out: number[] = new Array(this.dim);
    for (let i = 0; i < counts.length; i++) {
      out[i] = counts[i] / norm;
    }
    return out;
  }
}
它当然比不了真 Embedding 模型的语义能力,但接口形态(embed(text): number[])与云端实现完全一致——单测和检索编排先在它上面跑绿,上生产时换掉实现即可,编排代码零改动。
三、向量库与余弦检索:top-k 怎么捞
相似度用余弦相似度:两个向量的夹角越小越相似,取值范围 [-1, 1],越接近 1 越相关。检索就是"问题向量和每个分块向量算一次余弦,按分数降序取前 k 个":
// feature/rag/VectorStore.ets(节选)
static cosine(a: number[], b: number[]): number {
  if (a.length !== b.length || a.length === 0) {
    return 0;
  }
  let dot = 0; let na = 0; let nb = 0;
  for (let i = 0; i < a.length; i++) {
    dot = dot + a[i] * b[i];
    na = na + a[i] * a[i];
    nb = nb + b[i] * b[i];
  }
  const denom = Math.sqrt(na) * Math.sqrt(nb);
  return denom === 0 ? 0 : dot / denom;
}

search(queryVec: number[], topK: number): RetrievedChunk[] {
  const scored: RetrievedChunk[] = [];
  for (let i = 0; i < this.chunks.length; i++) {
    const score: number = InMemoryVectorStore.cosine(queryVec, this.chunks[i].vector);
    scored.push(new RetrievedChunk(this.chunks[i], score));
  }
  scored.sort((x: RetrievedChunk, y: RetrievedChunk): number => y.score - x.score);
  const k: number = Math.min(topK, scored.length);
  const out: RetrievedChunk[] = [];
  for (let i = 0; i < k; i++) {
    out.push(scored[i]);
  }
  return out;
}
演示工程用内存实现。量级上来后换成云端向量检索服务或 Milvus / pgvector,方法签名保持一致,RagAgent 不用动。
四、编排成管线:RagAgent 三阶段
RagAgent 把三个阶段串起来:索引、检索、增强生成。
// feature/rag/RagAgent.ets(节选)
// 阶段一:切分 → 向量化 → 入库(一次构建,可复用)
indexDocuments(docs: RagDoc[]): void {
  for (let d = 0; d < docs.length; d++) {
    const parts: string[] = this.splitIntoChunks(docs[d].text);
    for (let p = 0; p < parts.length; p++) {
      const vec: number[] = this.embedder.embed(parts[p]);
      this.store.add(new Chunk(docs[d].id + '-' + d + '-' + p, parts[p], vec));
    }
  }
}

// 阶段二:检索
retrieve(query: string): RetrievedChunk[] {
  return this.store.search(this.embedder.embed(query), this.topK);
}

// 阶段三:组装增强提示词 → 调底座 → 返回答案与命中分块
async answer(query: string): Promise<{ text: string; hits: RetrievedChunk[] }> {
  const hits: RetrievedChunk[] = this.retrieve(query);
  const context: string = hits.map((h: RetrievedChunk): string => h.chunk.text).join('\n---\n');
  const prompt: string = '【知识库】\n' + context + '\n\n【问题】\n' + query;
  const resp: ChatResponse = await this.client.chat({
    model: this.model,
    messages: [
      { role: Role.SYSTEM, content: this.systemPrompt },
      { role: Role.USER, content: prompt }
    ]
  });
  return { text: resp.text, hits };
}
系统提示词是 RAG 可靠性的第一道闸门,默认值里写死了硬约束:“只能依据【知识库】中的内容作答,找不到相关内容就如实说明,严禁编造”。没有这句,模型很容易把检索结果当参考、"自由发挥"着补全答案——检索做得再准也白搭。
另一个细节:answer 把 hits(命中的分块和分数)一并返回,UI 层直接展示"AI 依据了哪几段知识"。可追溯是 RAG 相对微调最大的工程优势,别把它浪费掉。
五、页面串联与单测
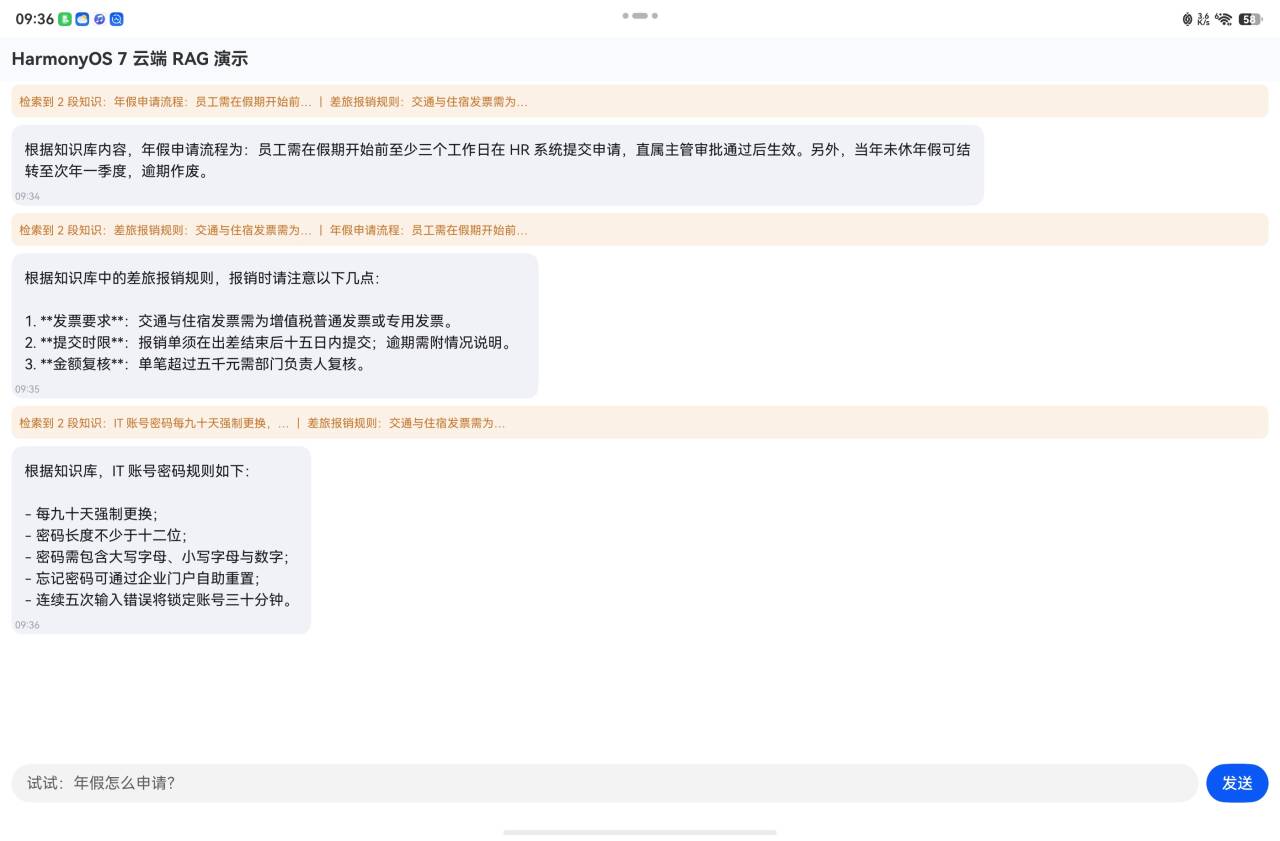
演示页内置三条企业制度语料(年假、报销、IT 密码),初始化时建好索引。每次提问,先以橙色提示条显示检索到的分块,再显示模型回答——用户能直接看见"答案从哪来",这比纯文字答案更能建立信任:
// pages/Index.ets(节选)
const result = await this.agent.answer(text);
const ctxTip: string = '检索到 ' + result.hits.length + ' 段知识:' +
  result.hits.map((h): string => h.chunk.text.substring(0, 16) + '…').join(' | ');
this.messages = [...this.messages,
  new ChatUIMessage(BubbleRole.SYSTEM, ctxTip, MsgStatus.DONE),
  new ChatUIMessage(BubbleRole.ASSISTANT, result.text, MsgStatus.DONE)];
单测覆盖四层:向量化器的确定性(同文本同向量、词表外字符忽略)、余弦相似度的数学性质(同向量为 1、正交为 0)、top-k 召回的正确性(相关分块必须排第一)、以及 RAG 全链路——用 Mock 客户端拦截请求,断言发给模型的用户消息里确实带上了命中知识片段和【知识库】标记,证明增强提示词组装无误。加上切分窗口、底座复用等用例,工程共 27 条断言,全部不发起网络请求。
六、跑起来:三步
- DevEco Studio 26 打开工程,右键
ohosTest → Run,确认 27 条断言全绿(也可先node verify-node.cjs在命令行验证纯逻辑)。 - 打开
pages/Index.ets,把buildAgent()里的baseUrl/apiKey/model换成自己的网关配置;docs换成你们的制度文档。 - 连真机运行,输入"年假怎么申请?",先看橙色提示条里检索到了什么,再看回答是否只依据这些片段。实际对话表现以真机实测为准。
V 哥真机测试效果图:
七、五个高频坑(接 RAG 前先看)
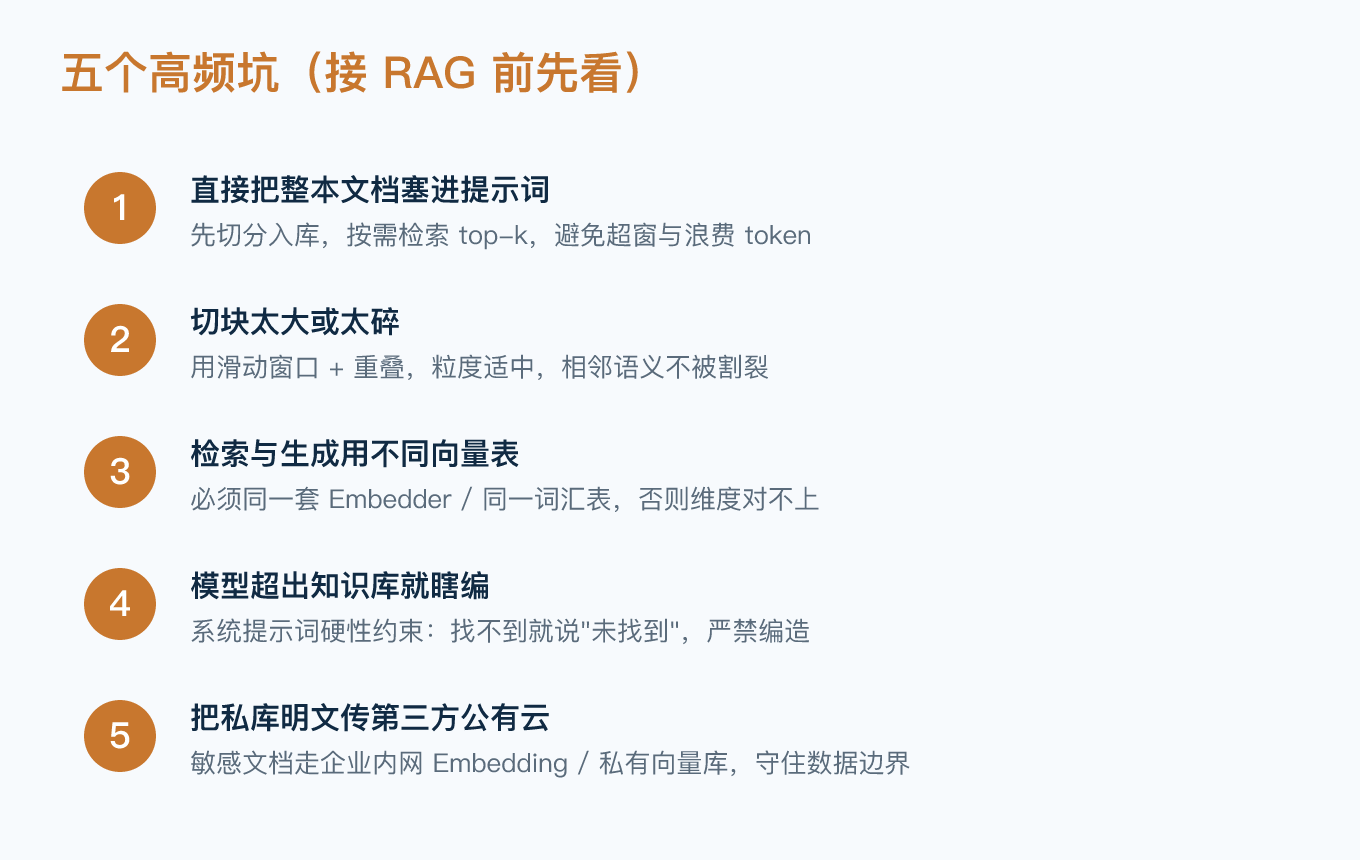
- 直接把整本文档塞进提示词:先切分入库、按需检索 top-k,别让上下文窗口和 token 费用一起爆炸。
- 切块太大或太碎:太大检索粒度粗、太碎语义割裂,用滑动窗口加重叠(工程默认 200/40)取中间值。
- 检索与生成用了不同向量表:索引和提问必须走同一套 Embedder、同一词汇表,否则维度对不上、相似度全是噪声。
- 模型超出知识库就瞎编:系统提示词必须写死"找不到就说未找到、严禁编造",并要求回答引用依据。
- 把私库明文传第三方公有云:敏感制度文档走企业内网 Embedding 服务和私有向量库,守住数据边界。
参考与出处
- 上篇《HarmonyOS 7 Agent 开发实战 03:Tool Calling 让 AI 查实时订单与库存》(本工程在其底座上扩展)
- 华为开发者官网 · NetworkKit(@ohos.net.http)、应用测试框架 Hypium
- OpenAI Embeddings API 规范(/embeddings 接口形态,盘古等兼容网关同构)
最后一句:RAG 不是给模型塞知识,而是教它先查再答——答案可以生成,事实必须检索,需要完整测试源码的兄弟私我。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献130条内容

所有评论(0)