用 HarmonyOS 开发助手和 Doubao-Seed-2.1-lite 做一个亲属称谓元服务
文章目录
前言
亲属称谓最容易出错的地方,不是某一层关系,而是关系链叠起来之后的歧义。例如“爸爸的姐姐的丈夫”“妈妈的哥哥的女儿”,每个词都认识,连起来却未必能马上得到准确称呼;换到粤语、客家话等方言环境,同一条关系又可能对应另一套叫法。
我做了一个《亲戚称谓宝典》元服务,支持正向计算、称谓反查、关系图谱、五种称谓模式、历史收藏和多尺寸万能卡片。家庭关系只在端侧计算,不需要上传服务器。本文重点讲两件事:如何在 HarmonyOS 开发助手中接入火山方舟的 Doubao-Seed-2.1-lite,以及如何通过项目规划把称谓算法落成可维护的 ArkTS 工程。
项目概览
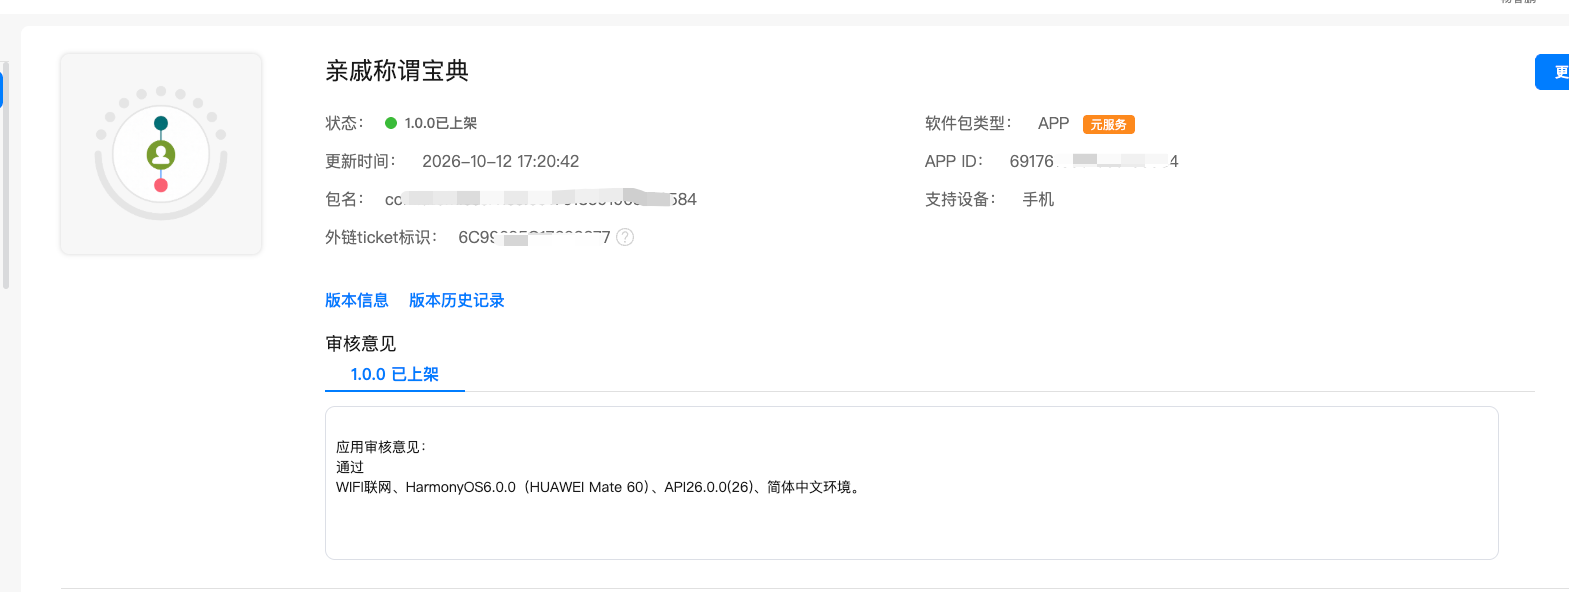
《亲戚称谓宝典》目前已发布到 AGC 元服务市场,HarmonyOS 7 用户可以直接体验。相比需要下载安装完整应用的方案,元服务更适合这类低频但有明确需求的小工具:用户在需要确认称谓时可以快速进入,用完即可退出。
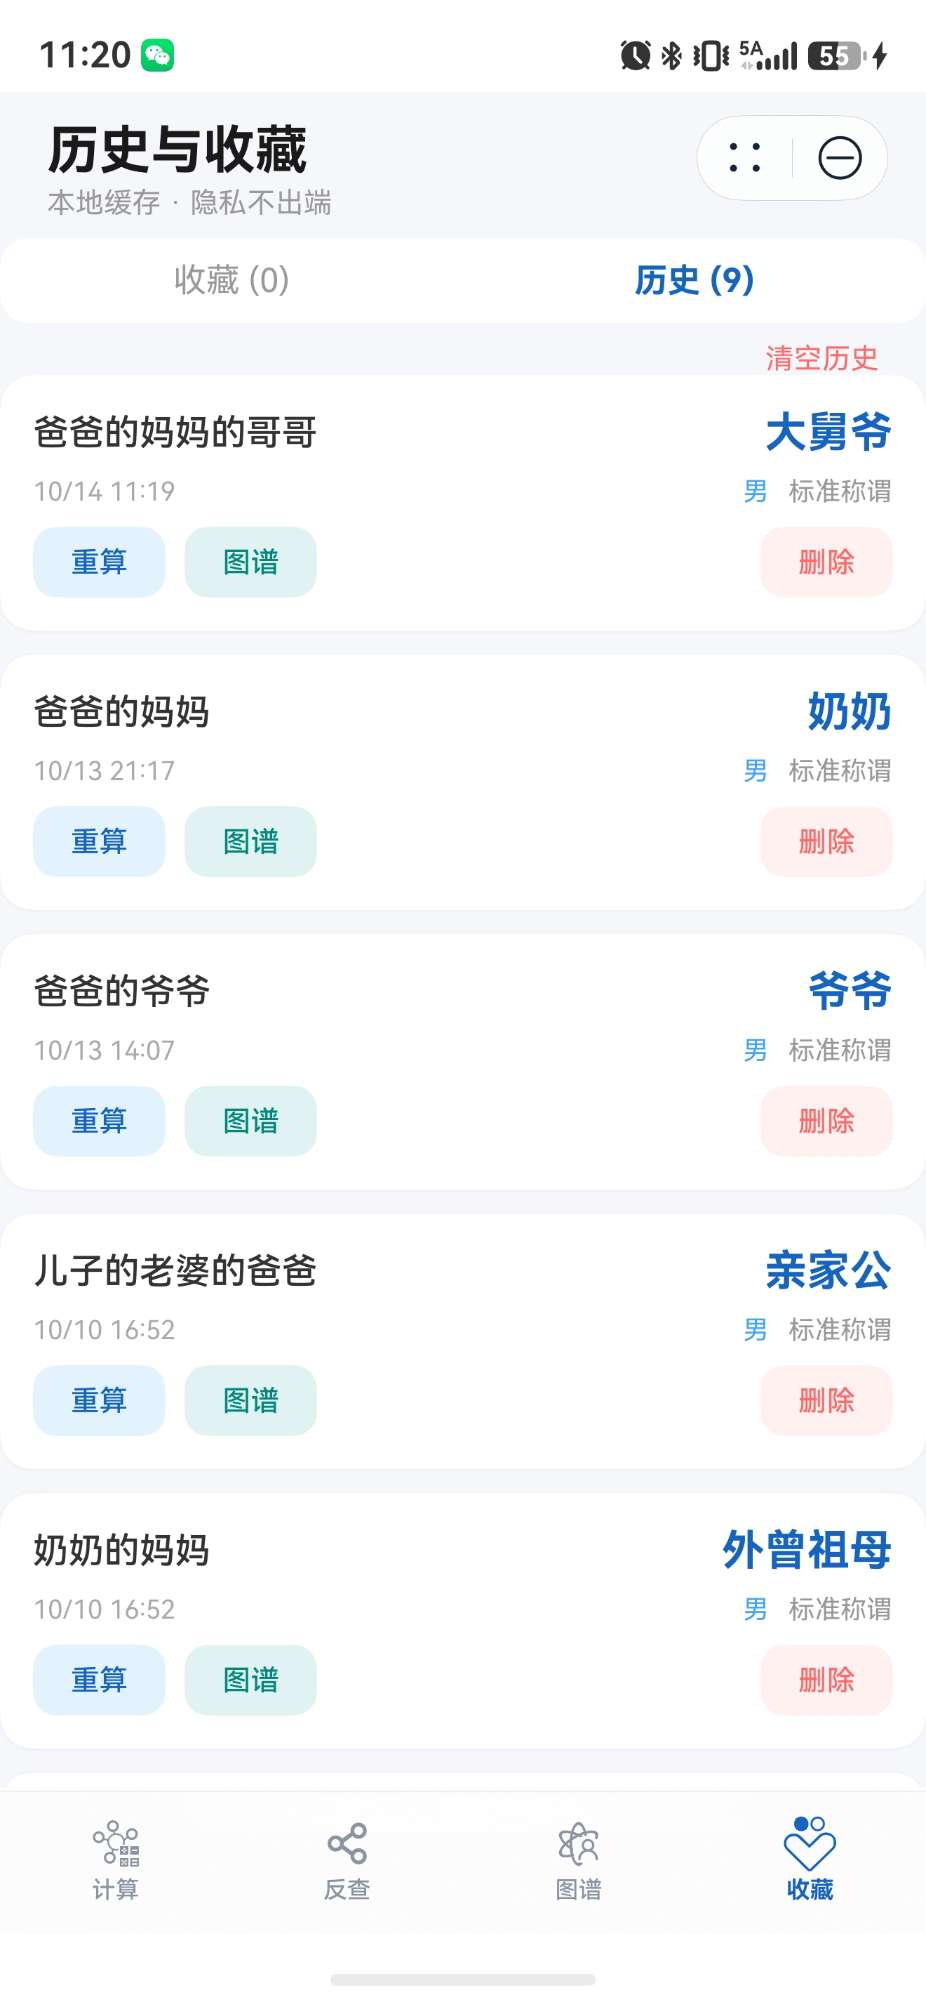
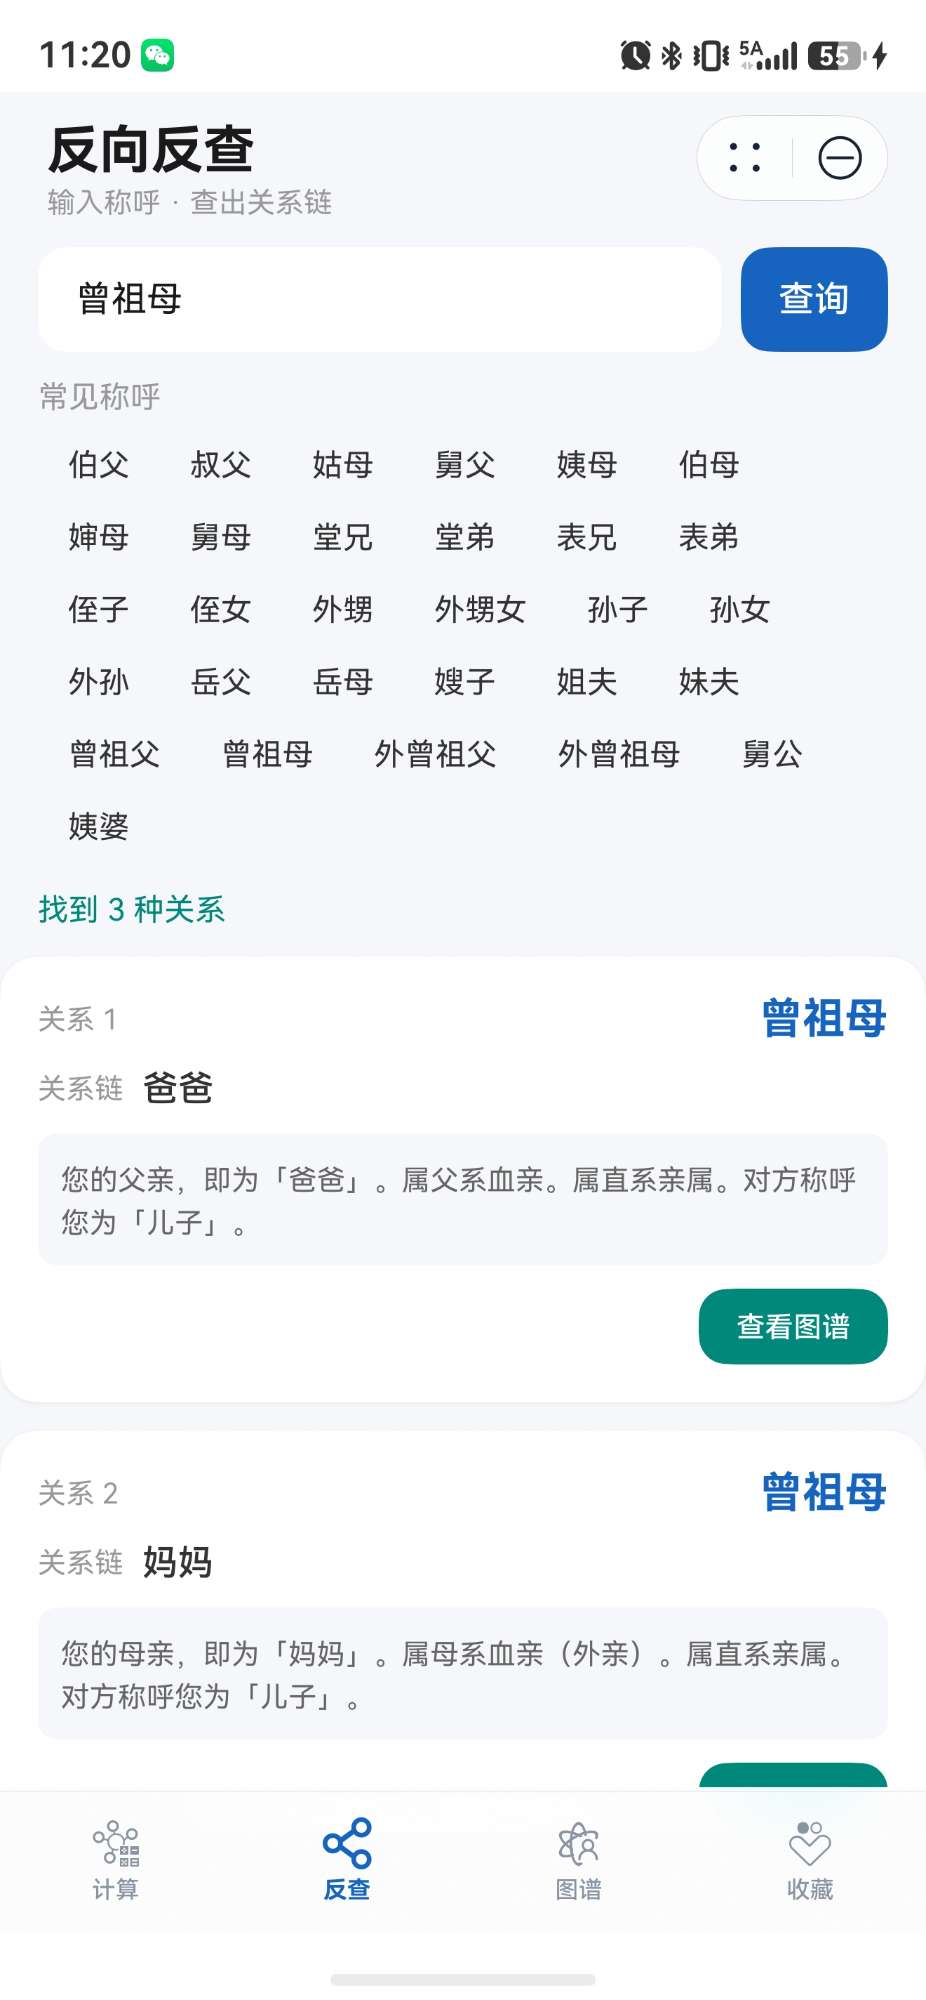
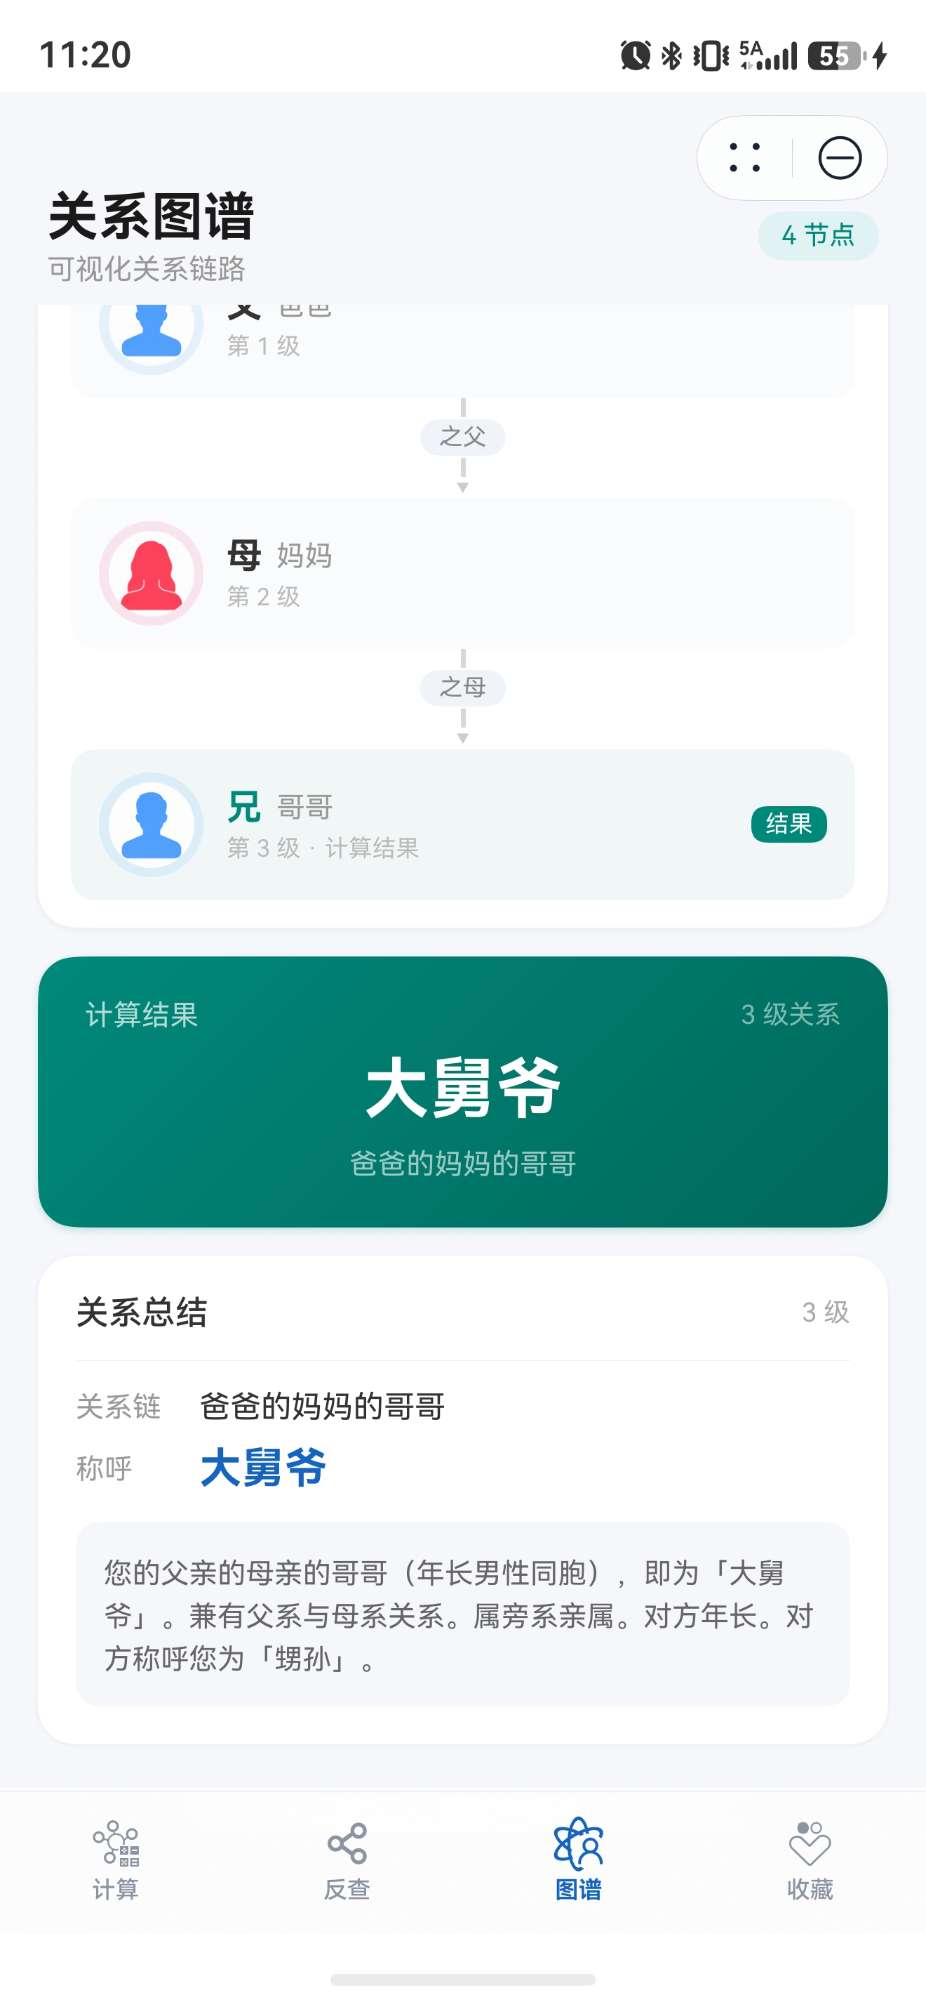
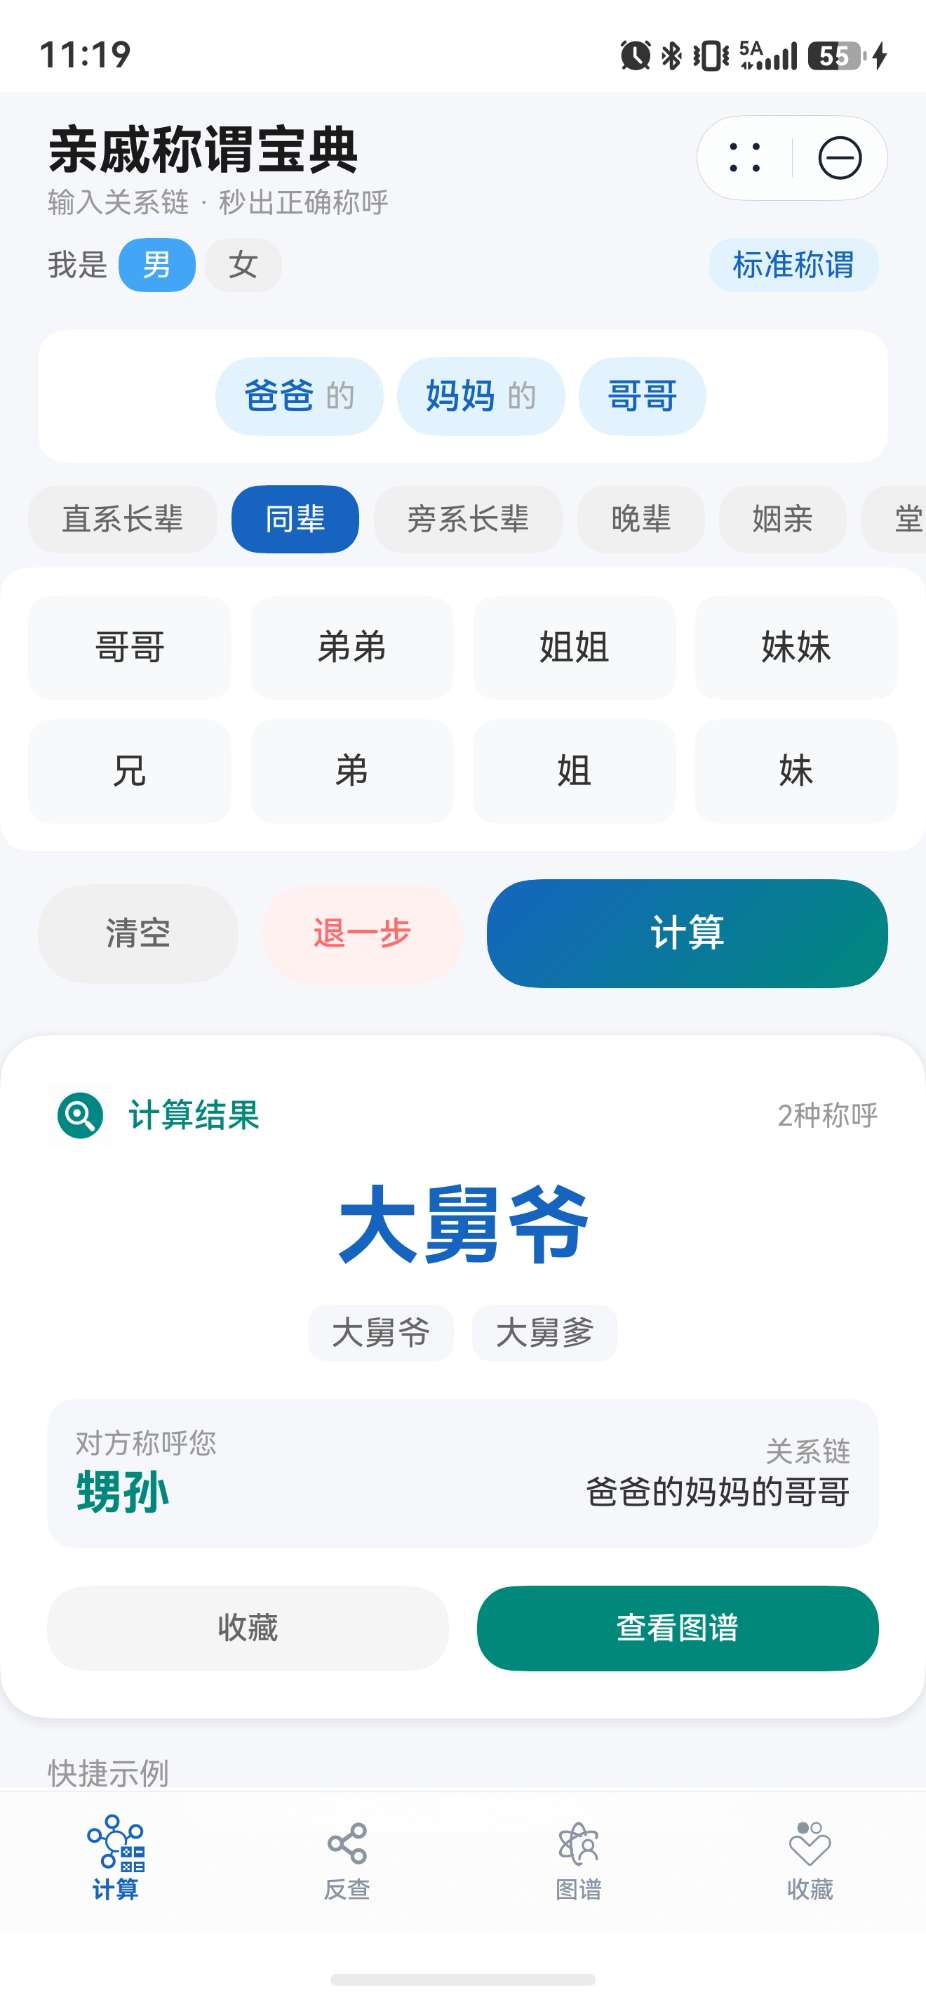
下面是项目的实际运行效果。截图覆盖了称谓计算、结果展示、关系链分析等主要界面,后文会进一步说明这些页面如何共用同一套 RelationshipEngine,以及万能卡片如何复用相同的计算结果。
先看项目做了什么
《亲戚称谓宝典》的主页面分为四个入口:
| 页面 | 用途 |
|---|---|
| 计算 | 逐段选择关系,例如“爸爸的哥哥的女儿”,计算对应称谓 |
| 反查 | 输入“堂姐”“舅舅”等称谓,反查可能的关系链 |
| 图谱 | 把“我 → 爸爸 → 哥哥 → 女儿”画成关系节点 |
| 收藏 | 保存常用计算结果,并保留最近历史 |
项目还提供标准称谓、北方话、南方话、客家话和粤语五种模式。比如 m,f 表示“妈妈的爸爸”,标准模式可以得到“外祖父”,北方话覆盖为“姥爷”,粤语覆盖为“公公”。
桌面端配置了 2*2、2*4 和 4*4 三种万能卡片。用户可以从卡片进入元服务,也可以在卡片事件中直接调用同一套关系计算引擎。
在 DevEco Studio 中使用 HarmonyOS 开发助手
HarmonyOS 开发助手集成在 DevEco Studio 中,主要能力不是简单的代码补全,而是读取工程上下文后完成多文件生成、代码修改、错误定位和任务拆分。华为开发者联盟提供了开发助手介绍和安装文档,插件版本与兼容信息也可以在 JetBrains Marketplace 查询。
按官方文档将 HarmonyOS Dev Assistant 添加到插件中,重启 IDE 后登录华为开发者账号并完成协议确认即可。插件界面会随 DevEco Studio 和插件版本变化,以下步骤的字段名称以当前版本为准。
给开发助手配置 Doubao-Seed-2.1-lite
这次选择豆包模型,原因是它可以通过火山方舟提供 OpenAI 兼容接口,接入开发助手时不需要改变现有的调用方式。配置前需要在火山方舟控制台开通 Doubao-Seed-2.1-lite,创建 API Key,并准备对应的接入地址。
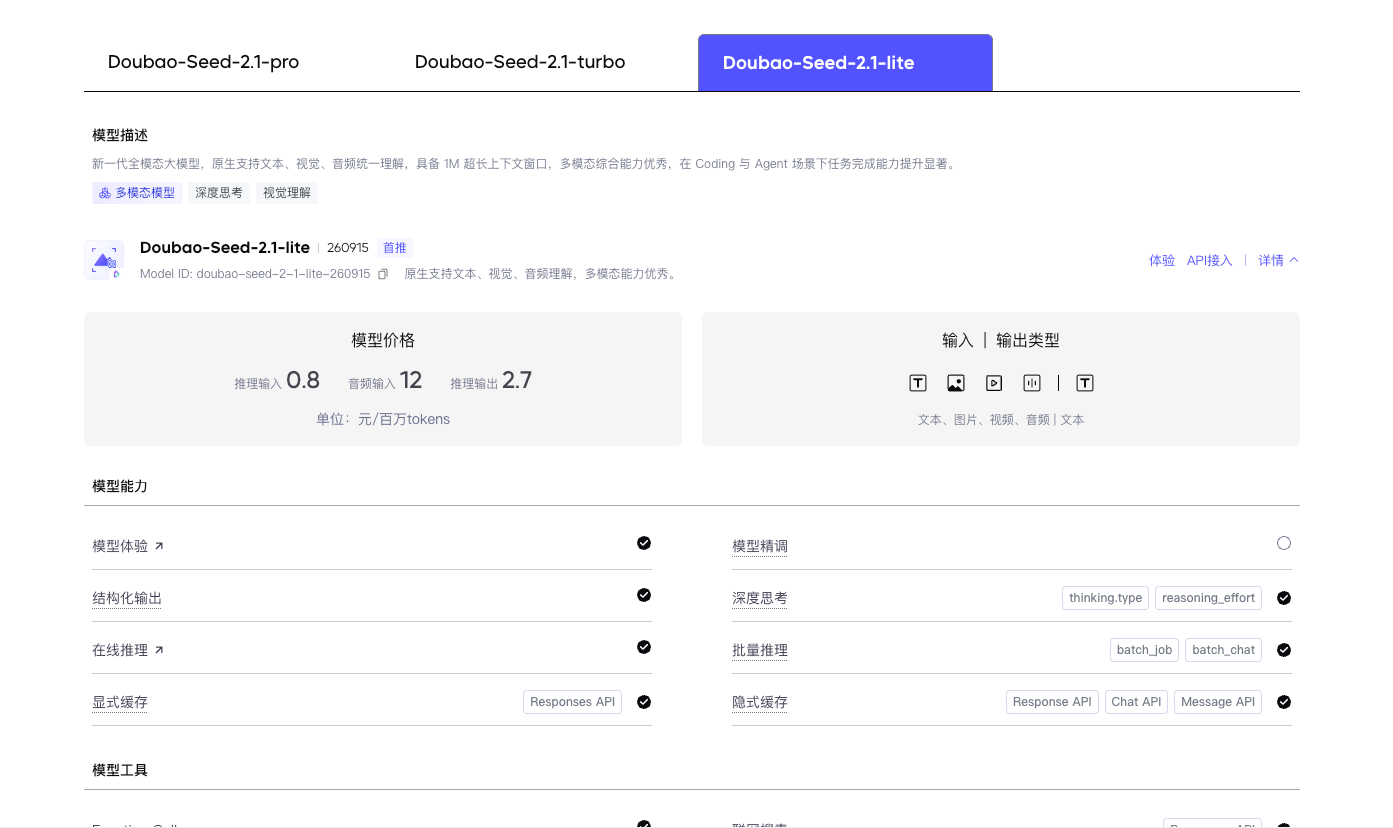
在开发助手的模型设置中选择“通过 URL 添加模型”,协议选择 OpenAI 兼容模型,再填写模型名、Endpoint 和 API Key 。
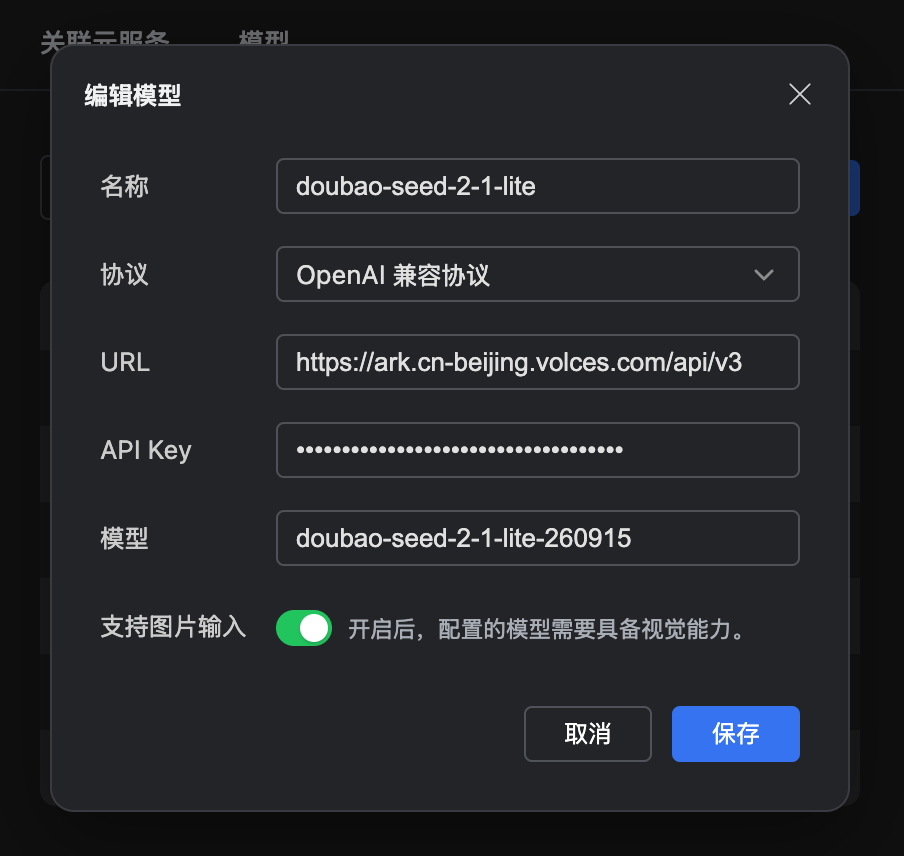
这里需要区分“模型参与开发”和“模型参与运行时业务”。本项目只把 Doubao-Seed-2.1-lite 用在开发阶段,用于生成代码、分析报错和协助补齐字典;应用运行时的称谓计算不依赖网络模型,而是由端侧规则和静态数据完成。这样做的好处是结果可复现、响应稳定,也避免把家庭关系数据发送到服务端。
先把想法写成开发助手能执行的规划
“做一个亲戚关系计算器”对开发助手来说太宽了。它不知道称谓数据从哪里来,不知道“爸爸的弟弟的妻子”该如何归一化,也不知道反查、方言和万能卡片是不是这一版必须完成。
我先整理了一份项目说明书,明确了四层结构:表现层负责计算、反查、图谱和收藏页面;能力层放统一的 RelationshipEngine;数据层使用静态称谓字典、词语映射、合称字典和方言覆盖表;接入层处理 EntryAbility 与 FormAbility,项目规划书的目录大纲如下:
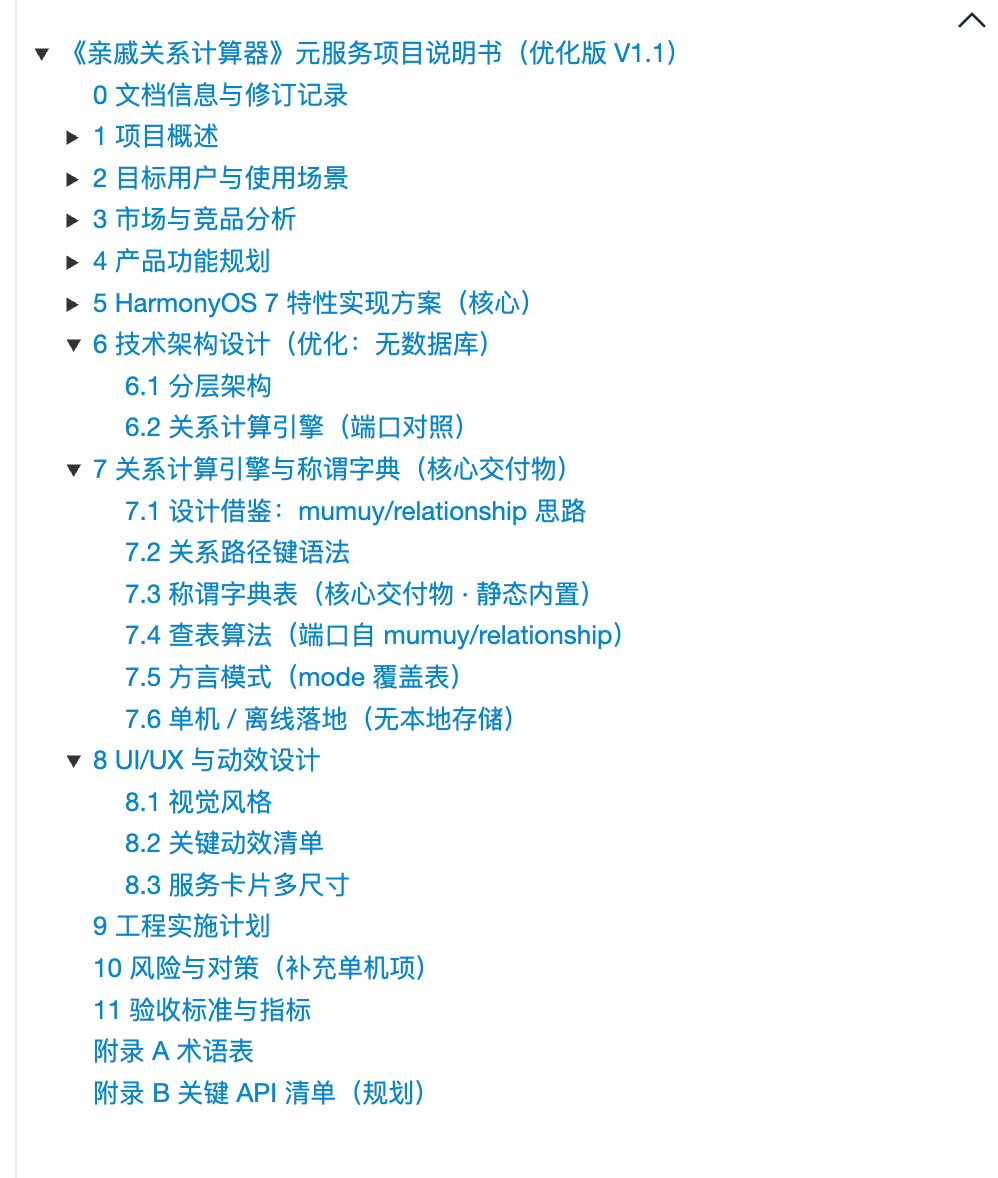
项目规划书完善后再开始分任务开发。当前助手无法直接添加自定义 skill,我采用“项目规划书 + 约束提示词”的方式补足上下文:把目录结构、技术版本、不可改变的接口和验收条件一次说明,再让助手按模块执行。
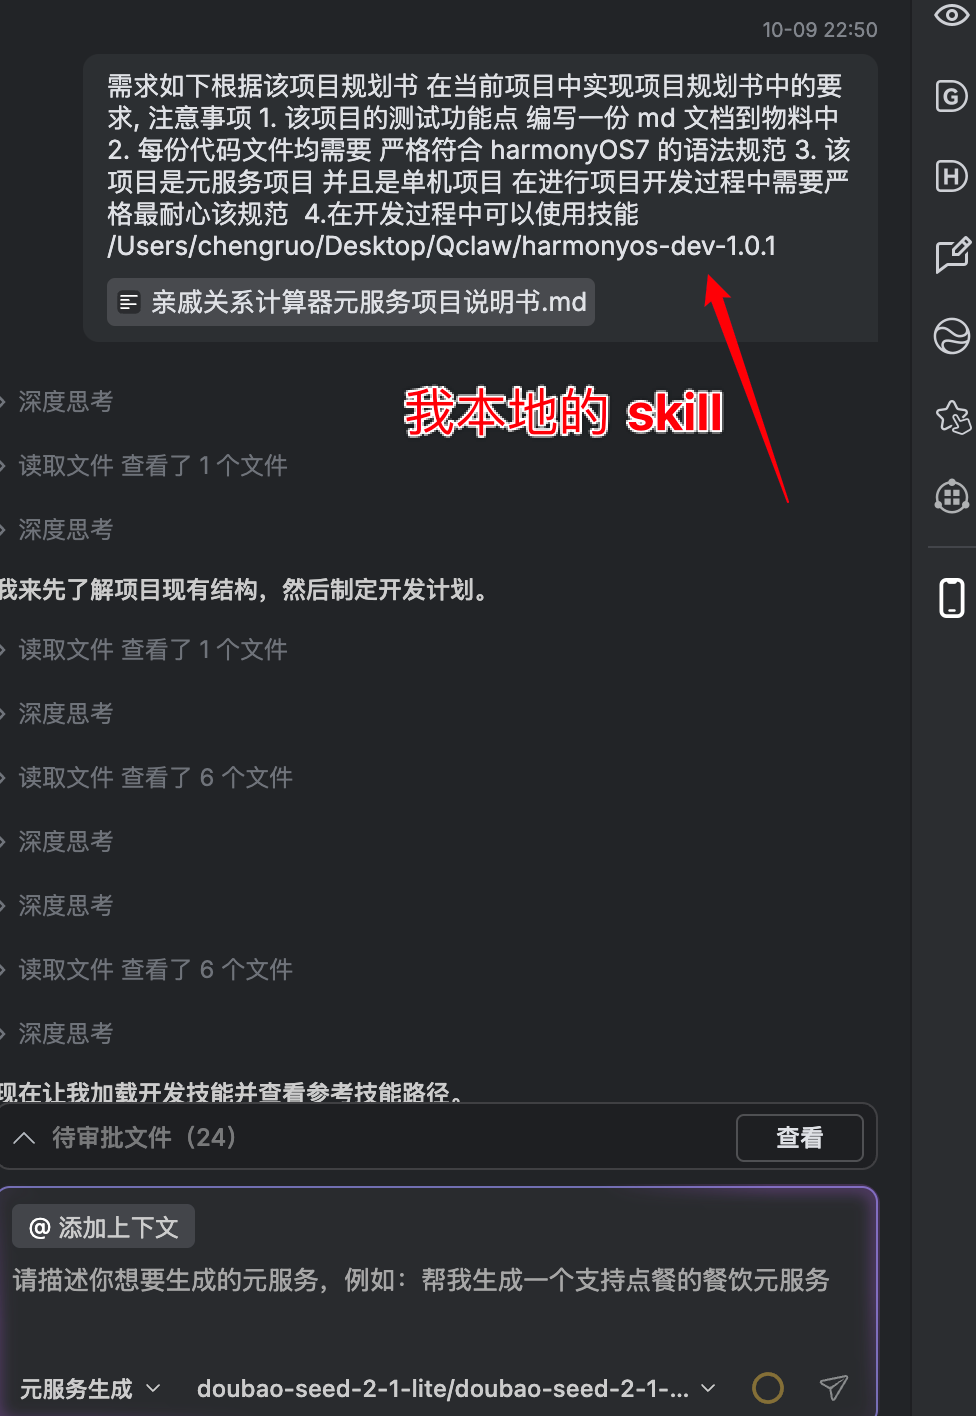
这段提示词至少要交代两件事:一是所有实现必须服从项目规划书,二是涉及 HarmonyOS 7 的 API 和工程约束时,要先检查当前工程版本与已有写法,不能为了“生成得快”随意引入不兼容的 API。我的经验是,把验收条件写成可检查的结果,比只说“请完成这个功能”更容易得到稳定修改。
工程结构
最终工程的核心目录如下:
entry/src/main/
├── ets/
│   ├── components/
│   │   ├── ChainBuilder.ets
│   │   └── ResultCard.ets
│   ├── engine/
│   │   ├── RelationshipEngine.ets
│   │   ├── RelationshipDict.ets
│   │   ├── WordMap.ets
│   │   ├── PairDict.ets
│   │   └── DialectData.ets
│   ├── entryability/EntryAbility.ets
│   ├── formability/FormAbility.ets
│   ├── model/Models.ets
│   ├── pages/
│   │   ├── Index.ets
│   │   ├── CalculatorContent.ets
│   │   ├── ReverseContent.ets
│   │   ├── GraphContent.ets
│   │   └── HistoryContent.ets
│   ├── utils/HistoryUtil.ets
│   └── widget/
│       ├── WidgetCard2x2.ets
│       ├── WidgetCard2x4.ets
│       └── WidgetCard4x4.ets
├── module.json5
└── resources/base/profile/form_config.json
页面没有直接读取称谓字典,而是统一调用 RelationshipEngine。这个边界很重要:同一条关系无论从计算页、反查页还是卡片进入,都必须走同一套解析和查表逻辑,否则功能越做越多,结果反而可能不一致。
核心实现一:把中文关系变成路径键
项目借鉴了开源项目 mumuy/relationship 的路径键思路。基础关系先映射成短标识:
| 路径键 | 含义 | 路径键 | 含义 |
|---|---|---|---|
f | 父亲 | m | 母亲 |
h | 丈夫 | w | 妻子 |
s | 儿子 | d | 女儿 |
ob | 哥哥 | lb | 弟弟 |
os | 姐姐 | ls | 妹妹 |
xb | 兄弟,长幼不明 | xs | 姐妹,长幼不明 |
例如“爸爸的哥哥的女儿”会被转换为 f,ob,d。转换过程并不是简单地按“的”分割后查表。输入里可能出现“父亲”“爸爸”“老爸”等同义词,也可能带有“大伯”“二舅”这样的排行,还可能出现“兄弟”“姐妹”这种长幼不确定关系。
parseChain() 会先统一“之”和“的”,处理“舅舅家的”“叔叔家的”等口语结构,再通过 WordMap 把每一段转换为一个或多个候选路径:
static parseChain(input: string): string[] {
  let s: string = input
    .replace(/之/g, '的')
    .replace(/吾之?(.+)/, '$1')
    .replace(/我的?(.+)/, '$1');

  const segs: string[] = s.split('的');
  let acc: string[] = [];
  let ok: boolean = true;

  for (let seg of segs) {
    const entry = WordMap.get(seg);
    const candidates: string[] = entry?.primitives ?? [];
    if (candidates.length === 0) {
      ok = false;
    }

    const next: string[] = [];
    if (acc.length === 0) {
      acc = [''];
    }
    for (const prefix of acc) {
      for (const id of candidates) {
        next.push(prefix + (id.length > 0 ? ',' + id : ''));
      }
    }
    acc = next;
  }
  return ok ? RelationshipEngine.dedupeS(acc) : [];
}
上面省略了源码中的别名递归扩展和排行处理,只保留主干。这里使用候选集合而不是单个结果,是因为中文称谓天然存在歧义。解析阶段不能过早拍板,应该先保留可能路径,后面再结合本人性别、长幼标记和字典命中情况消歧。
核心实现二:关系链化简与查表
路径生成以后还不能直接查字典。比如“妈妈的丈夫”是爸爸,对应 m,h → f;“妻子的丈夫”会回到自己;“儿子的兄弟”仍然是自己的儿子。这些规则集中在 RelationshipEngine 的 F_RULES 中,并由 filterChain() 反复执行,直到结果稳定。
主计算入口负责串起整个流程:清理输入、解析候选链、按本人性别化简、查询方言称谓、计算反向称谓并生成解释。
static calculate(text: string, sex: number, dialect: string,
  reverse: boolean): RelationshipResult {
  const cleaned: string = text.trim().replace(/[,,。.!!??]/g, '');
  if (cleaned.length === 0) {
    return new RelationshipResult('自己', ['自己'], '', '', sex);
  }

  const chains: string[] = RelationshipEngine.parseChain(cleaned);
  if (chains.length === 0) {
    return new RelationshipResult('无法识别', [], '', text, sex);
  }

  let titles: string[] = [];
  let primarySel: string = '';
  for (const chain of chains) {
    const simplified: string[] = RelationshipEngine.applySex(chain, sex);
    for (const sel of simplified) {
      const result: string[] = RelationshipEngine.lookupTitles(sel, dialect);
      if (result.length > 0) {
        primarySel = primarySel.length === 0 ? sel : primarySel;
        titles = titles.concat(result);
      }
    }
    if (primarySel.length > 0) {
      break;
    }
  }

  if (titles.length === 0) {
    return new RelationshipResult('未知称谓', [], primarySel, text, sex);
  }

  titles = Array.from(new Set(titles));
  const result = new RelationshipResult(titles[0], titles, primarySel, text, sex);
  if (reverse) {
    result.reverseTitles = RelationshipEngine.getReverseTitles(primarySel, sex, dialect);
    result.reverseTitle = result.reverseTitles[0] ?? '';
  }
  result.explanation = RelationshipEngine.generateExplanation(primarySel, sex, dialect);
  result.dialectTitles = titles;
  return result;
}
这里有两个我让开发助手重点检查的边界。一个是解析失败和查表失败必须分开:前者说明输入词无法识别,后者说明路径能理解但字典还没覆盖。另一个是 titles 必须去重,因为别名扩展和多个候选路径可能得到同一个称谓。
关系算法的正确性不能靠看页面判断。我准备了一组按类别划分的样例:父系、母系、姻亲、直系后代、旁系、长幼歧义、本人性别冲突和方言覆盖。每次让助手改规则后,只回归一个例子远远不够,至少要把这些类别都重新跑一遍。
核心实现三:方言不是另一套算法
方言处理没有复制五份称谓字典,而是在标准字典上增加覆盖表。DialectData 的第一层 key 是方言名称,第二层 key 仍然使用统一的关系路径。
const north: Map<string, string[]> = new Map();
north.set('m,f', ['姥爷', '老爷']);
north.set('m,m', ['姥姥', '老娘']);
north.set('f,ob', ['大爷']);
north.set('f,lb,w', ['婶子']);

const cantonese: Map<string, string[]> = new Map();
cantonese.set('f,f', ['阿爷']);
cantonese.set('f,m', ['阿嫲']);
cantonese.set('f', ['老豆', '阿爸']);
cantonese.set('m', ['阿妈', '老母']);
查询时先找当前方言的覆盖值,没有命中再回退标准字典。这样路径解析、性别判断和关系化简都只维护一套。后续补充某个地区的叫法,只改数据,不碰算法。
方言称谓有明显地域差异,当前数据只能算工程内置词表,不能把它宣传成覆盖所有地区。更稳妥的做法是持续补充来源明确的数据,并给用户保留标准称谓作为回退结果。
核心实现四:正向计算、反查和解释共用一个 ID
正向计算解决“这个人我该怎么叫”,反向反查解决“叫舅舅的人和我是什么关系”。工程没有再写一套字符串推断,而是先从 WordMap 和标准字典中反查可能的路径,再把路径交给统一结果构建逻辑:
static reverseLookupTitle(title: string, dialect: string): RelationshipResult[] {
  const results: RelationshipResult[] = [];
  const seen: Set<string> = new Set();
  const entry = WordMap.get(title);

  if (entry !== undefined) {
    for (const sel of entry.primitives) {
      if (!seen.has(sel)) {
        seen.add(sel);
        results.push(RelationshipEngine.buildReverseResult(sel, title, dialect));
      }
    }
  }

  for (const id of RelationshipDict.reverseLookup(title)) {
    if (!seen.has(id)) {
      seen.add(id);
      results.push(RelationshipEngine.buildReverseResult(id, title, dialect));
    }
  }
  return results;
}
同一个称谓可能对应多条关系,因此反查结果用列表展示,不强行给出唯一答案。比如某些口语称呼本来就会跨地区、跨亲系复用,产品层应把歧义展示出来,而不是让算法假装确定。
项目里的“为什么这么叫”同样没有调用大模型。generateExplanation() 会逐段读取路径原语,拼出关系过程,再补充父系、母系、姻亲、直系、旁系和长幼信息:
const titles: string[] = RelationshipEngine.lookupTitles(sel, dialect);
const titleStr: string = titles.length > 0 ? titles[0] : '未知';
let explanation: string = steps[steps.length - 1]
  + ',即为「' + titleStr + '」。';

const sideInfo: string = RelationshipEngine.analyzeSide(sel);
if (sideInfo.length > 0) {
  explanation += sideInfo;
}
规则解释虽然没有生成式语言那么灵活,但结果可复现、速度稳定,也不会把不存在的亲属关系说得煞有介事。对于称谓计算这种确定性问题,我更愿意把大模型留在开发工具里,而不是放到产品的答案链路中。
核心实现五:页面只负责交互
计算页收集关系链和性别、方言状态,真正计算时只调用一次引擎:
const calcResult: RelationshipResult = RelationshipEngine.calculate(
  chainText, this.appSex, this.appDialect, true);
this.result = calcResult;
this.showResult = true;

const historyItem: HistoryItem = new HistoryItem(
  chainText, calcResult.title, calcResult.titles.join('/'),
  this.appSex, false, this.appDialect);
await HistoryUtil.addHistory(historyItem);
RelationshipResult 同时保存主称谓、候选称谓、路径 ID、原始关系链、反向称谓、解释和方言结果。页面与图谱都消费这个统一模型,不需要从展示文本里重新推断关系。
历史和收藏使用 @kit.ArkData 的 Preferences。历史最多保留 50 条,收藏最多保留 100 条。称谓字典并没有放进 Preferences,它是编译期静态数据。这里区分“业务知识”和“用户状态”,能避免启动时做没有必要的持久化 IO。
核心实现六:万能卡片复用同一计算内核
module.json5 中开启了免安装,并注册 FormAbility:
{
  "module": {
    "type": "entry",
    "installationFree": true,
    "extensionAbilities": [
      {
        "name": "FormAbility",
        "srcEntry": "./ets/formability/FormAbility.ets",
        "type": "form",
        "exported": true,
        "metadata": [
          {
            "name": "ohos.extension.form",
            "resource": "$profile:form_config"
          }
        ]
      }
    ]
  }
}
卡片事件收到 chainText、sex 和 dialect 后,直接调用 RelationshipEngine.calculate(),再通过 formProvider.updateForm() 更新卡片:
if (chainText.length > 0) {
  const result: RelationshipResult = RelationshipEngine.calculate(
    chainText, sex, dialect, true);
  formTitle = result.title;
  formChain = result.chainText;
  formTitles = result.titles.join('/');
  formExplanation = result.explanation;
  formReverse = result.reverseTitle;
}

formProvider.updateForm(
  formId,
  formBindingData.createFormBindingData(formData)
);
三种卡片尺寸分别在 form_config.json 中声明,UI 使用独立的 ArkTS 文件,但数据来源一致:
{
  "name": "relationship_card_2x2",
  "src": "./ets/widget/WidgetCard2x2.ets",
  "uiSyntax": "arkts",
  "updateEnabled": true,
  "scheduledUpdateTime": "09:00",
  "defaultDimension": "2*2",
  "supportDimensions": ["2*2"]
}
卡片不是主页面的缩小版。2*2 只适合展示结果和入口,2*4、4*4 才有空间放快捷关系或更多解释。让开发助手生成卡片时,需要明确每个尺寸的信息层级,否则很容易得到一套按比例缩放、实际无法操作的界面。
我如何让开发助手修改复杂算法
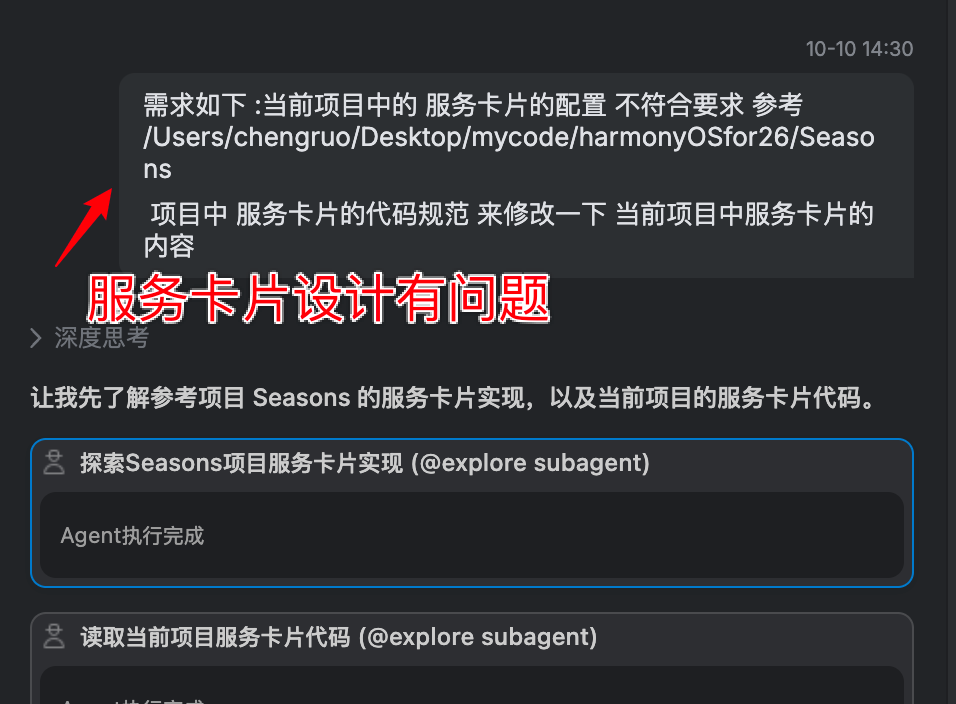
对于错误我是如和修改的呢,如下图所示,当出现错误时,首先需要知道错误的具体位置,如图我给其一个可参考的正确的项目案例,让其根据正确的案例进行修改,
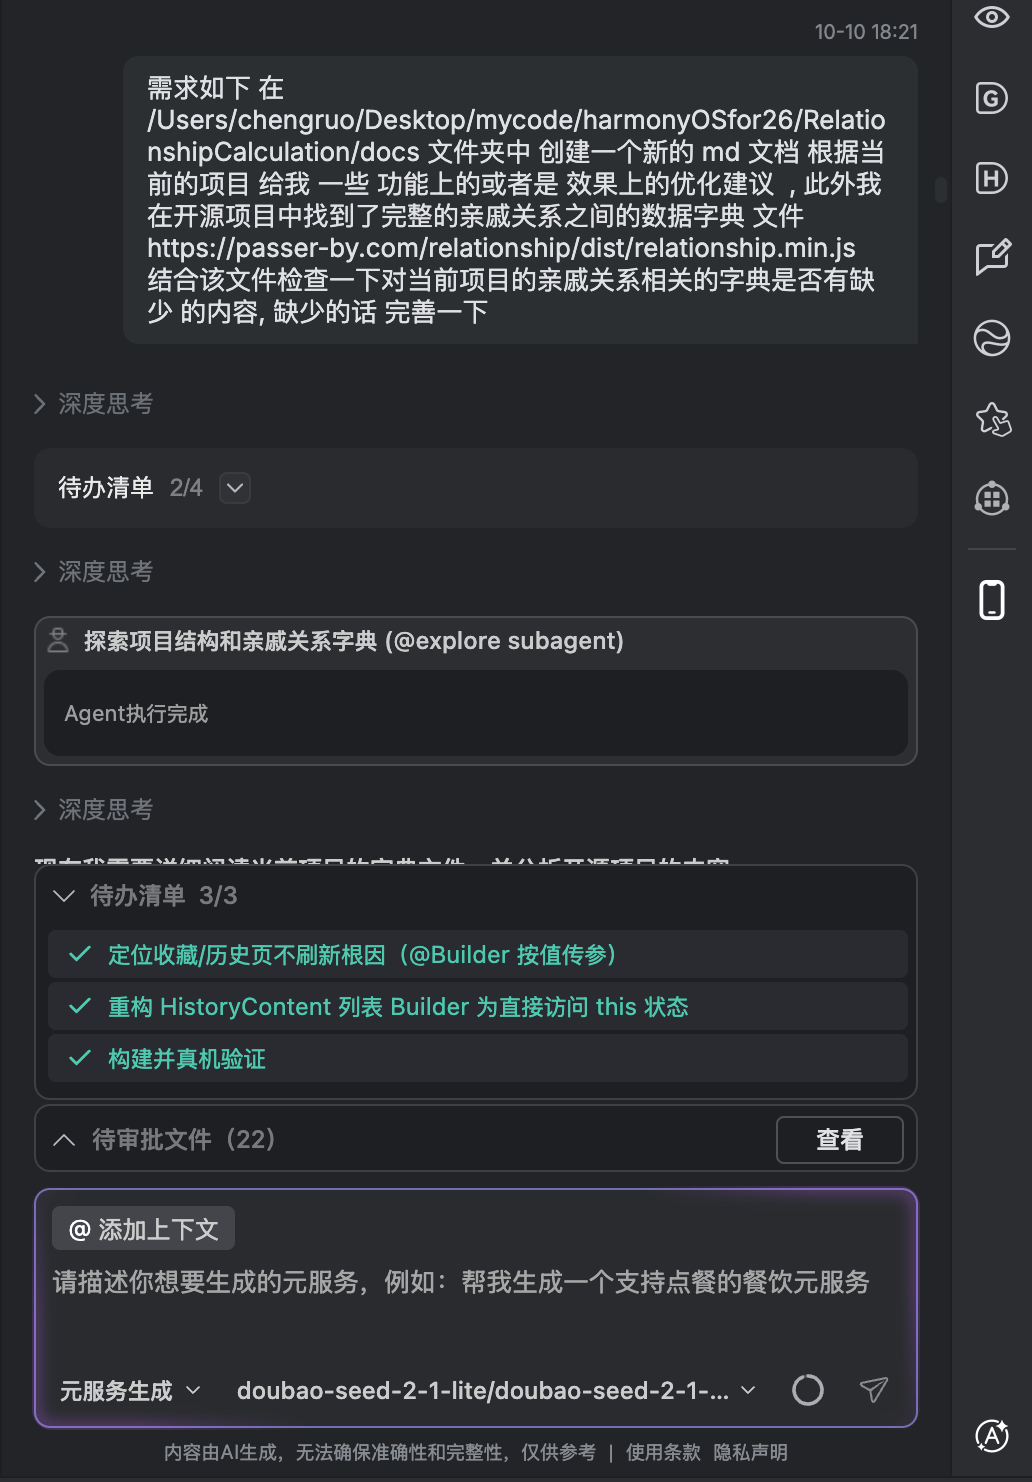
如下图所示,由于关系字典内容不全 此时我让助手根据开源项目来完善关系字典的内容.
总结
这次做《亲戚称谓宝典》,我对 HarmonyOS 开发助手的判断是:它的价值不在于一次生成多少代码,而在于能围绕规划书持续读取工程、拆任务、定位错误并做局部修改。Doubao-Seed-2.1-lite 的接入只是起点,真正影响结果的是上下文是否可靠、任务边界是否清楚、验收条件是否可检查。
这个项目也验证了一个朴素的工程判断:确定性问题优先用确定性方案。称谓计算交给路径规则和静态字典,模型留在开发阶段帮助写代码、查问题。这样既保住了离线体验,也避免为了贴上“AI”标签,把一个可以稳定查表的问题变成不可复现的生成结果。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献400条内容

所有评论(0)