【共创稿事节】HarmonyOS 7 Agent 开发实战 08:结构化输出解析
在「HarmonyOS 7 Agent 开发实战」系列里,第 01 篇我们已经搭好了 llmclient,让模型能够稳定地"吐文字";第 03 篇讲了 Tool Calling,让模型能"发起工具调用"。本篇(第 08 篇)聚焦一个看似微小、却贯穿所有落地的环节:当模型吐出的不是散文,而是一段 JSON 时,你怎么把它变成可信、可校验、可落库的字段? 这就是"结构化输出解析"。
先划一条清晰的分界线。第 03 篇的 Tool Calling 解决的是"模型要不要调用某个函数、传什么参数"的问题——本质是动作决策;本篇解决的是"模型已经给了一段结构化文本,我怎么把它安全地解析成对象"的问题——本质是数据抽取与校验。前者是让 Agent 能"做事",后者是让 Agent 给的数据"可用"。两者互补:你可以先让模型用 Tool Calling 决定调用 extractResume,再用本篇的解析器把返回结果校验落库。
一、为什么模型吐出的 JSON 不能直接 JSON.parse
理想情况下,你让模型"返回 JSON",它就会返回干净的一行 {...}。现实里,模型输出通常带着三层"脏":
- Markdown 围栏:
```json ... ````包裹,甚至围栏语言标识写成json` 也可能写成别的。 - 前后碎碎念:开头一句"好的,以下是结果",结尾一句"以上信息已提取"。
- 语法瑕疵:最后一个字段后面多一个尾逗号
{ "a": 1, },这在标准 JSON 里是非法的,但模型非常爱写。
如果直接 JSON.parse,第二、第三点会立刻抛 SyntaxError。更危险的是第一点:围栏里的反引号进了字符串,解析同样失败。生产环境里这类"脏输出"出现率不低,靠 prompt 约束只能降低概率,不能消除。所以我们要在客户端做一层确定性的修复与校验,而不是赌模型每次都工整。
例如 ArkTS 中 JSON.parse 在输入非法时抛出 SyntaxError,因此我们把它包在 try/catch 里做安全解析;开发者联盟文档也建议所有外部来源的反序列化都应做容错处理。
二、整体架构:四段式管线
我们把"脏 JSON → 可信对象"拆成四个职责单一的纯函数模块,彼此不耦合,方便单测与复用:
- JsonRepair:只负责文本修复与抽取(去围栏、去尾逗号、抠片段、安全解析)。
- StructuredParser:消费 JsonRepair 的结果,按 schema 做字段存在性与类型校验。
- MockLlmClient:实现统一的
LlmClient抽象,离线返回一段脏 JSON,让整个 Demo 不依赖密钥即可跑通。 - Index 页面:把文本框 + 解析按钮 + 结果展示串起来。
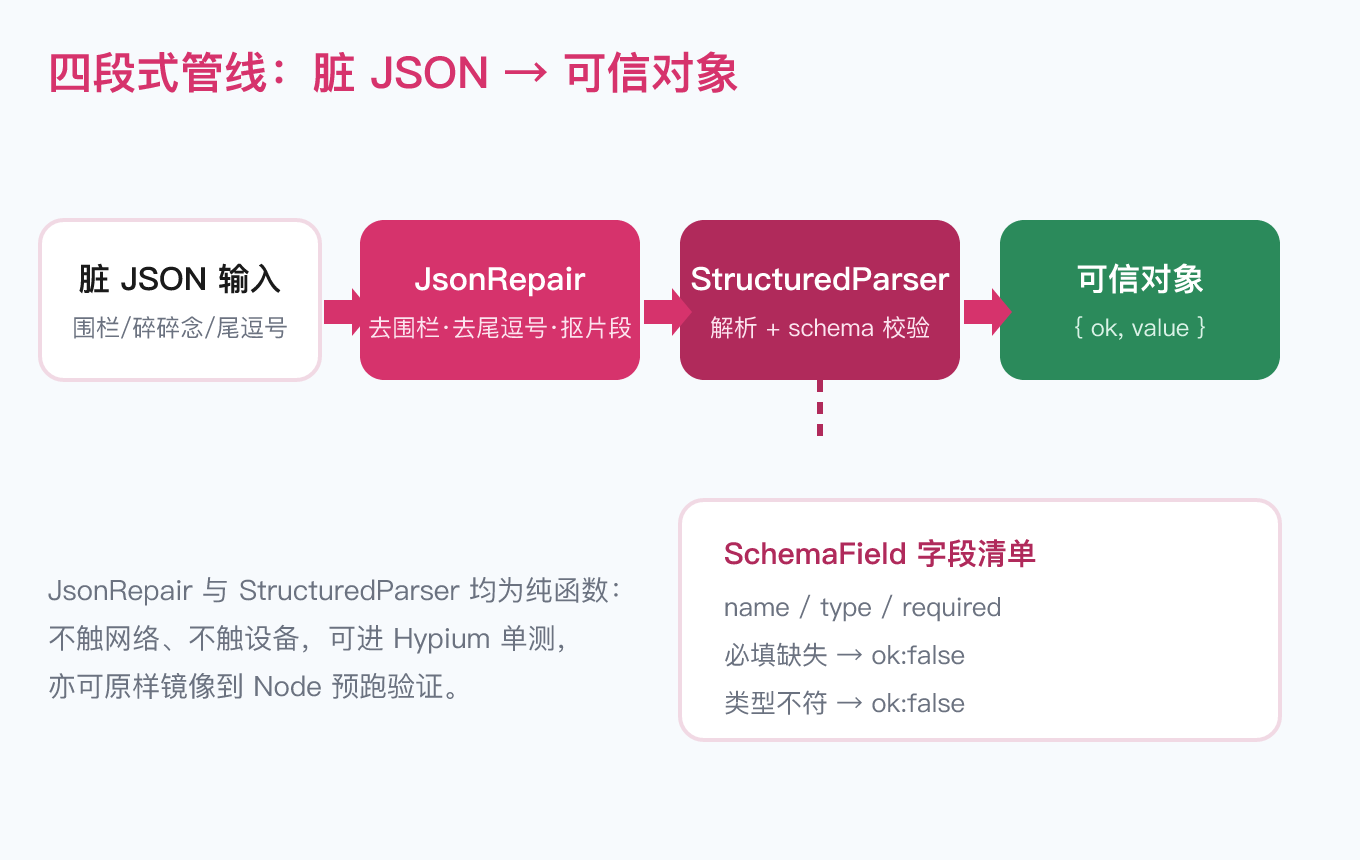
这条管线的好处是:JsonRepair 与 StructuredParser 都不碰网络、不碰设备,因此可以原样在 Node 里镜像一份纯逻辑做"预跑",也能直接进 Hypium 单元测试。验证前移,出问题就被挡在最前面。
三、核心一:JsonRepair 修复器
stripMarkdownFences 的逻辑分两步:先用正则把 ```...````围栏的内容抠出来;若文本里压根没围栏,就找第一个{或[`,把之前的所有碎碎念裁掉。
export class JsonRepair {
  static stripMarkdownFences(text: string): string {
    let s: string = text;
    const fence = /```[a-zA-Z]*\s*([\s\S]*?)```/g;
    const m = fence.exec(s);
    if (m !== null) {
      s = m[1];
    }
    const firstObj: number = s.indexOf('{');
    const firstArr: number = s.indexOf('[');
    let start: number = -1;
    if (firstObj >= 0 && firstArr >= 0) {
      start = Math.min(firstObj, firstArr);
    } else if (firstObj >= 0) {
      start = firstObj;
    } else if (firstArr >= 0) {
      start = firstArr;
    } else {
      return s.trim();
    }
    s = s.substring(start);
    return s.trim();
  }
}
removeTrailingCommas 用一个正则把"逗号紧跟 } / ]"的结构替换掉,像 { "a": 1, } 会变成 { "a": 1 }。
static removeTrailingCommas(text: string): string {
  return text.replace(/,(\s*[\}\]])/g, '$1');
}
extractFirstJson 更关键:从一段很脏的文本里找到第一个 { 或 [,然后用括号计数法向后扫描,遇到字符串内的括号要跳过、遇到转义也要跳过,直到计数归零,截出那段完整 JSON。它保证即便 JSON 后面还跟着"谢谢使用"也不会被误吞。
safeParse 把 JSON.parse 包进 try/catch,成功返回 { ok: true, value },失败返回 { ok: false, error },绝不向上抛。这是整条管线"可降级"的基石。
四、核心二:StructuredParser 与 SchemaField
光解析还不够,我们还要校验。定义一个极简的字段清单 SchemaField,描述每个字段的名字、期望类型、是否必填:
export type SchemaFieldType = 'string' | 'number' | 'boolean' | 'object' | 'array';

export interface SchemaField {
  name: string;
  type: SchemaFieldType;
  required: boolean;
}
StructuredParser.parse 把四步串起来:修复 → 抽取 → 解析 → 逐字段校验。校验规则只有两条:必填字段缺失就判失败;字段存在但 typeof 不匹配就判失败(注意 NaN 不算合法 number,避免模型写出 "age": NaN 漏过)。
export class StructuredParser {
  static parse(text: string, schema: SchemaField[]): ParseResult {
    let cleaned: string = JsonRepair.stripMarkdownFences(text);
    cleaned = JsonRepair.removeTrailingCommas(cleaned);
    const json: string = JsonRepair.extractFirstJson(cleaned);
    if (json.length === 0) {
      return { ok: false, error: '未找到合法的 JSON 对象或数组' };
    }
    const parsed = JsonRepair.safeParse(json);
    if (!parsed.ok) {
      return { ok: false, error: 'JSON 解析失败: ' + (parsed.error ?? '未知错误') };
    }
    const value: Record<string, Object> = parsed.value as Record<string, Object>;
    for (const field of schema) {
      const present: boolean = value[field.name] !== undefined;
      if (field.required && !present) {
        return { ok: false, error: '缺少必填字段: ' + field.name };
      }
      if (present && !StructuredParser.typeMatches(value[field.name], field.type)) {
        return { ok: false, error: '字段类型不符: ' + field.name + ' 期望 ' + field.type };
      }
    }
    return { ok: true, value };
  }
}
为了业务侧少写样板,我们提供两个类型化抽取器:extractResume 与 extractContract,各自内置一份 schema。它们把"解析 + 校验"收敛成一个函数调用,页面只拿结果。
static extractResume(text: string): Record<string, Object> {
  const schema: SchemaField[] = [
    { name: 'name', type: 'string', required: true },
    { name: 'title', type: 'string', required: false },
    { name: 'skills', type: 'array', required: true },
    { name: 'years', type: 'number', required: false }
  ];
  const r: ParseResult = StructuredParser.parse(text, schema);
  if (!r.ok) {
    return { __error: r.error ?? '解析失败' } as Record<string, Object>;
  }
  return r.value as Record<string, Object>;
}
五、离线可跑:MockLlmClient 与演示页
为了让 Demo 不需要任何密钥也能演示全链路,我们实现了一个 MockLlmClient,它继承自统一抽象 LlmClient,sendOnce 直接返回一段"带围栏 + 尾逗号 + 碎碎念"的脏 JSON:
export class MockLlmClient extends LlmClient {
  cannedResponse: string;
  constructor(cannedResponse?: string) {
    super({ baseUrl: '', apiKey: '', model: '' } as LlmClientConfig);
    this.cannedResponse = cannedResponse ?? MOCK_RESUME_JSON;
  }
  buildPayload(_req: ChatRequest): Record<string, Object> { return {}; }
  buildHeaders(): Record<string, string> { return {}; }
  classifyError(_err: Error): RetryableError { return RetryableError.NON_RETRYABLE; }
  protected async sendOnce(_req: ChatRequest): Promise<string> {
    return JSON.stringify({
      choices: [{ message: { content: this.cannedResponse }, finish_reason: 'stop' }]
    });
  }
}
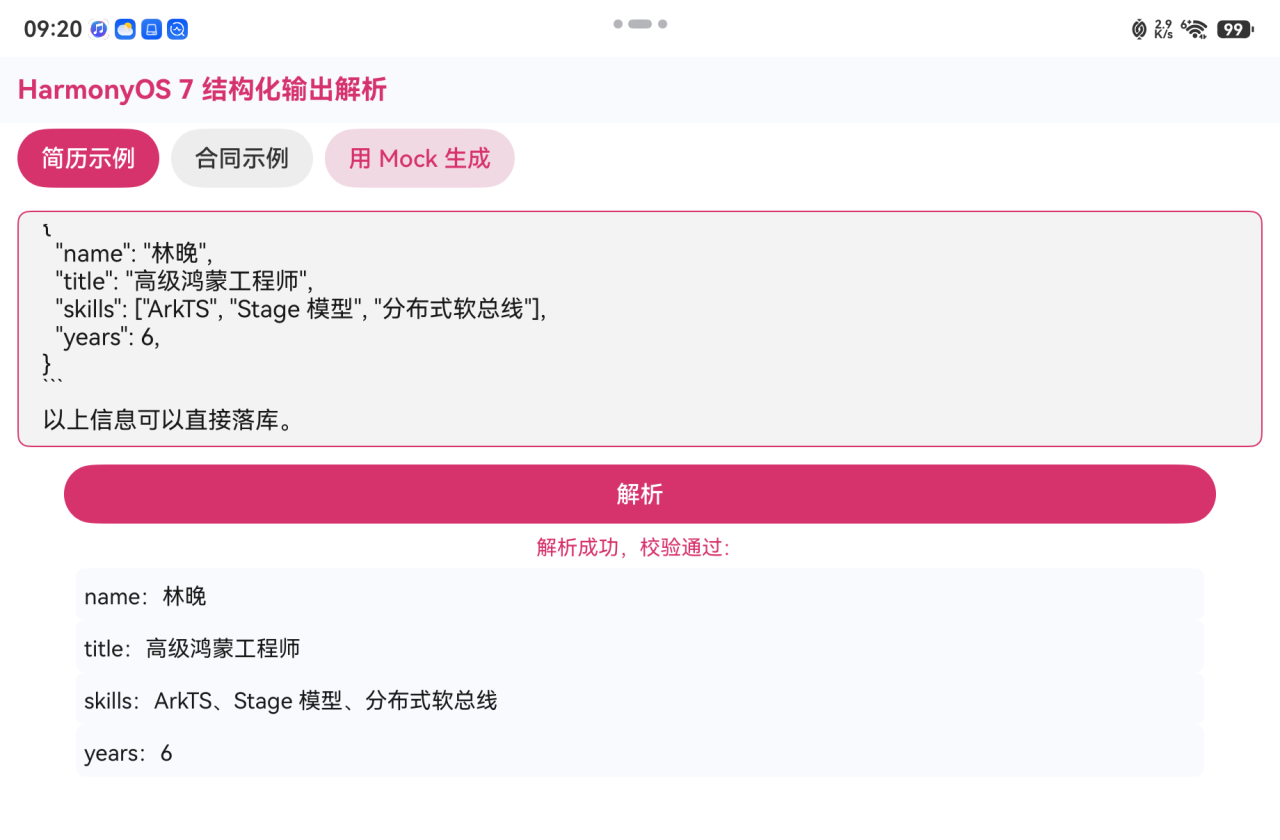
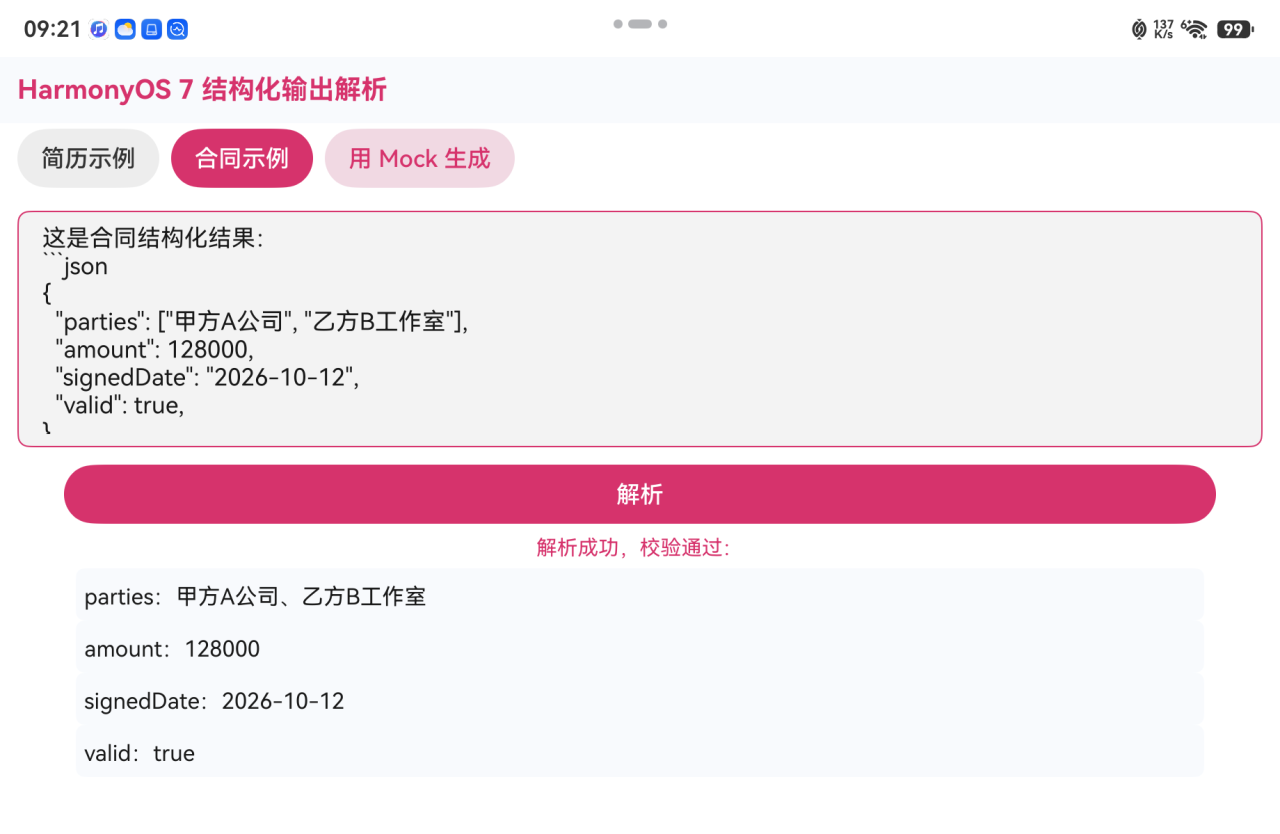
Index.ets 的演示页很简单:一个文本框预填脏 JSON,一个"解析"按钮,点下去调用 StructuredParser.extractResume,成功就把字段逐行展示,失败就把 error 文案高亮出来。整个交互纯本地、纯同步(修复与校验都是纯函数),所以即便在模拟器之外你也能用 Node 镜像把同样的逻辑跑通。
测试效果图如下:
六、避坑指南
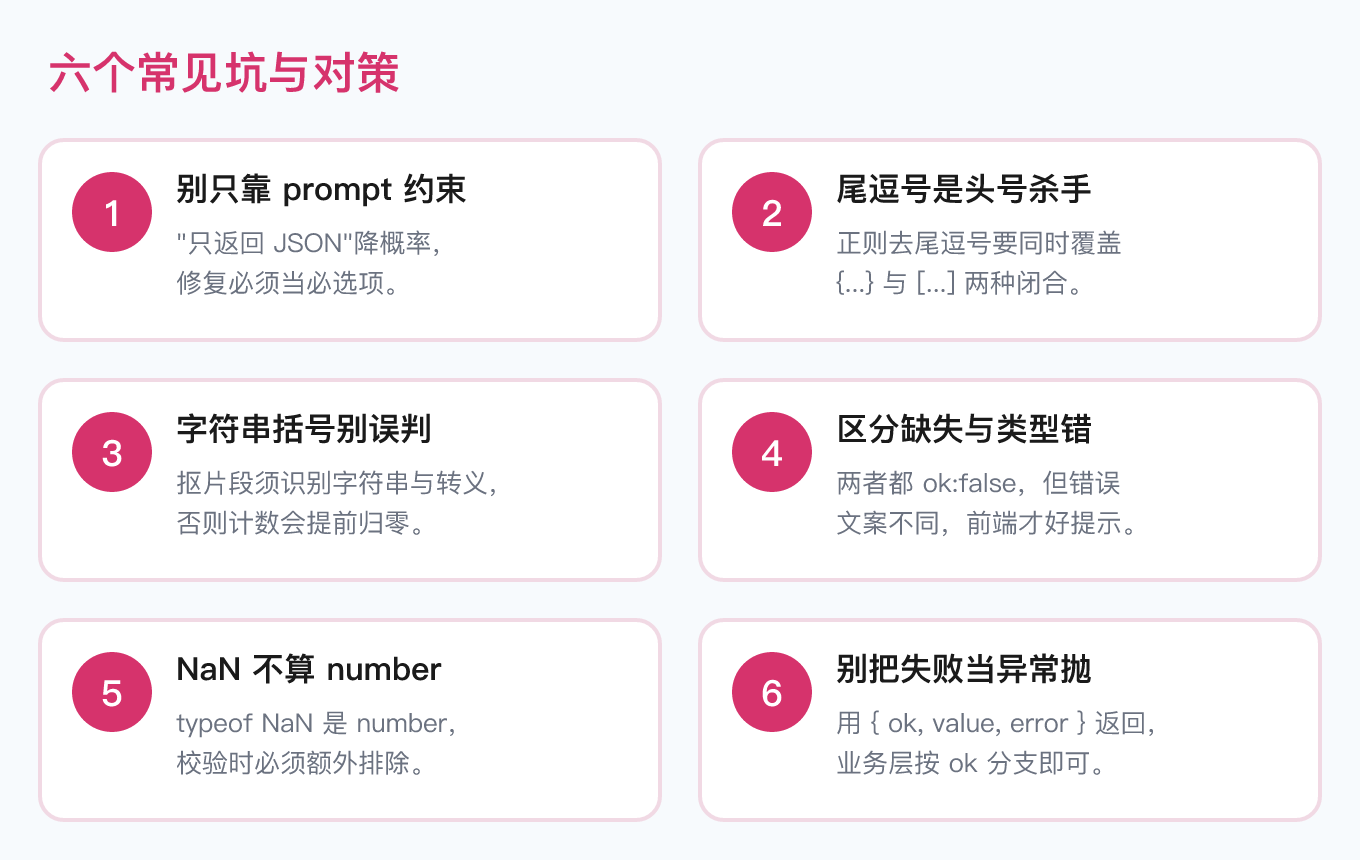
- 别只靠 prompt 约束:"请只返回 JSON"能降概率,但生产要把修复当必选项,而不是可选项。
- 尾逗号是头号杀手:模型几乎必写,正则去尾逗号要同时覆盖
{...}与[...]两种闭合。 - 字符串里的括号别误判:
extractFirstJson必须识别字符串与转义,否则"note": "a } b"会让计数提前归零。 - 校验要区分"缺失"与"类型错":两者都返回
ok: false,但错误文案不同,前端才能给出精准提示。 - NaN 不算 number:
typeof NaN === 'number',校验时必须额外排除,否则脏数据会漏网。 - 别把解析失败当异常抛:用
{ ok, value, error }的结构返回,业务层按ok分支即可,崩溃面更小。
七、验证前移:Hypium 测试与 Node 镜像
因为 JsonRepair 与 StructuredParser 都是纯函数,我们写两套验证:一是 DevEco 里的 Hypium 单测,覆盖去围栏、去尾逗号、抠片段、合法解析、缺必填、类型不符六类用例;二是工程根目录的 verify-node.cjs,把同样逻辑用纯 JS 镜像一份,在本地 Node 里"预跑",不需要打开 IDE 就能确认算法正确。
纯逻辑通过了,再谈 UI 与设备。这一层不依赖网络、不依赖模拟器,是整套方案里最稳、也最该先写测试的部分。
八、何时该上结构化解析,何时不用
结构化输出解析不是银弹,它的适用边界也值得说清:
- 适合:模型输出要落库、要进表单、要驱动后续逻辑。例如从简历抽字段、从合同抽金额与签约方、从工单抽优先级与标签。凡是"机器要消费"的输出,都该经过这一层。
- 不必强求:纯展示给"人看"的散文、闲聊、解释性回答,直接渲染文本即可,强行 JSON 化反而损失表达力。
- 与 01 篇的关系:第 01 篇的 llmclient 保证"能拿到模型文本",本篇在此基础上保证"拿到的文本能变成可信数据",两者是上下游;没有 01 的底座,本篇没有输入,没有本篇,01 的输出只能停在字符串层面。
- 与 03 篇的协作:如果业务需要先"决定抽什么",用 Tool Calling 让模型选
extractResume或extractContract;选完之后,本篇负责把那份输出解析校验。动作决策与数据校验,顺序接力,各管一段。
把这套"脏 JSON → 修复 → 校验 → 可信对象"的管线沉淀成公共模块后,新业务接结构化输出几乎零成本:写一份 schema,调一个 extractXxx,剩下的脏活都由 JsonRepair 与 StructuredParser 兜住。
参考与出处
- 华为开发者联盟 · HarmonyOS 应用开发文档:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V5/
- ArkTS 语言概述:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V5/arkts-overview-V5
- DevEco Studio 与 Hypium 测试框架:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V5/ide-commandline-hvigor-V5
最后一句:当模型学会"说话"之后,能不能把话变成可信的数据,才是 Agent 真正落地的最后一公里——而结构化输出解析,就是这条路上最值得先修好的一块路基。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 4
 0
- 0


 已为社区贡献134条内容

所有评论(0)