【共创稿事节】HarmonyOS 7 Agent 开发实战 09:Agent 测试评测集
做 Agent 应用最怕的不是「写不出第一版」,而是「改了第三版之后,发现第一版明明答对的题现在答错了」。大模型有随机性、提示词有耦合、工具调用有边界,靠人肉聊天抽查既覆盖不全又无法回放。这一篇我们给 Agent 配上一套离线评测集:用一份写死的黄金用例,把「模型这次答得对不对」变成可以重复跑、可以量化、可以纳入改版前验收的客观指标。它完全不依赖真机联网,打开 DevEco 就能跑,改完代码按一下就知道质量涨了还是跌了。很多团队把 Agent 当成「调通一次就完事」的脚本,结果每次模型升级、提示词微调都提心吊胆,因为没有人能说清「上一版到底能答对哪些题」。评测集就是把这份模糊的直觉,变成一份可版本化、可 diff、可回归的清单。
一、先划清边界:评测集 ≠ 运行时观测
系列里有一篇(第 32 篇)讲运行时可观测(DFX 追踪),那是把 Agent 跑在真机上之后,去追踪每一次链路调用的耗时、入参、出参、异常。它回答的是「线上这次为什么这样」。而本篇讲的是离线评测:你在改代码之前,用一组固定题目去考 Agent,看它答得对不对,回答的是「这一版比上一版好还是差」。
两者互补,但关注点不同。观测看「过程」,评测看「结果」;观测面向线上运维,评测面向开发期回归。别把二者混为一谈——你不能靠线上追踪来发现「模型把答案改错了」,因为线上流量未必覆盖那道错题;你也不能靠评测集来替你发现「某次调用慢了 500 毫秒」,因为评测集离线是同步、确定、无网络的。一句话:评测集管「答案对不对」,观测管「线上为什么这样」。
二、评测集的三件套
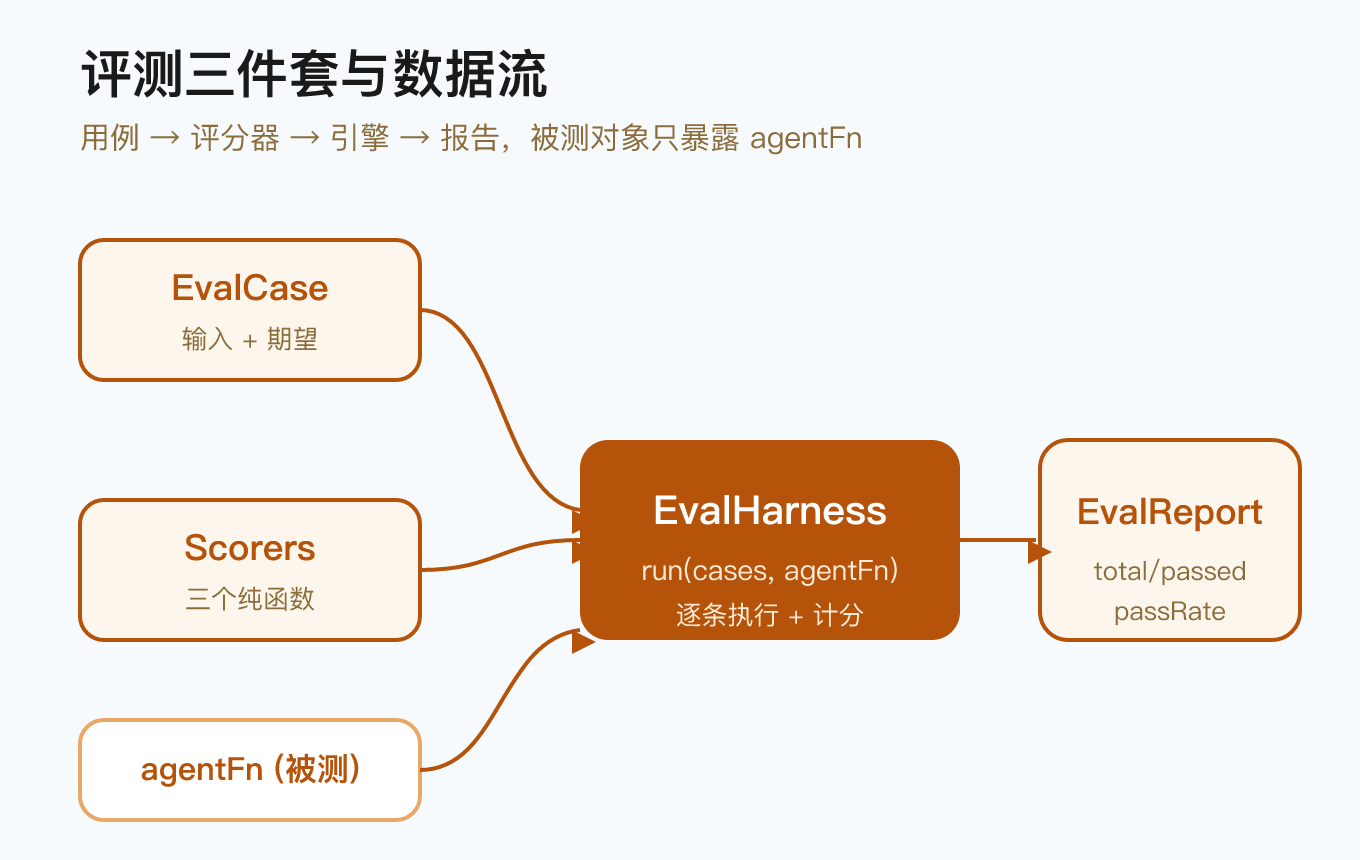
我们把一套最小可用的评测拆成三块,彼此解耦,谁都能单独替换:
- 用例(EvalCase):一道题 = 一个输入 + 一份期望。期望支持三种判定方式,后面展开。
- 评分器(Scorers):纯函数,拿到「实际输出」和「期望」返回布尔值,互不影响。
- 评测引擎(EvalHarness):把用例挨个喂给被测对象,调用评分器,汇总成一份报告。
被考的对象是一个函数 agentFn(input: string): string,它只承诺「吃一个字符串、吐一个字符串」。至于它内部是走 Mock、走本地规则、还是真去调大模型,引擎一概不管。这个解耦意味着:同一套引擎,开发期用 Mock,联调期换真模型,回归期换线上快照,代码零改动。
三、数据模型:EvalCase
用例是评测的最小单元,结构越简单越好,方便你把它存成 JSON 或写进表格里批量维护:
export type ExpectationType = 'contains' | 'equals' | 'regex';

export interface Expectation {
  type: ExpectationType; // 判定方式
  value: string;         // 期望内容或正则串
}

export interface EvalCase {
  id: string;       // 用例编号,报告里作为唯一键
  input: string;    // 喂给被测 agent 的输入
  expect: Expectation; // 期望判定
}
type 决定怎么比:contains 看实际输出里有没有出现期望串,适合「答案里必须提到某关键词」;equals 要求整段完全相等,适合「结构化、可枚举的标准答案」;regex 用正则命中,适合「日期、编号、邮箱这类有格式但内容不固定的字段」。
选哪种 type 是有讲究的。能容忍表达变化的答案(「翻译」「解释」类)用 contains,只要关键词在就放过,避免同一意思换来换去天天误报;答案本身是结构化、可枚举的(状态码、固定话术)用 equals,卡得严反而能抓出格式漂移;字段带格式但内容浮动的(日期 \d{4}-\d{2}-\d{2}、订单号 ORD\d+)用 regex。一个经验法则:先用最松的 contains 兜底防回归,再对少数关键路径收紧到 equals,既稳又不至于噪声爆炸。
四、评分器:三个纯函数
评分器是整套评测里最容易单测、也最该单测的部分。它们不碰网络、不碰 UI,输入输出确定:
export function scoreContains(actual: string, value: string): boolean {
  return actual.includes(value);
}

export function scoreEquals(actual: string, value: string): boolean {
  return actual === value;
}

export function scoreRegex(actual: string, pattern: string): boolean {
  try {
    const re: RegExp = new RegExp(pattern);
    return re.test(actual);
  } catch (e) {
    return false; // 非法正则不抛错,避免一套评测被一个坏用例拖垮
  }
}
这里有个工程细节值得强调:scoreRegex 必须把 new RegExp 包在 try/catch 里。正则表达式写错(比如少写半个括号)时,ArkTS 运行时会抛 SyntaxError。如果评分器直接崩,整批评测都会中断。我们宁可让这条「判定本身非法」的用例判为不通过,也要保证其余用例照常跑完——评测引擎的稳定性,优先级高于单条用例的判定。
评分器之间也建议保持「正交」:不要在一个用例里既要求 contains 又要求 regex,那是把两个判定揉进一条期望,排错时会分不清到底哪条没满足。真要组合,就在评测集里放两条用例,分别卡不同维度——评测报告里的「失败原因」才会指向明确。
五、评测引擎:run 出一份报告
引擎负责把用例逐条执行、计分、汇总。agentFn 抛错时,该条记作空输出(自然判失败),绝不让一条坏用例中断整场考试:
export interface EvalItem {
  id: string; pass: boolean; score: number; detail: string;
}
export interface EvalReport {
  total: number; passed: number; failed: number;
  passRate: number; items: EvalItem[];
}

export function run(cases: EvalCase[], agentFn: (input: string) => string): EvalReport {
  const items: EvalItem[] = [];
  let passed: number = 0;
  for (const c of cases) {
    let actual: string = '';
    try { actual = agentFn(c.input); } catch (e) { actual = ''; }
    const ok: boolean = score(c.expect, actual);
    if (ok) { passed++; }
    items.push({ id: c.id, pass: ok, score: ok ? 1 : 0, detail: '实际输出: ' + actual });
  }
  const total: number = cases.length;
  const failed: number = total - passed;
  const passRate: number = total === 0 ? 0 : passed / total;
  return { total, passed, failed, passRate, items };
}
注意 passRate 的计算:total 为 0 时直接返回 0,而不是做 0 / 0(那会得到 NaN,污染你的报告与阈值判断)。这条分支单测里一定要覆盖——空用例列表是评测接入初期非常常见的状态(你还没来得及写题)。
score 这个分发函数对未知 type 统一返回 false,而不是抛错或默认放行。默认放行会让写错类型的用例「假绿」,比默认判失败更危险——假绿会悄悄骗过你的阈值护栏。所以未知类型宁可判失败,逼你在用例里把 type 写对。
六、离线 MockAgent:让 Demo 不联网也能跑
演示阶段我们不想真去调模型,于是造一个按关键词返回固定文案的 MockAgent。它证明的是「引擎与评分器能正确工作」,真实接入时整体替换即可:
export function mockAgentFn(input: string): string {
  const table: Array<[string, string]> = [
    ['天气', '今天晴,气温 22 到 28 度,适合外出。'],
    ['翻译', 'Hello World 的中文翻译是:你好,世界。'],
    ['计算', '2 加 3 等于 5。'],
    ['定义', 'Agent 是能感知环境并自主决策执行任务的智能体。']
  ];
  for (const pair of table) {
    if (input.includes(pair[0])) { return pair[1]; }
  }
  return '抱歉,我暂时无法处理该问题。';
}
七、演示页:通过率卡片 + 逐条明细
Index.ets 在 aboutToAppear 里直接跑评测,把报告渲染成一张汇总卡片加一个明细列表。这里我刻意保留了一条失败用例(E05 期望「下雨」,但 Mock 说「晴」),就是为了让你在界面上亲眼看到「失败数」是被正确计数的,而不是只显示一片绿:
aboutToAppear(): void {
  const cases: EvalCase[] = [
    { id: 'E01', input: '今天天气怎么样', expect: { type: 'contains', value: '晴' } },
    { id: 'E02', input: '把 Hello 翻译成中文', expect: { type: 'contains', value: '你好' } },
    { id: 'E03', input: '算一下 2 加 3', expect: { type: 'equals', value: '2 加 3 等于 5。' } },
    { id: 'E04', input: '什么是 Agent', expect: { type: 'regex', value: '智能体' } },
    { id: 'E05', input: '今天天气怎么样', expect: { type: 'contains', value: '下雨' } }
  ];
  this.report = run(cases, mockAgentFn);
}
界面上 passRate 用 (this.report.passRate * 100).toFixed(1) + '%' 显示,通过率低于 80% 时卡片数字变橙、失败数变红,一眼能看出这一版「挂了哪几题」。
八、接进真项目:只换 agentFn
当你的 Agent 真正接好大模型后,把演示里的 mockAgentFn 换成你的被测对象即可,引擎与评分器一字不改:
import { Agent } from '../feature/agent/Agent';
const agent = new Agent(client, '你的系统提示', '你的模型');
this.report = run(cases, (input: string): string => {
  return agent.send(input); // 只要返回字符串,评测就能跑
});
如果 agent.send 是异步的,把 agentFn 改成 async 并在 run 里 await 即可——这里为了离线演示写成同步。接入时还有一处容易忽略:被测对象可能部分成功、部分失败。比如某个工具调用超时,agent 兜底返回了「稍后再试」。这种输出在评测里应当如何判定,要在写用例时就约定清楚——要么用 contains 卡「稍后再试」作为该场景的预期答案,要么把它归为失败并单独统计。约定模糊,报告就会自相矛盾。
九、工程化:把评测做成回归护栏
评测集真正的价值不在「跑一次看个乐」,而在「每次改代码都跑、都存档、都比对」。几条落地建议:
- 黄金用例沉淀自真实对话。用例不是凭空拍脑袋写的,而是从用户真实提问与期望答案里抠出来的。覆盖高频意图、边界意图、易错意图三类。
- 设阈值,不盯绝对值。别只说「通过率 83%」,而要定「低于 90% 不许合并」。阈值随用例库成熟逐步上调。
- 纳入改版前验收。每次动提示词、动工具、动模型,先跑评测集再提测,把「悄悄改坏老功能」的概率压到最低。
- 用例也要版本管理。新增能力加新用例,删除能力删用例,用例库和代码一起进评审。
这套思路与 Hypium 单测天然契合:底座层(重试、解析、记忆)走 @ohos/hypium 单元测试,评测层(评分、聚合、阈值)同样可以写进 ohosTest,在 CI 里一并执行。
用例库本身也建议分层:最上面一层是「冒烟用例」,十几条覆盖核心意图,每次提交必跑,秒级出结果;中间一层是「回归用例」,把历史上踩过的坑逐条固化,防止老问题复活;最下面一层是「边界用例」,喂极端输入(超长、空串、特殊符号)验证 agent 不崩。三层各管各的节奏,既不拖慢日常提交,又能兜住深层风险。
十、避坑清单
实际搭评测集时,有几个坑踩过一次就够:
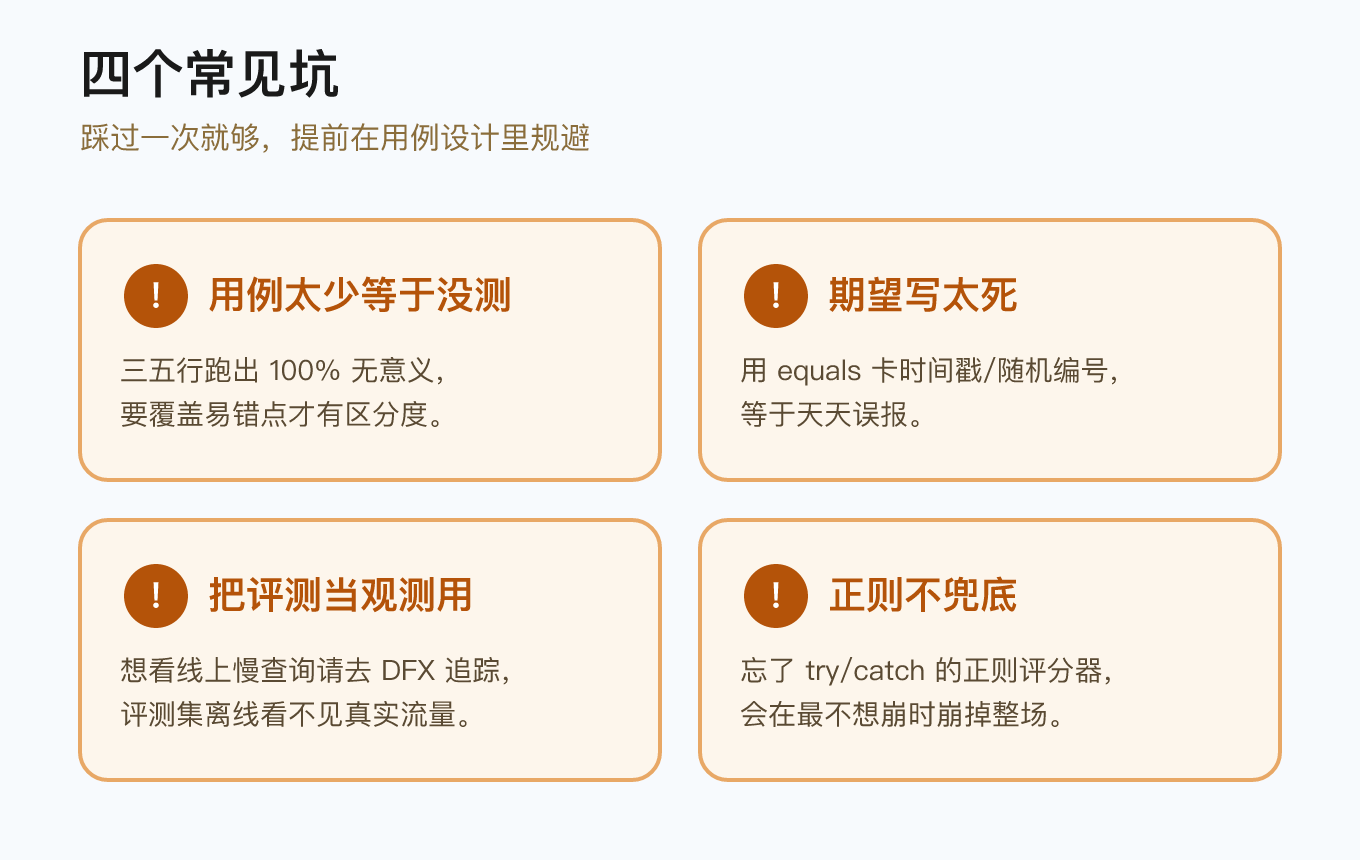
- 用例太少等于没测。三五行用例跑出 100% 通过率毫无意义,要覆盖「易错点」才有区分度。
- 期望写太死。用
equals去卡一个会变的时间戳或随机编号,等于天天误报。能容忍变化的字段用regex或contains。 - 把评测当观测用。想看线上慢查询,请去第 32 篇的 DFX 链路追踪,评测集离线、同步、看不见线上真实流量。
- 正则不兜底。忘了
try/catch的正则评分器,会在你最不想崩的时候崩掉整场回归。 - 只看总分不看明细。通过率 90% 可能意味着「核心 10 题挂了 1 题」,而那 1 题恰恰是最不能错的。报告要逐条打开看,尤其关注
failed列表里的detail字段——它存着实际输出,是定位问题的第一手线索。
把质量关从「上线后救火」前移到「改代码前验收」,评测集就是你和 Agent 之间那份可复用的契约。
十一、一份可照抄的最小落地清单
如果你今天就想把评测集接进项目,按这个顺序走,半小时能跑通:
- 把
feature/eval/四个文件(EvalCase / Scorers / EvalHarness / MockAgent)原样拷进工程。 - 在
Index.ets的aboutToAppear里先放 5 条contains用例,跑通看报告。 - 把
mockAgentFn换成你的agent.send,确认真模型能稳定吐出字符串。 - 把高频错误意图补成
equals/regex用例,逐步把阈值抬到 90%。 - 把这套用例连同
ohosTest里的 Hypium 断言一起,配进提交前检查。
做到第 3 步,你已经有了一个能反复跑的回归基线;做到第 5 步,质量护栏才算真正合拢。
参考与出处
- 鸿蒙开发者文档 · ArkTS 语言入门:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V5/arkts-get-started-V5
- 鸿蒙开发者文档 · ArkTS 编码规范与语法约束:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V5/arkts-coding-conventions-V5
- 鸿蒙开发者文档 · 应用单元测试(Hypium):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V5/unit-test-V5
最后一句:把质量关从「上线后救火」前移到「改代码前验收」,评测集就是你和 Agent 之间那份可复用的契约。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献136条内容

所有评论(0)