【共创稿事节】HarmonyOS 7 Agent 开发实战 07:多 Agent 任务分解与反思
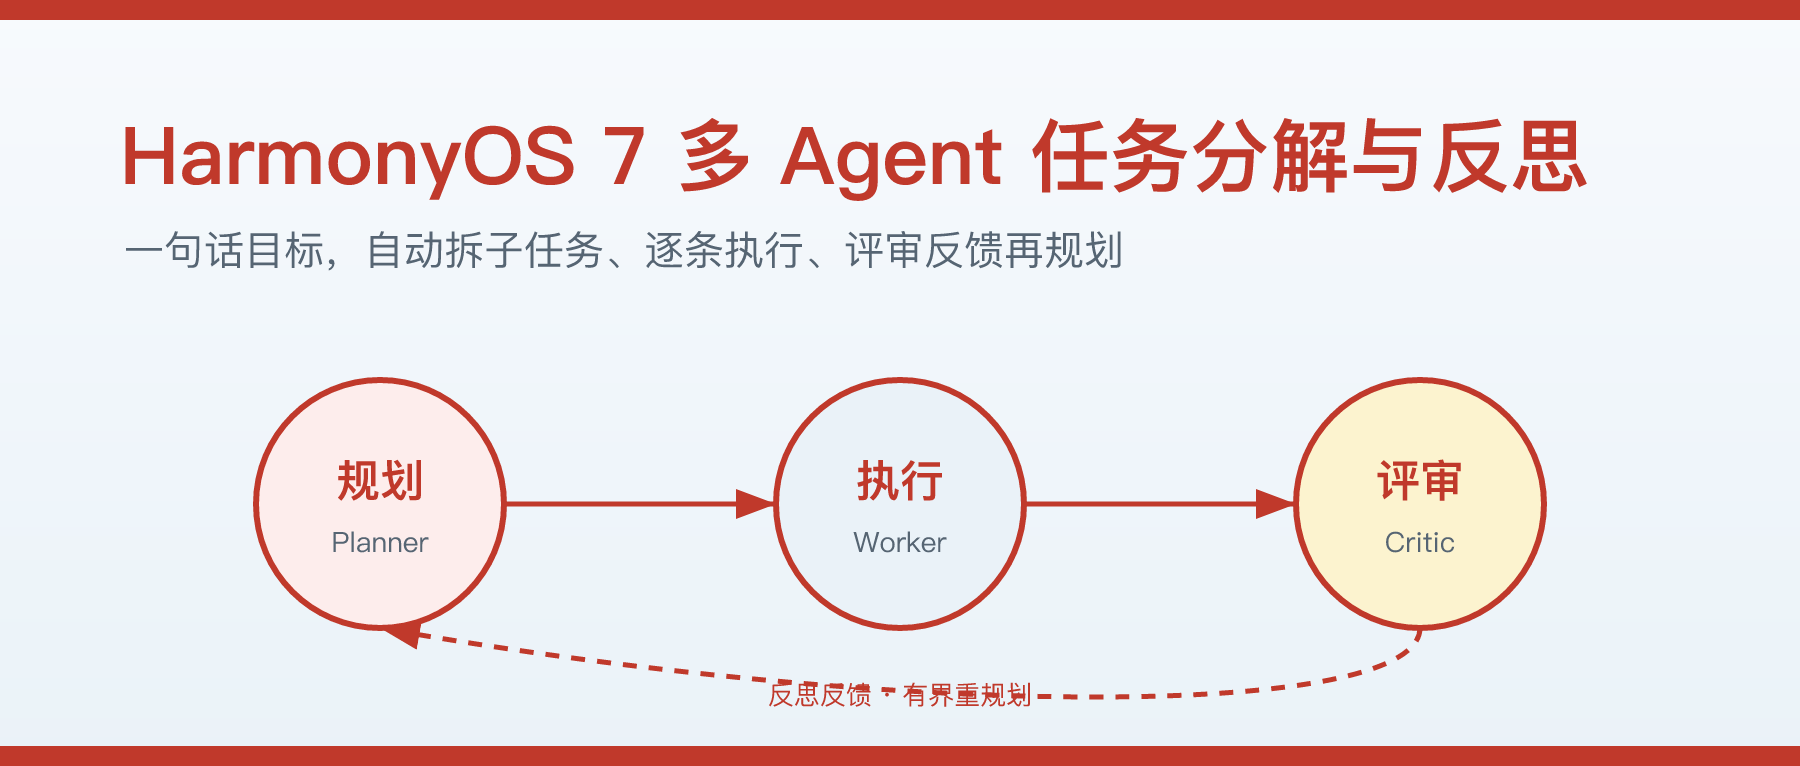
前几篇我们一直在打磨"单个 Agent":01 篇搭好统一的 LLM 底座与重试策略,02 篇补上对话记忆,03 篇让模型学会调工具,04 篇用检索增强让它有据可答。但真实任务往往一句话里塞了三件事——“调研竞品,输出对比报告,给出落地建议”。让一个 Agent 一口气全做完,中间步骤会被压缩,错了也不知道错在哪。这一篇把镜头拉远:在 HarmonyOS 7 上用三个各司其职的角色——规划、执行、评审——把"任务分解 + 自我反思"跑成一条可测试的流水线。
先把边界划清楚:本篇讲的是单设备上的多角色任务分解与反思,不是跨设备的多智能体协商。系列后面讲 A2A 时,智能体之间会对等交换意图、互相协商;这里的三种角色只是同一个应用里的三段纯逻辑,彼此不通信、不协商,只有编排器单向调度它们。这个区分在架构评审里经常被追问,值得先讲明白。
一、为什么"分解 + 反思"是 Agent 的基本功
大模型直接面对复杂目标的典型症状是"一步到位":想一次性给出最终答案,过程不可见,结果不可纠。把目标拆成子任务再逐个执行,有两个直接收益:
- 可观测:每一步的输入输出都是独立字符串,哪个子任务出了问题一目了然,页面可以逐条渲染;
- 可纠错:评审角色对结果打分,不满意就把反馈回灌给规划器重新拆解——这就是"反思",也是本篇标题里"反思"二字的来源。
拿开头那个目标举例。直连模式下,模型被要求一次输出"竞品调研 + 对比报告 + 落地建议",往往前两部分写得认真,第三部分开始敷衍,而且你没法只重做第三部分。分解之后,三个子任务各自独立执行、独立留痕,评审发现"落地建议"太薄,可以精准地只对它重规划。粒度带来的不只是质量,还有可运维性——这是把"大任务"变"小任务"之后最容易被低估的收益。
本篇的三个角色全部是确定性纯函数:不联网、不依赖设备、没有隐藏状态。这带来一个很实际的工程好处——同样的逻辑可以在 Node 里镜像跑断言做预检,也可以在 DevEco 里用 Hypium 做回归,两边结论互为印证。这是纯逻辑分层从 01 篇延续下来的红利。
二、三个角色,各管一段
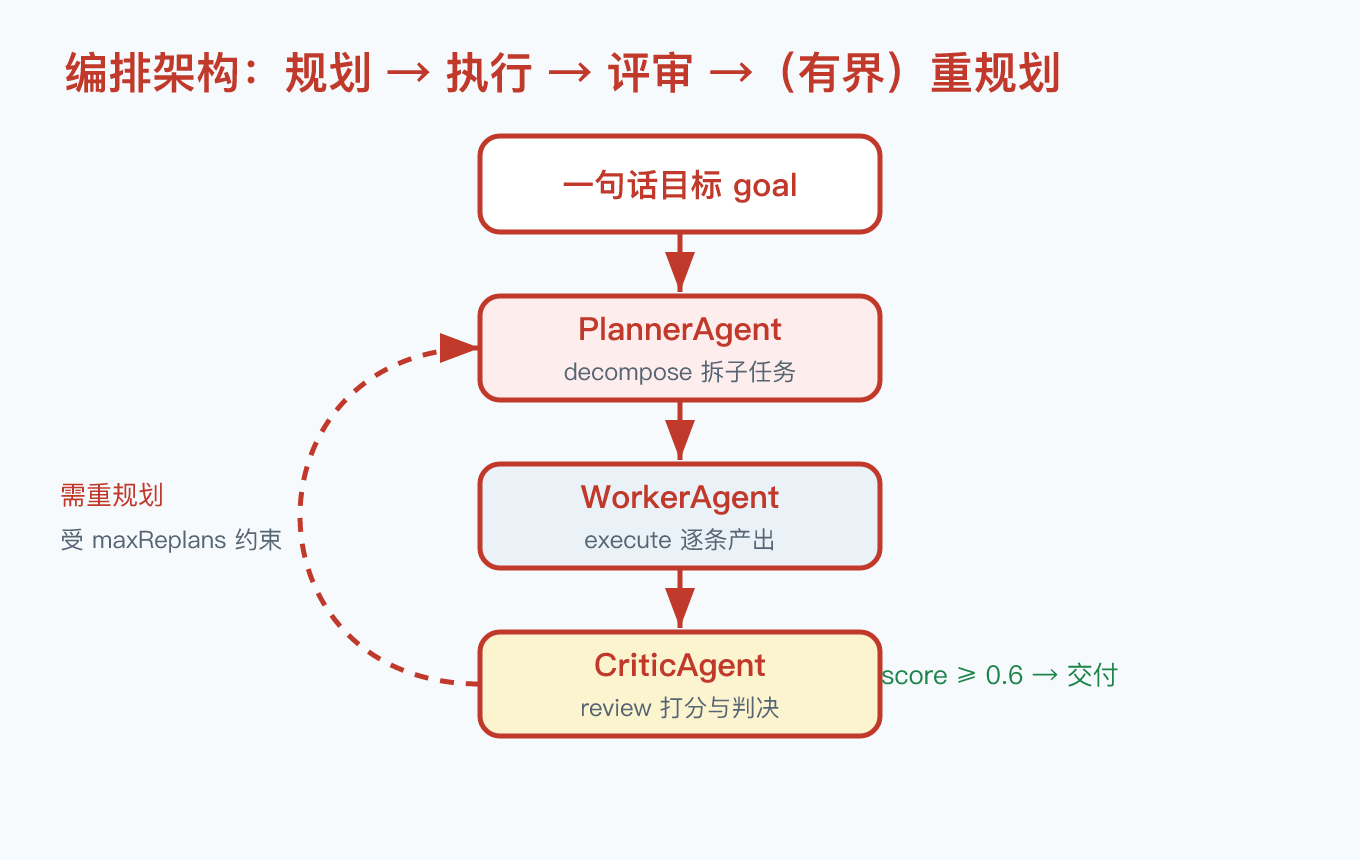
PlannerAgent(规划):decompose(goal) 把目标按中英文标点(,。、;;,)切成子任务;整句里一个分隔符都没有时,回退到固定三步模板,保证任何输入都有一条可执行的计划。
export interface SubTask {
  id: number;
  description: string;
}

const FALLBACK_TEMPLATE: string[] = [
  '明确目标的边界与成功标准',
  '拆解为核心可执行步骤',
  '执行并汇总自检结果'
];

export class PlannerAgent {
  decompose(goal: string): SubTask[] {
    const descs: string[] = this.hasDelimiter(goal)
      ? this.splitGoal(goal)
      : FALLBACK_TEMPLATE.slice();
    const finalDescs: string[] = descs.length > 0 ? descs : FALLBACK_TEMPLATE.slice();
    const tasks: SubTask[] = [];
    for (let i = 0; i < finalDescs.length; i++) {
      tasks.push({ id: i + 1, description: finalDescs[i] });
    }
    return tasks;
  }
  // hasDelimiter:目标中是否出现过任意分隔符
  // splitGoal:逐字符扫描,遇分隔符收尾一段,空段丢弃,首尾空白去除
}
注意 hasDelimiter 的判断维度:目标里是否出现过分隔符,而不是"切完剩几段"。一句没有标点的话切完只有一段,但它需要的不是单步执行,而是模板兜底的三步走。这个细节曾让首版实现把"做个年度计划"拆成了一步,单测立刻抓住了。
WorkerAgent(执行):execute(subtask, context) 对单个子任务产出一段结果。演示里返回确定性的 完成[编号]: 描述 -> 产出编号,真实项目把这一行换成工具调用或模型推理即可,编排层完全不用改。
CriticAgent(评审):review(goal, results) 用启发式打分——每条结果非空且长度达到 MIN_LEN(本例 8 字符)记为达标,全部达标给满分 1.0;否则按达标比例给分,低于 0.6 触发 needsReplan。完整实现如下:
export class CriticAgent {
  review(goal: string, results: string[]): CriticVerdict {
    if (results.length === 0) {
      return { score: 0, needsReplan: true, feedback: '没有任何执行结果,需要重规划' };
    }
    let okCount: number = 0;
    for (const r of results) {
      if (r.trim().length >= MIN_LEN) {
        okCount++;
      }
    }
    if (okCount === results.length) {
      return { score: 1.0, needsReplan: false, feedback: '全部子任务产出达标' };
    }
    const score: number = okCount / results.length;
    return {
      score: score,
      needsReplan: score < REPLAN_THRESHOLD,
      feedback: score < REPLAN_THRESHOLD ? '部分产出不足,建议重规划' : '大部分达标,可交付'
    };
  }
}
分数不是重点,feedback 才是:它会被回灌给规划器,成为下一轮拆解的输入。评审器的判决结构(分数、是否重规划、反馈文本)是一个纯数据接口,今天用启发式实现,明天换成大模型评审,编排器一行代码都不用动。
三、Orchestrator:把三段串成有界循环
export class Orchestrator {
  run(goal: string, maxReplans: number = 1): OrchestratorResult {
    let plan: SubTask[] = this.planner.decompose(goal);
    let results: string[] = this.worker.executeAll(plan, '');
    let verdict: CriticVerdict = this.critic.review(goal, results);
    let replanned: boolean = false;
    let replanCount: number = 0;

    while (verdict.needsReplan && replanCount < maxReplans) {
      replanned = true;
      replanCount++;
      const newGoal: string = goal + ';反思反馈:' + verdict.feedback;
      plan = this.planner.decompose(newGoal);
      results = this.worker.executeAll(plan, verdict.feedback);
      verdict = this.critic.review(goal, results);
    }
    return { plan, results, score: verdict.score, replanned };
  }
}
三个关键设计:
- 终止性:
replanCount < maxReplans是循环唯一的继续条件,评审器再怎么打低分,循环也最多转maxReplans圈。只要这一条在,编排器就不可能死循环; - 反馈回灌:重规划时把
feedback追加到目标字符串里,规划器下一轮"看得见"上次差在哪,这就是反思闭环的物理载体; - 依赖注入:三个角色都从构造参数传入,缺省才用默认实现。单测时可以注入一个永远打低分的 mock 评审器,精确验证"恰好重规划一次后收敛",也能验证
maxReplans=3时评审恰好被调用 4 次。
四、在 DevEco 里跑起来
演示页只做一件事:输入目标,点"运行编排",看到计划、逐条产出、评审分、是否发生过重规划。页面同时接了一个 MockLlmClient——继承 01 篇的 LlmClient 底座,超时、重试与响应解析照常复用,只是不联网:
export class MockLlmClient extends LlmClient {
  protected async sendOnce(_req: ChatRequest): Promise<string> {
    return JSON.stringify({
      choices: [{ message: { content: '(演示)已基于编排给出结论' }, finish_reason: 'stop' }]
    });
  }
  // buildPayload / buildHeaders / classifyError 按底座契约同样实现
}
它把编排结论转成一句"LLM 旁注",证明大模型通道随时可以接进来。真实项目里换成 LlmClientFactory.create('openai', {...}) 即可,页面与编排层的代码零改动。
const orch: Orchestrator = new Orchestrator();
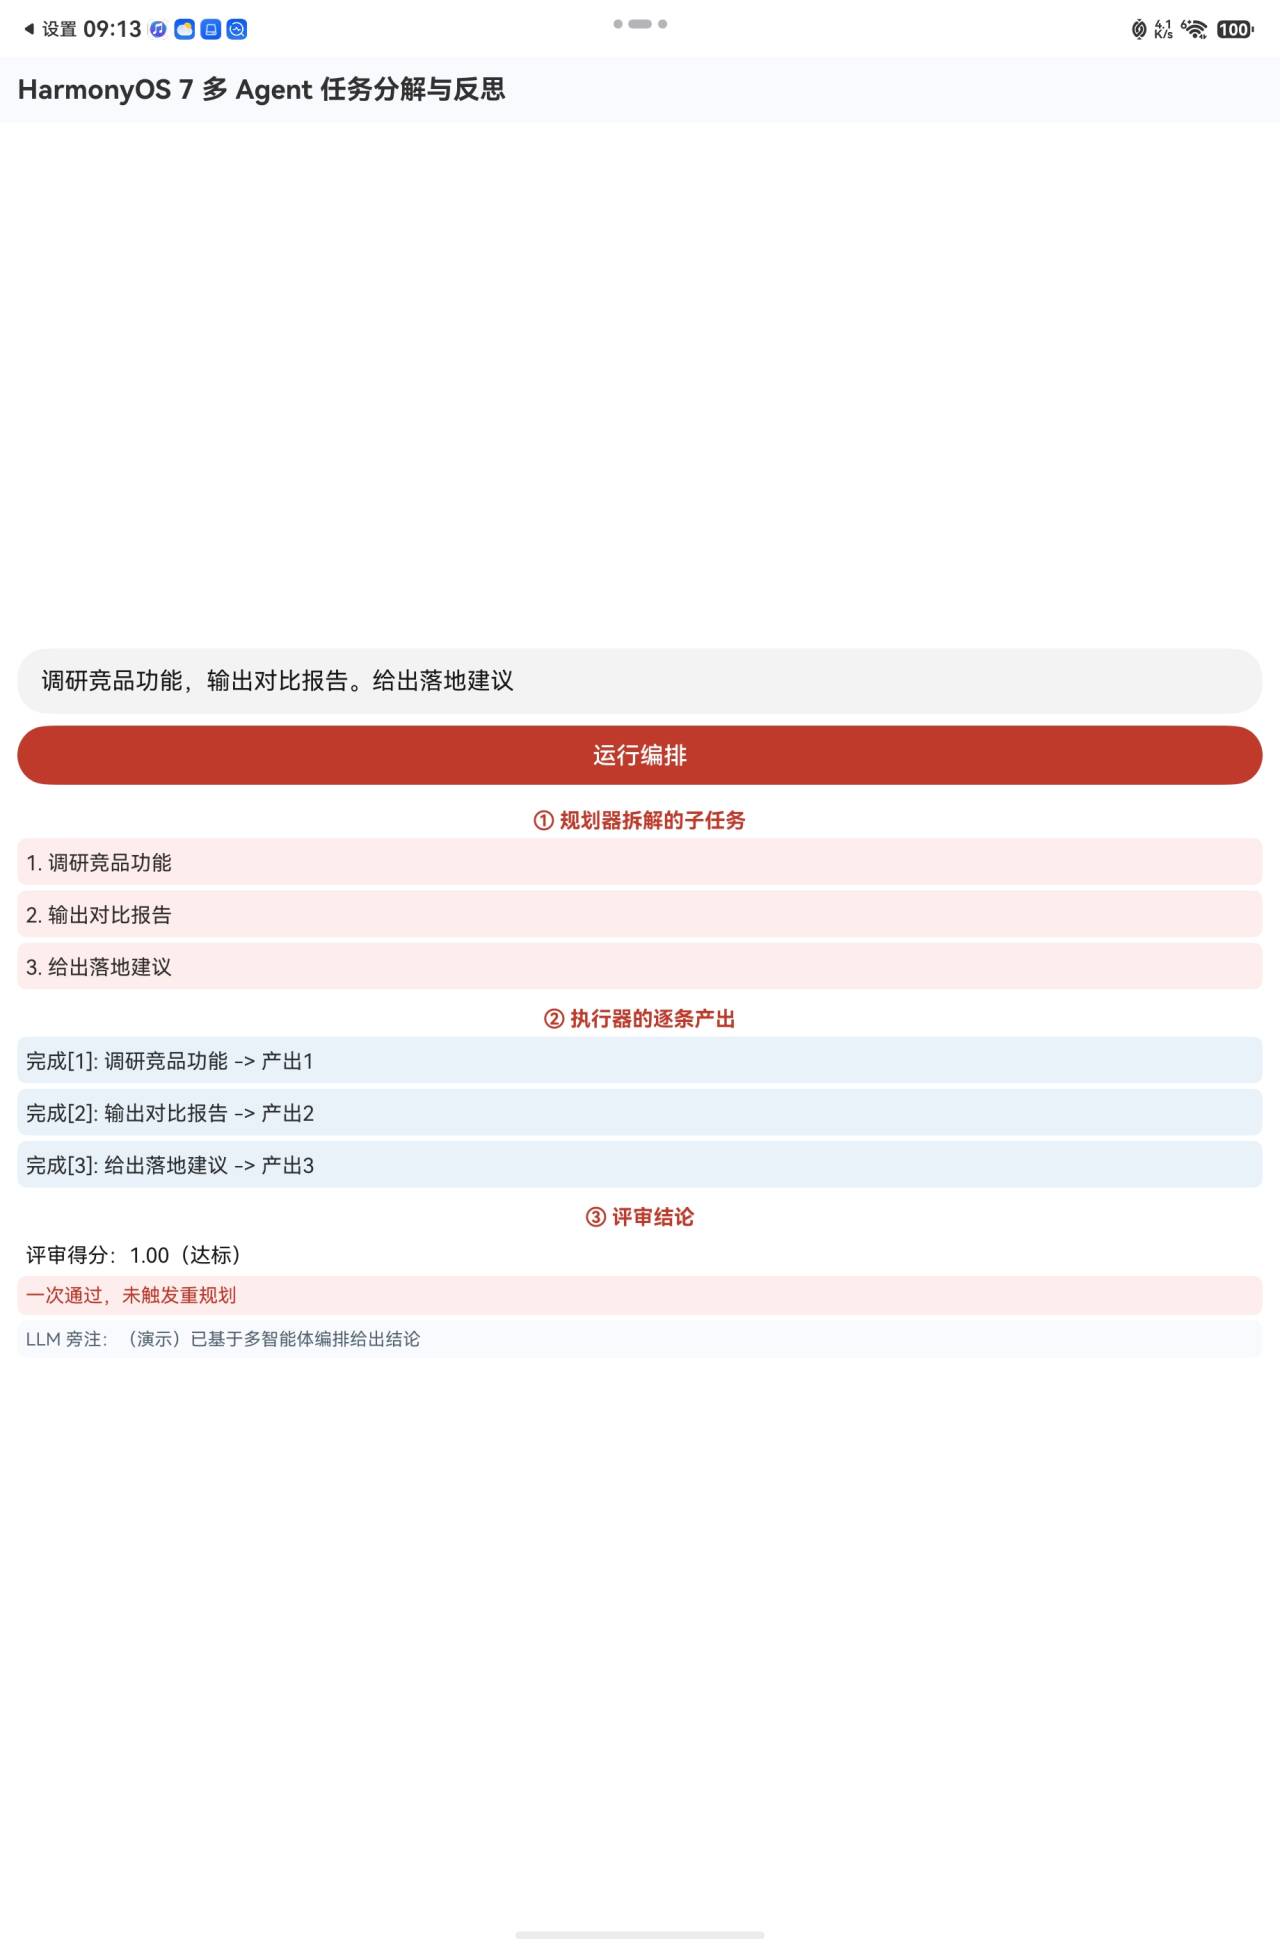
const res = orch.run(this.goal, 1);
this.planLines = res.plan.map((t): string => t.id + '. ' + t.description);
this.resultLines = res.results;
this.replanText = res.replanned ? '本次发生了重规划' : '一次通过,未触发重规划';
验证分两层。Node 镜像层跑 22 条断言:分隔符切分计数、无分隔符走模板、空目标兜底、好评分不重规划、低分恰好一次重规划、maxReplans=3 时评审恰好 4 次后终止、聚合结果与计划一一对应。Hypium 层共 29 个用例,覆盖同一批场景外加底座回归(RetryPolicy 分类与退避、ResponseParser 解析、ConversationStore 裁剪、Agent 编排、ChatUIMessage 映射)。两层都绿,才敢说这条流水线是稳的。
"恰好一次重规划"这条最值得展开,它靠注入 mock 评审器实现:
class LowScoreCritic extends CriticAgent {
  calls: number = 0;
  review(goal: string, results: string[]): CriticVerdict {
    this.calls++;
    return { score: 0.3, needsReplan: true, feedback: 'mock 不达标' };
  }
}

it('低分:恰好发生一次重规划后终止', 0, () => {
  const critic = new LowScoreCritic();
  const res = new Orchestrator({ critic }).run('目标一,目标二。目标三', 1);
  expect(critic.calls).assertEqual(2); // 初评 + 重规划后复评,恰好一轮
  expect(res.replanned).assertTrue();
});
评审器被调用两次,意味着初评一次、重规划后复评一次,然后循环条件 replanCount < maxReplans 失败退出。终止性不是靠"希望它停下来",而是靠一个可以被断言的结构性质——这是编排器区别于"随手写个 while"的地方。
运行效果截图:
五、从演示到生产:把 Worker 换成真活
演示版的 Worker 返回占位字符串,迁到生产只需三步,方法签名一律不动:
- 接入真实执行:在
execute里调用LlmClient.chat或某个工具,把子任务描述组装进提示词; - 串起上下文:
context参数此时派上用场——把前序子任务的产出拼接进去,子任务之间就有了依赖链,不再是孤岛; - 升级评审:把启发式的
MIN_LEN换成大模型评审,让它输出结构化的分数与反馈,判决接口CriticVerdict保持不变。
唯一要留意的结构性变化:Worker 变成异步后,run 也随之变成 async,但循环上界 maxReplans 的写法原样保留。换句话说,无论三个角色内部多复杂,"有界反思循环"这个骨架是整个编排器的不变量——改血肉,别改骨架。
六、避坑指南
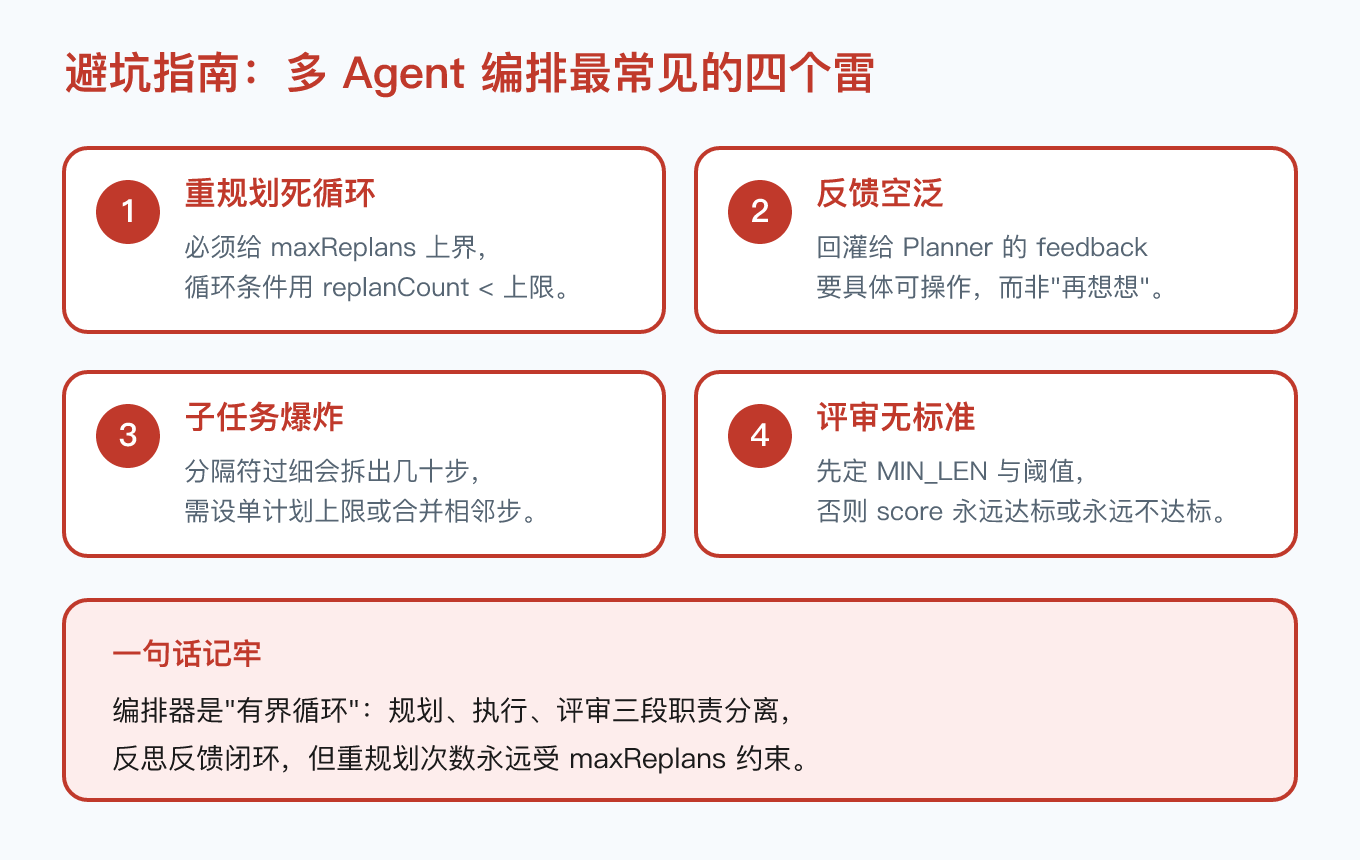
结合源码,四个最容易踩的雷:
- 重规划死循环:忘了
maxReplans上界,评审器持续打低分时页面直接卡死。循环条件必须是replanCount < maxReplans,且计数器在进入循环体时自增,别放在循环末尾; - 反馈空泛:feedback 写"结果不好,重新想想",规划器收到的等于没有。哪怕启发式评审,也要输出"哪几条不达标、差在哪"级别的具体描述,LLM 评审时同理;
- 子任务爆炸:用户目标里有十个逗号就会拆出十步。工程上应给单条计划设上限(比如 8 步),超出就合并相邻步骤,否则执行成本和 UI 都撑不住;
- 评审无标准:
MIN_LEN与 0.6 阈值要和业务对齐。阈值定 0.9,两步里错一步就永远重规划;定 0.3,评审形同虚设。标准先于代码定下来,写进测试。
还有一条工程习惯值得坚持:三个角色保持纯函数。别在 Planner 里偷偷发请求,别在 Critic 里读数据库。纯函数才能在 Node 里秒级镜像、在 Hypium 里稳定回归——这也是本系列一以贯之的分层原则:底座、编排、UI 各管各的,谁也不越界。
六、和"多智能体协商"的区别,再强调一次
| 维度 | 本篇:任务分解与反思 | 系列后续:A2A 多智能体协商 |
|---|---|---|
| 角色关系 | 编排器单向调度三段逻辑 | 智能体对等协商 |
| 通信方式 | 同进程函数调用 | 跨设备、跨进程消息 |
| 终止条件 | maxReplans 数值上界 | 协商轮次或共识达成 |
| 典型场景 | 拆解、执行、自检 | 意图交换、能力发现 |
一句话概括:本篇的三个角色是同一张流程图上的三站,协商场景里的多个智能体是各自流程图的主人。搜"多 Agent"资料时两者经常混在一起讲,动手前先问自己要的是哪一种。
参考与出处
- HarmonyOS 开发者官网主页:https://developer.huawei.com/consumer/cn/doc/harmonyos-home
- ArkTS 语言介绍(官方指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V5/arkts-overview
- UIAbility 与页面生命周期(官方参考):https://developer.huawei.com/consumer/cn/doc/harmonyos-references-V5/js-apis-app-ability-uiability
- ArkUI 声明式开发范式(官方指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V5/arkts-ui-development
- 应用测试框架 Hypium(官方指南):https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V5/application-test-framework
最后一句:让规划的有章法、执行的有产出、评审的有标准,Agent 才算真正学会了"想清楚再做,做完再想"。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 0
 0
- 0


 已为社区贡献134条内容

所有评论(0)