灯光模拟HarmonyOS应用实战-58-搜索命中前40题不等于最相关:用MatchScore构建稳定TopK
灯光模拟HarmonyOS应用实战-58-搜索命中前40题不等于最相关:用MatchScore构建稳定TopK
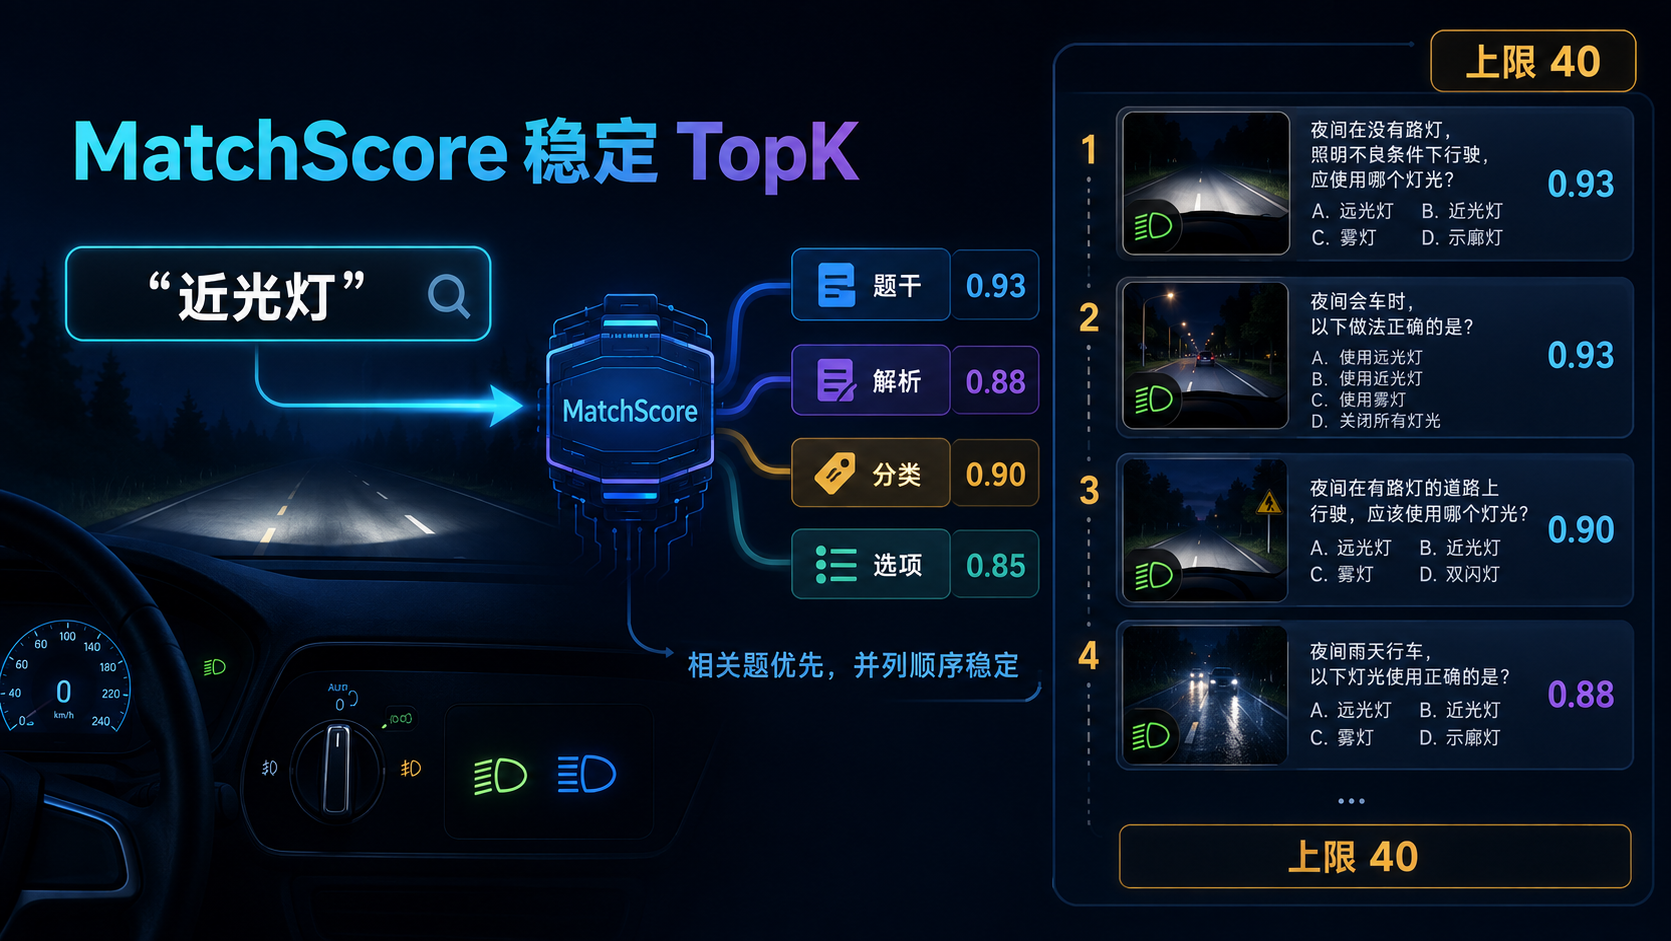
题库搜索最容易产生一种“看起来没问题”的偏差:输入“近光灯”后确实有结果,列表也没有超过40条,但最贴近题干的内容不一定排在前面。原因不一定是没有命中,而可能是命中规则只有真假,没有相关程度。只要某题的解析、分类或任一选项包含关键词,它就进入结果数组;数组达到上限后遍历立即结束,后面的题即使标题更贴近,也没有参与比较的机会。
The_kemusan 的题库包含手写题和批量生成题,顺序同时受构建函数、科目追加顺序和生成数量影响。让源码顺序直接决定搜索前40条,会把“数据怎样组织”悄悄变成“用户先看到什么”。本文用 MatchScore 把命中位置、匹配强度和稳定并列规则写清,再通过稳定 TopK 选择固定数量的结果,使同一题库、同一查询能够得到可解释且可复现的顺序。
一、当前实现先命中先进入,满40条就停止
Index.ets 第92行把 QUESTION_BANK_RESULT_LIMIT 设为40。第1138—1159行对 BUILTIN_QUESTIONS 从头遍历,先过滤当前科目,再规范化题目并调用 isQuestionMatched();一旦结果数量达到40就 break。第1161—1176行依次查看题干去前缀后的文本、解析、分类和选项,只要一个字段包含关键词就返回 true。
const QUESTION_BANK_RESULT_LIMIT: number = 40;

for (let index = 0; index < BUILTIN_QUESTIONS.length; index++) {
  const rawQuestion = BUILTIN_QUESTIONS[index];
  if (rawQuestion.subject !== this.questionBankSubject) {
    continue;
  }
  const question = normalizeQuestion(rawQuestion);
  if (this.isQuestionMatched(question, keyword)) {
    result.push(question);
    if (result.length >= QUESTION_BANK_RESULT_LIMIT) {
      break;
    }
  }
}
这段代码的时间开销有明确上界倾向:收集满40条后不再扫描。不过,它没有比较题干命中与解析命中的差别,也没有比较完整词组、前缀和普通包含的差别。因此“前40条”只能解释为当前源数组中较早出现的40条匹配项,不能解释为相关程度最高的40条。
| 当前行为 | 带来的确定结果 | 仍然缺失的信息 |
|---|---|---|
| 按题库顺序扫描 | 相同数组通常得到相同先后 | 题库重排会改变搜索顺序 |
| 任一字段包含即命中 | 不容易漏掉解析或选项中的词 | 不知道关键词命中了哪里 |
| 满40条停止 | 列表规模受控 | 后续高相关候选未参与比较 |
| 空关键词清空列表 | 避免展示全部题库 | 未保存查询与结果口径 |
二、相关性需要拆成字段与强度两层
一个可读的计分规则不必复杂。先定义字段权重,再定义同一字段内的匹配强度。对于灯光题库,题干是用户最直接看到的内容,权重应高于解析;分类精确命中可以帮助搜索“夜间场景”,选项命中则作为补充召回。
interface FieldMatch {
  field: 'title' | 'category' | 'explanation' | 'option';
  strength: 'exact' | 'prefix' | 'contains';
  points: number;
}

interface MatchScore {
  total: number;
  matches: FieldMatch[];
}

const FIELD_BASE = {
  title: 400,
  category: 240,
  explanation: 120,
  option: 60
};
分值不是产品真理,它只是把排序意图数字化。使用相差明显的整数,可以让“题干普通包含”仍优先于“某个选项普通包含”。matches 保留得分理由,便于在开发阶段解释某题为什么靠前;正式界面不一定要展示内部明细,也不应把完整答案信息写进日志。
权重表应作为版本化策略集中保存。若后来发现用户更常按分类词搜索,可以调整分类基数,但调整必须伴随固定查询集的前后对比,不能为了某一个例子临时改数字。
三、先规范查询,再做大小写一致的比较
当前代码对关键词调用 trim().toLowerCase(),对各字段也调用 toLowerCase()。可以保留这个基础行为,同时把空白折叠、题号前缀处理和字段准备集中起来。不要在每个计分分支里重复规范化,否则同一字段可能使用不同规则。
function normalizeSearchText(value: string): string {
  return value
    .trim()
    .toLowerCase()
    .replace(/\s+/g, ' ');
}

function matchStrength(text: string, query: string): number {
  if (text === query) {
    return 3;
  }
  if (text.startsWith(query)) {
    return 2;
  }
  if (text.indexOf(query) >= 0) {
    return 1;
  }
  return 0;
}
这里没有擅自做拼音、同义词或中文分词。对于“近光灯”这类短词,确定性的子串比较更容易说明。若业务以后需要“近灯”也召回“近光灯”,应另建词典或分词层,并记录所用版本;不能把模糊规则藏进 normalizeSearchText(),否则结果变化很难定位。
输入为空时应在计分前直接返回空结果,不能让空字符串对所有文本都产生包含命中。长度限制、控制字符处理以及超长输入的提示,也应属于查询边界,而不是每道题的评分逻辑。
四、MatchScorer为每个命中保留理由
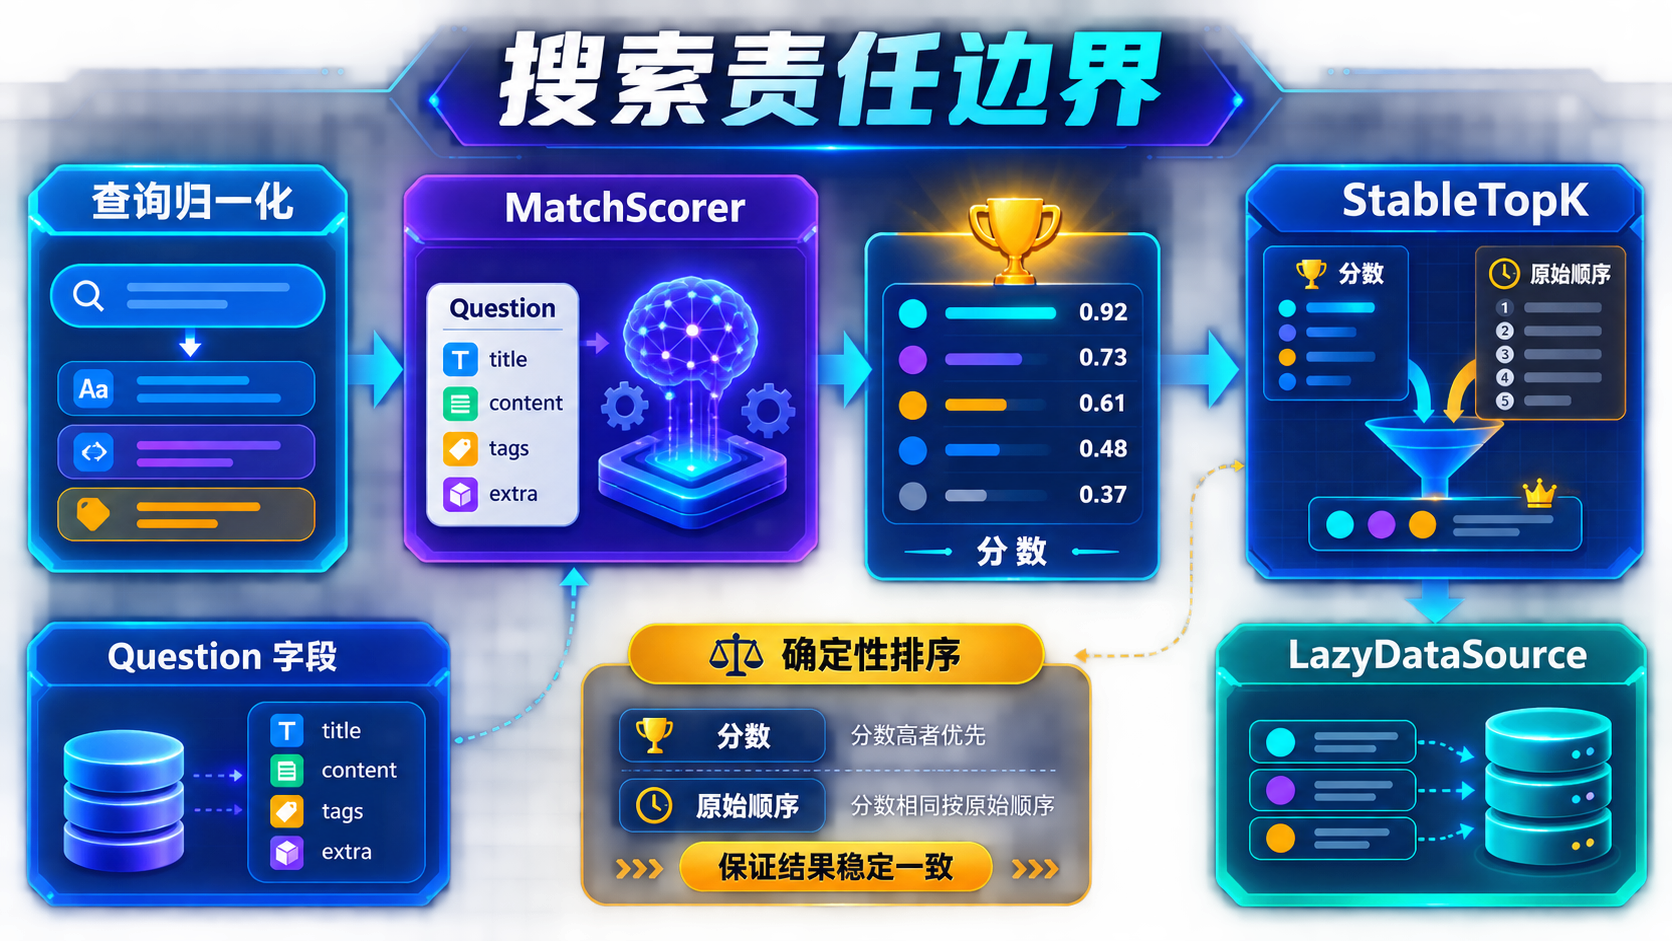
评分函数应是纯计算:输入一题和已经规范化的查询,返回总分及命中明细;不修改题目,也不直接更新页面列表。
function addFieldScore(
  target: FieldMatch[],
  field: FieldMatch['field'],
  rawText: string,
  query: string,
  base: number
): number {
  const strength = matchStrength(normalizeSearchText(rawText), query);
  if (strength === 0) {
    return 0;
  }
  const bonus = strength === 3 ? 30 : strength === 2 ? 15 : 0;
  target.push({
    field,
    strength: strength === 3 ? 'exact' : strength === 2 ? 'prefix' : 'contains',
    points: base + bonus
  });
  return base + bonus;
}

function scoreQuestion(question: QuestionItem, query: string): MatchScore {
  const matches: FieldMatch[] = [];
  let total = 0;
  total += addFieldScore(matches, 'title', question.title, query, FIELD_BASE.title);
  total += addFieldScore(matches, 'category', question.category, query, FIELD_BASE.category);
  total += addFieldScore(matches, 'explanation', question.explanation, query, FIELD_BASE.explanation);
  for (let index = 0; index < question.options.length; index++) {
    total += addFieldScore(matches, 'option', question.options[index].text, query, FIELD_BASE.option);
  }
  return { total, matches };
}
该实现允许一个关键词在多个字段累计。例如题干和解析都提到“近光灯”时,得分会高于只在干扰选项中出现的题。是否希望多选项重复累计,需要产品决定;若不希望,可把选项字段改成取最大值。关键不是选择哪一种,而是让规则写在一个地方,并用具体样例固定预期。
实际接入时,题干应先复用工程现有的题号前缀移除方法,避免“第12题”影响前缀判断。文章里的函数展示评分骨架,没有替代当前 stripQuestionTitlePrefix() 的意图。
五、候选集必须完整扫描后才能谈TopK
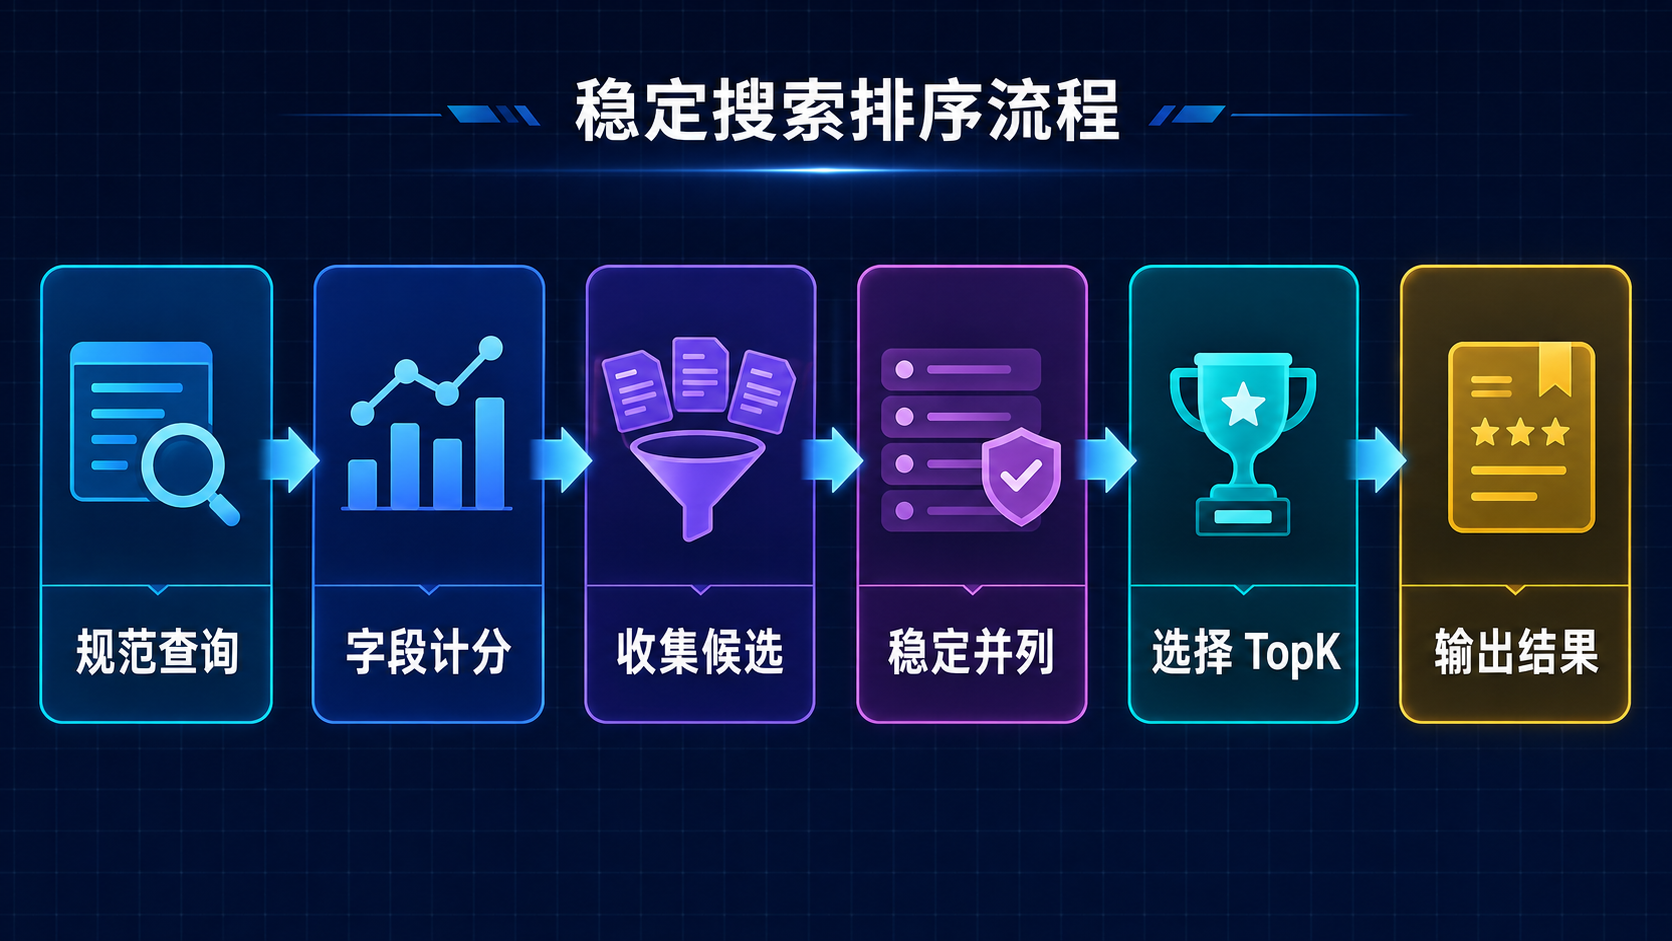
既然目标是最高分的40条,就必须让当前科目下所有候选先参与评分。扫描过程中只丢弃总分为0的题,不能在候选达到40时提前结束。
interface ScoredQuestion {
  question: QuestionItem;
  score: MatchScore;
  sourceOrder: number;
}

function collectScoredQuestions(
  source: QuestionItem[],
  subject: string,
  normalizedQuery: string
): ScoredQuestion[] {
  const candidates: ScoredQuestion[] = [];
  for (let index = 0; index < source.length; index++) {
    if (source[index].subject !== subject) {
      continue;
    }
    const question = normalizeQuestion(source[index]);
    const score = scoreQuestion(question, normalizedQuery);
    if (score.total > 0) {
      candidates.push({ question, score, sourceOrder: index });
    }
  }
  return candidates;
}
sourceOrder 在候选创建时冻结,之后即使数组被排序,也能作为并列规则使用。这里先规范化自动题再评分,与现有搜索保持一致;否则生成题的选项或解析可能仍处于未统一状态,字段得分口径会混乱。
完整扫描会比“满40即停”多看一些题,但当前题库规模仍适合先选择可读实现。若后续题量显著增长,可以为规范化文本建立只读索引,或者用固定容量堆维护TopK;任何优化都必须保持比较器与结果一致,不能以性能为由退回源顺序截断。
六、稳定并列需要明确第二、第三排序键
只有总分比较还不够。两道题同时在题干包含“近光灯”时,排序函数会返回0;不同运行时或数据准备顺序变化后,并列项可能交换位置。稳定结果需要把比较链写完整。
function compareScoredQuestion(left: ScoredQuestion, right: ScoredQuestion): number {
  if (left.score.total !== right.score.total) {
    return right.score.total - left.score.total;
  }
  if (left.sourceOrder !== right.sourceOrder) {
    return left.sourceOrder - right.sourceOrder;
  }
  if (left.question.id < right.question.id) {
    return -1;
  }
  if (left.question.id > right.question.id) {
    return 1;
  }
  return 0;
}

function stableTopK(candidates: ScoredQuestion[], limit: number): ScoredQuestion[] {
  const copied = candidates.slice();
  copied.sort(compareScoredQuestion);
  return copied.slice(0, Math.max(0, limit));
}
比较顺序是:总分降序、原始顺序升序、稳定 ID 升序。第二键保持现有题库的编辑顺序意图,第三键只在异常重复顺序时兜底。slice() 防止直接排序共享候选数组。若未来题目 ID 的生成规则会变化,就应选用真正稳定的业务身份,而不是显示标题。
对于 limit <= 0,示例返回空数组。上限来自内部常量时也应在调用边界核对,防止配置错误导致负截取或无限列表。
七、搜索协调器只向DataSource提交一次最终结果
评分、排序和截取结束后,再一次性更新 QuestionBankLazyDataSource。不要在扫描过程中不断 setQuestions(),否则监听者会收到多次重载,用户可能看到列表跳动。
private refreshRankedQuestionBank(): void {
  const query = normalizeSearchText(this.questionBankKeyword);
  if (query.length === 0) {
    this.questionBankDataSource.setQuestions([]);
    return;
  }

  const candidates = collectScoredQuestions(
    BUILTIN_QUESTIONS,
    this.questionBankSubject,
    query
  );
  const ranked = stableTopK(candidates, QUESTION_BANK_RESULT_LIMIT);
  const questions: QuestionItem[] = ranked.map((item) => item.question);
  this.questionBankDataSource.setQuestions(questions);
}
协调器仍保持当前“空关键词显示空列表”的产品行为,只替换非空查询的选择过程。若输入框每次按键都触发刷新,可以在页面层增加短延迟和请求序号,防止旧查询结果覆盖新查询;那属于交互调度,不应混入 MatchScorer。
八、缓存规范化字段时要绑定题库版本
每次搜索都对题干、解析、分类和全部选项调用小写与空白处理,题量大时会产生重复工作。可以在题库建立完成后生成 SearchDocument,但缓存必须绑定题目身份和题库版本,不能在题目更新后继续使用旧文本。
interface SearchDocument {
  questionId: string;
  title: string;
  category: string;
  explanation: string;
  options: string[];
  sourceOrder: number;
}

function buildSearchDocument(question: QuestionItem, sourceOrder: number): SearchDocument {
  return {
    questionId: question.id,
    title: normalizeSearchText(question.title),
    category: normalizeSearchText(question.category),
    explanation: normalizeSearchText(question.explanation),
    options: question.options.map((option) => normalizeSearchText(option.text)),
    sourceOrder
  };
}
缓存文档只为检索服务,不应成为新的题目真相来源。列表最终仍返回 QuestionItem,判题继续通过题目身份取得当前答案。若缓存中放入答案键或整份历史,应重新审视最小字段原则;搜索只需要可搜索文本和稳定定位信息。
九、固定查询集比随机点几次更能发现排序退化
验证排序需要一组可重复查询,覆盖题干、分类、解析、选项和大量并列。每次调整权重后保存前若干题 ID 与得分理由,对比变化是否符合预期。
| 编号 | 查询与数据准备 | 预期 |
|---|---|---|
| S58-01 | 题干精确为“近光灯” | 精确题干项位于普通包含项之前 |
| S58-02 | 只在分类命中“夜间场景” | 分类题进入结果,理由标明 category |
| S58-03 | 一题只在错误选项含关键词 | 得分低于题干包含项 |
| S58-04 | 50条候选,后10条题干命中 | 后出现的高分题仍可进入前40 |
| S58-05 | 多题总分相同 | 按 sourceOrder,再按 ID 稳定排列 |
| S58-06 | 题库数组原地重排 | 若编辑顺序被视为策略,结果变化有记录 |
| S58-07 | 空白与混合大小写输入 | 规范后得到一致结果 |
| S58-08 | 空字符串或全空格 | 返回空列表,不把所有题视为命中 |
| S58-09 | limit 为0 | 安全返回空数组 |
| S58-10 | 同一查询连续执行100次 | ID 顺序完全一致 |
还应核对上限外的第41项:它的得分不能高于第40项;若得分相同,比较器给出的次级顺序必须解释边界位置。只核对结果数量等于40,无法证明TopK选择正确。
十、验证清单、排障表与事实边界
- 当前科目下的全部候选都参与评分,未在收集满40条时提前退出。
- 题干、分类、解析和选项使用集中定义的字段权重。
- 精确、前缀和普通包含的强度规则有固定样例。
- 空查询在评分前返回,不产生全量命中。
- 自动题在评分前按现有规则规范化。
- 比较器包含总分、原始顺序和稳定 ID 三层规则。
- 排序操作不修改共享题库数组。
- 页面只向数据源提交一次最终列表。
- 固定查询集覆盖第40与第41名边界。
- 权重或题库版本变化时,缓存与预期结果同时更新。
| 症状 | 优先检查 | 常见原因 | 处理方向 |
|---|---|---|---|
| 题干含关键词却排不到前40 | 候选扫描是否完整 | 仍在满40条时 break | 先收全候选,再取TopK |
| 只在错误选项命中的题排太前 | 字段权重 | 所有字段同分 | 降低选项基数并固定样例 |
| 同分结果刷新后换位置 | 比较器次级键 | 只比较总分 | 增加原始顺序和稳定 ID |
| 输入空格后出现全部题 | 空查询分支 | 空串被 indexOf 命中 | 规范后先判断长度 |
| 搜索越用越慢 | 字段规范化次数 | 每次按键重复处理全部文本 | 建立绑定题库版本的只读文档 |
| 修改题目后仍搜到旧内容 | 缓存生命周期 | 文档未随题库重建 | 版本变化时整体替换索引 |
| 列表逐条闪动 | 数据源提交次数 | 扫描过程中持续刷新 | 形成最终数组后一次提交 |
当前源码能够确认:题库搜索上限为40,非空查询按 BUILTIN_QUESTIONS 顺序扫描,只要题干、解析、分类或选项包含关键词便加入结果,并在收集满40条时停止。本文没有取得某个关键词在设备上的排序投诉,也没有把源顺序直接称为运行缺陷。文中的 MatchScore、字段权重、完整候选收集、稳定比较器和搜索文档均为建议方案,尚未合入或写入 The_kemusan。本次未构建项目,没有生成新的 HAP,也没有在模拟器或真机上验证搜索响应、列表刷新与TopK顺序。实际接入后还需结合真实查询样本、目标 SDK 编译和设备性能复核权重与调度策略。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 5
 0
- 0


 已为社区贡献283条内容

所有评论(0)