【共创稿事节】HarmonyOS 7 应用故障智能诊断实战:APMS 故障总览 + Profiler 跨语言泄漏 + Operation Analyzer 冻屏分析
引言:从"人肉翻日志"到"AI 辅助定位"
V哥这么多年,最怕的不是写不出功能,而是功能上线后某台机型突然崩了、冻屏了、内存涨了,可日志里只有一堆看不懂的堆栈,复现还复现不出来。传统路径是:用户反馈 → 发版 → 猜 → 加日志 → 再发版 → 还是猜。一个崩溃查三天是常态,查完头发也白了。
HarmonyOS 7(API 26)在 DFX(Design For eXcellence,面向卓越的设计)上做了一件关键的事:把"故障诊断"从开发者的单打独斗,升级成"端云协同 + 聚类 + AI 辅助定位"的闭环。崩溃、冻屏、泄漏不再是黑盒,系统替你把现场抓回来、把同类问题聚好、甚至把根因建议直接给出来。这篇 V哥就带你把这套工具链走通:运维态用 APMS + 灰度采集看线上,开发态用 Profiler 抓跨语言泄漏,冻屏卡死交给 Operation Analyzer。
口径说明:本文涉及的故障类型、API 名称、性能数字均来自华为官方文档与开发者社区公开材料,具体接口与版本边界以官方最新文档为准;业务真实收益以真机实测为准。
一、HarmonyOS 7 把 DFX 做成了一条闭环
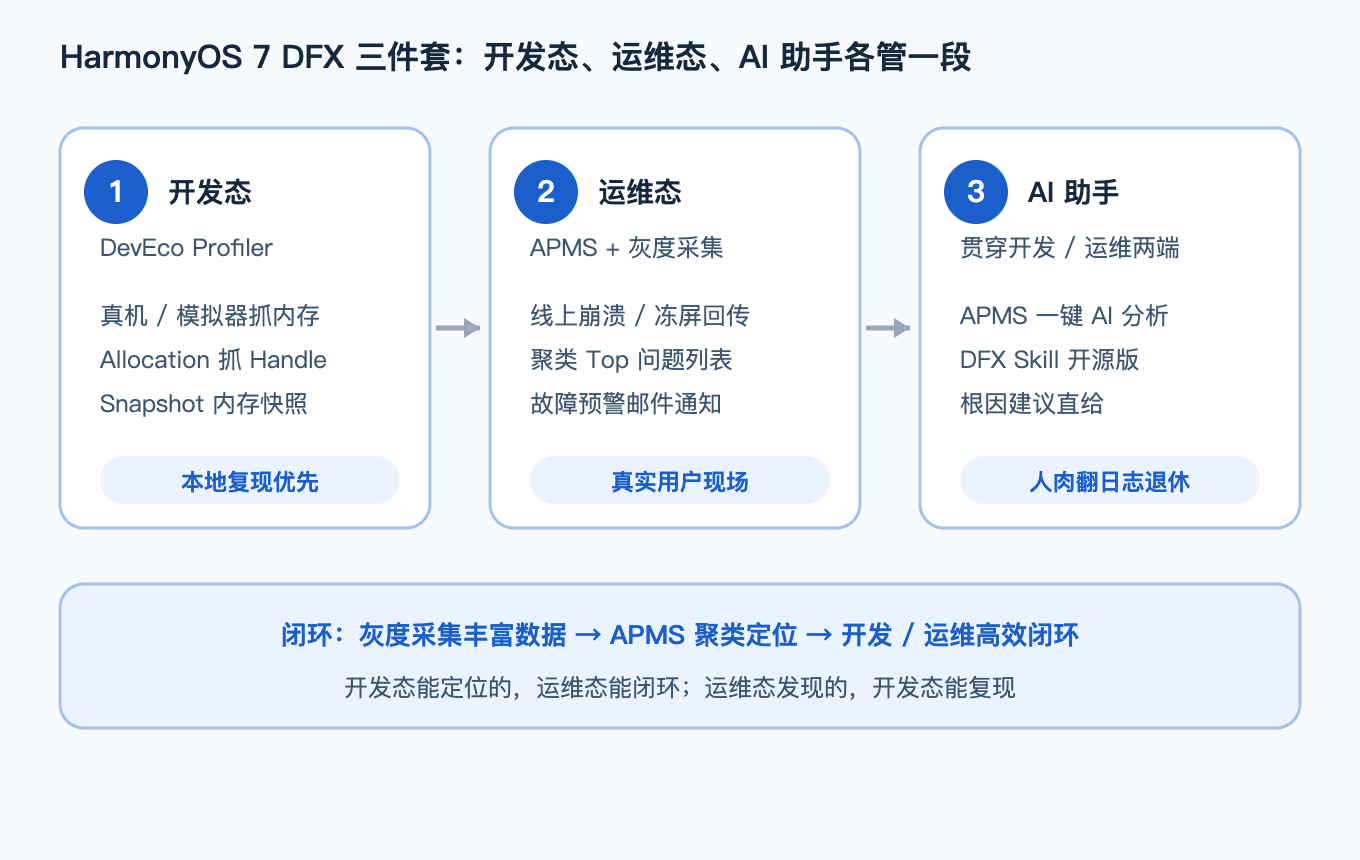
在 HarmonyOS 7(API 26)Beta2 里,DFX 的增强主线非常清晰:灰度采集丰富数据 → APMS 聚类定位 → 开发、运维问题高效闭环。它把"诊断"拆成了三个角色,各管一段:
- 开发态(你写代码时):DevEco Studio Profiler 系列工具,负责在真机/模拟器上把内存、CPU、帧率、跨语言引用一层层扒开。
- 运维态(应用上线后):AppGallery Connect 的 APMS(应用性能监测服务)+ 应用灰度采集,负责把线上真实用户的崩溃、冻屏、泄漏日志按需回传、聚类、出报告。
- AI 助手(贯穿两端):APMS 内置的 AI 智能分析,以及开源的 DFX Skill 模型,负责把"人肉翻日志"变成"点一下出根因"。
这条链路的精髓在于:开发态能定位的,运维态也能闭环;运维态发现的,开发态能复现。下面分三段拆解。
二、运维态:APMS + 灰度采集,让崩溃冻屏自己说话
线上问题的第一道坎是"没数据"。很多高价值日志(内存泄漏、卡死堆栈、GPU 异常)平时根本不上报,等用户投诉了才去现场抓,早就过了现场。
2.1 灰度采集(HiRetrieval):按需把现场抓回来
从 HarmonyOS 7(API 26)Beta2 起,DFX 开放了应用灰度采集接口。端侧集成后,你可以指定采集应用的 RSS、GPU、ArkTS、句柄等高负载日志,按策略回传到 APMS 平台分析。它采用的是端云协同架构:端侧集成能力 → 在 AGC 创建灰度任务(圈定设备范围、故障类型、采集时间)→ 设备命中异常时自动触发采集并回传。
覆盖的故障类型都是线上最容易"闷声出大事"的:
| 故障类型 | 含义 |
|---|---|
RSS_LEAK | RSS 内存泄漏 |
JS_LEAK | ArkTS OOM(ArkTS 对象泄漏) |
FD_LEAK | 文件描述符(FD)泄漏 |
GPU_LEAK | GPU 内存泄漏 |
注意:采集会带来一定性能与功耗影响,建议结合真实问题场景按需开启、合理配置策略,别一上来全量采集。
2.2 APMS 聚类分析:同类异常自动归并
日志量一大,人工看不过来。APMS 故障监测服务会基于堆栈关键行做同类异常汇聚——把具有相同根因和主泄漏方法的异常报告自动聚成一类,按发生占比排序,给你一张 Top 问题列表。以 RSS 内存泄漏为例,灰度采集的 trace 上报后,系统完成聚类,直接输出泄漏根因、可疑代码路径和修复建议。开发者要做的,是在 Top 列表里挑高优问题、标状态、下钻。
2.3 AI 智能分析:点一下,根因建议直给
这才是 HarmonyOS 7 最省命的地方。APMS 故障分析下,崩溃与冻屏的部分场景已经支持 AI 分析。比如 CPP_CRASH 类问题,在问题个例界面点"AI 分析",右侧会弹出会话窗口,以流式方式逐步输出分析结果,结构化地给出【故障基本信息】【根因分析】【三级根因定位】【证据链】【根本原因】【根因模块】【修复建议】。
和传统"规则+模式匹配"的日志分析不同,AI 辅助分析引用了鸿蒙系统故障知识库和业界通用知识库做推理,把开发者从繁重的日志筛选里解放出来,精力聚焦到"怎么修"。结果还有缓存机制,再次点开直接呈现。
2.4 故障预警:从"被动接投诉"到"主动发现"
APMS 故障预警支持配置监控时段、频率和触发条件。当应用触发泄漏或崩溃事件时,设备自动上报故障信息,系统发邮件到预警通知人。新版本上线后崩溃率异常抬升,你能在告警总览里第一时间看到,点进去直接跳到对应版本的指标详情——不用等用户骂完才发现。
三、开发态:Profiler 跨语言泄漏检测(Local Handle / Global Handle)
运维态告诉你"哪里漏了",开发态要回答"为什么漏、代码在哪"。在 ArkTS 与 C/C++ 混合架构里,NAPI 句柄管理是内存泄漏的高发灰色地带:应用跑着跑着就卡顿、OOM,反复查 ArkTS 代码却找不到泄漏,真正的元凶往往藏在 Native 侧对 JS 对象的"隐形强引用"里。
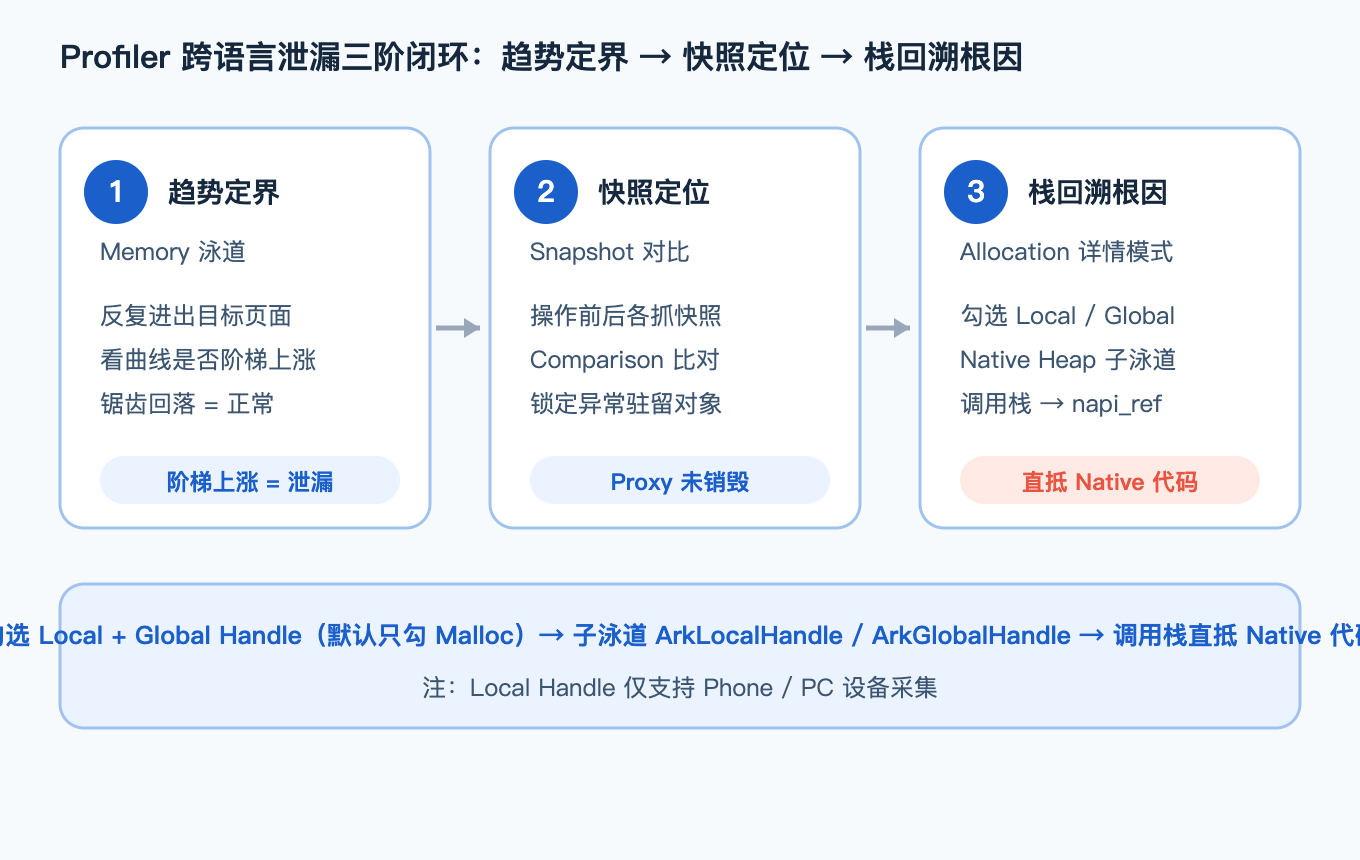
DevEco Studio Profiler 的 Allocation 工具在 HarmonyOS 7 把 NAPI 句柄生命周期完整透明化了,新增了 Local Handle / Global Handle 跨语言内存泄漏检测,打通 ArkTS 和 C++ 边界,配合 Native 分配堆栈回溯,实现"一栈到底"。
3.1 两类句柄,两种泄漏姿势
| 维度 | Local Handle(napi_value) | Global Handle(napi_ref) |
|---|---|---|
| 生命周期 | 由 Handle Scope(作用域)管控 | 手动创建/删除,引用计数管理 |
| 泄漏典型原因 | 作用域未正确关闭、libuv 异步调用未加 napi_open_handle_scope/napi_close_handle_scope | 强引用创建后忘记 napi_delete_reference |
| 采集标签 | RES_ARK_LOCAL_HANDLE | RES_ARK_GLOBAL_HANDLE |
| IDE 泳道 | Native Heap 子泳道 ArkLocalHandle | Native Heap 子泳道 ArkGlobalHandle |
简单说:Local Handle 是"作用域没管好",常见于 libuv 异步回调里系统不会自动加 Handle Scope;Global Handle 是"引用忘了删",napi_ref 一旦创建不 napi_delete_reference,对象就永久驻留、内存只增不减。后者是异步回调、事件监听、跨线程通信的必备机制,也是泄漏重灾区。
一个小限制:Local Handle 仅支持 Phone 和 PC 设备采集,用平板或 2in1 的设备注意这一点。
3.2 工具怎么用:三阶闭环
- 趋势定界:在 Profiler 的 Memory / Realtime Monitor 泳道,重复进出目标页面,看内存曲线是不是"阶梯状上升"——正常应该锯齿状回落,阶梯状就是泄漏信号。
- 快照定位:切到 Snapshot 模板,操作前后各抓一份堆快照,用 Comparison 对比,锁定异常驻留的 ArkTS 对象(比如某个
Proxy实例数量异常增长)。 - 栈回溯根因:在 Allocation 模板选"详情模式",务必勾选 Local Handle 和 Global Handle(默认只勾 Malloc),展开 Native Heap 子泳道看
ArkLocalHandle/ArkGlobalHandle。选中泄漏对象,在 Native List 标签里能看到句柄类型(调用栈底层符号是ArkGlobalHandle还是ArkLocalHandle)和完整分配调用栈,直接定位到创建napi_ref的 Native 代码。
不想开 IDE 也能采:命令行 hiprofiler_cmd 通过 restrace_tag 参数指定 RES_ARK_LOCAL_HANDLE 或 RES_ARK_GLOBAL_HANDLE,适合脚本化、长时间采集。
四、冻屏卡死:Operation Analyzer + AppFreeze 增强日志
冻屏比崩溃更隐蔽——它不报错,就是"卡住不动",崩溃平台往往没有堆栈上报,开发者只能靠用户描述和截图猜。
4.1 运维态冻屏标准化流程
APMS 把冻屏排查也标准化成了四步走:
- 故障预警:在 APMS 配置应用冻屏监控告警规则(监控时段、频率、触发条件)。
- 问题查看与聚类:在故障指标、故障分析页筛选冻屏类型,看冻屏趋势、Top 问题列表与 Top 耗时函数。
- 根因定位与分析:看故障模块、发生次数(占比)、影响设备数(占比),下钻问题详情,借助 AI 分析、证据链、现场数据、采样栈数据 深入分析。
- 修复建议验证与闭环:按修复建议改代码、验证效果,在 APMS 标记闭环。
几个关键指标要盯紧:故障模块(发生冻屏的模块/组件,定位范围)、发生次数占比(严重程度)、影响设备数占比(影响面)、Top 耗时函数(高发函数优先改)。
4.2 AppFreeze 增强日志 + GWP-ASan:把卡死和踩内存看穿
- AppFreeze 增强日志:当主线程卡死时,系统会每 300ms 采样一次主线程调用栈,把"卡在哪一行"直接采出来,不用再靠猜。
- GWP-ASan:针对"踩内存"(内存越界)这类最难定位的问题,采样率低于 5% 即可启用,无需插桩,就能捕获越界现场、引导你拿到第一现场证据(配合 HWASan 进一步深挖)。
五、接入三步走:把 DFX 用进你的项目
讲了这么多,落到工程上其实就三步:
第一步,开发态先自查。 在 DevEco Studio 里把 Allocation(勾选 Local/Global Handle)+ Snapshot 跑起来,把反复进出页面、反复操作的高频路径过一遍,内存曲线稳不稳、有没有阶梯增长,上线前就排掉大部分泄漏。
第二步,运维态开通 APMS + 灰度采集。 在 AppGallery Connect 开通 APMS,配置故障告警规则;对线上难复现的泄漏/冻屏,创建灰度采集任务,圈定机型、开启对应故障类型,让系统自动抓现场回传。记得上传符号表(SourceMap、debug SO、namecache 等),反混淆后的调用栈才是能读的。
第三步,让 AI 替你下钻。 APMS 问题个例里直接点"AI 分析"拿根因建议;或者从 GitCode 拉取开源的 OpenHarmony-SIG/developtools_dfx_skills(DFX Skill),在 DevEco Code 里直接调用内置 Skill,或部署到内部环境让数据留在自己的服务器。目前已支持 ArkTS 对象泄漏、Native 内存泄漏、DMA(ION)泄漏、Freeze 卡死等场景的自动化分析。
此外,应用内也可以通过 HiAppEvent 订阅应用事件(崩溃、卡死、崩溃信号等),在端侧把关键现场事件主动记录,作为 APMS 之外的一层补充。
六、一句话判断:什么时候用哪个
- 线上用户反馈"崩了/冻了/卡了",复现不了 → APMS 告警 + 灰度采集,把现场抓回来。
- Memory 曲线阶梯上涨、怀疑 Native 持有 JS 对象 → Profiler Allocation 勾 Local/Global Handle,栈回溯到
napi_ref创建点。 - 主线程卡死、没堆栈 → AppFreeze 增强日志(300ms 采样)+ Operation Analyzer 冻屏聚类。
- 怀疑内存越界踩踏 → GWP-ASan(采样 <5%,免插桩)。
- 想省时间、不想自己翻日志 → APMS 一键 AI 分析 / DFX Skill 开源版。
DFX 不是上线后才想起的"救火队",而是从开发态到运维态一整条质量防线。HarmonyOS 7 把这防线做成了闭环,V哥的建议是:开发期把 Profiler 跑成习惯,上线后把 APMS 和灰度采集开起来,真出问题了,让 AI 先替你翻一遍。
参考与出处
以下为本文涉及的官方文档与开发者社区公开材料,API 名称、故障类型与流程口径均以此为据;具体接口参数与版本边界以官方最新文档为准。
- 华为开发者联盟 · 应用灰度采集介绍:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/hiretrieval-intro
- 华为开发者联盟 · 应用质量管理(APMS)指南:https://developer.huawei.com/consumer/cn/doc/app/agc-help-apms-0000002235870062
- 华为开发者联盟 · 开发态快速定位 ArkTS 泄漏(Local/Global Handle):https://developer.huawei.com/consumer/cn/doc/best-practices/bpta-arkts-leak-in-develop
- GitCode · OpenHarmony-SIG/developtools_dfx_skills(DFX Skill 开源版):https://gitcode.com/openharmony-sig/developtools_dfx_skills
- 华为开发者联盟 · 运维态高效处理应用冻屏(InfoQ 转载):https://www.infoq.cn/article/PfFUE5z2avSdyLfYXjEX
- 华为开发者联盟 · HarmonyOS 新能力一览:https://developer.huawei.com/consumer/cn/features/
最后一句:真正的稳定性,不靠上线后通宵救火,而靠开发态 Profiler 跑成习惯、运维态 APMS 开成标配、出问题让 AI 先翻一遍——把质量防线建在崩溃之前,才是 HarmonyOS 7 这套 DFX 闭环想替你省下的那三天。

讨论HarmonyOS开发技术,专注于API与组件、DevEco Studio、测试、元服务和应用上架分发等。
更多推荐
 1
 0
- 0


 已为社区贡献119条内容

所有评论(0)